第6章 集合
Collection 体系与 Map 体系:List 有序、Set 不重复、Map 键值对,配合泛型与迭代器。
本章学习目标
- 能区分 List、Set、Map 的特点与适用场景
- 会使用 ArrayList、LinkedList、HashSet、HashMap
- 能用 Iterator 与增强 for 遍历集合
- 会使用泛型约束集合元素类型
本章导览
核心内容
目录
JDK 8——聚合操作
目录
在开发中,多数情况下会涉及到对集合、数组中元素的操作,在JDK 8之前都是通过普通的循环遍历出每一个元素,然后还会穿插一些if条件语句选择性的对元素进行查找、过滤、修改等操作,这种原始的操作方法虽然可行,但是代码量较大并且执行效率较低。
为此,JDK 8中新增了聚合操作,可以进一步简化集合、数组中元素的查找、过滤、转换等。
为什么要引入聚合操作?
定义:JDK 8中新增了一个Stream接口,该接口可以将集合、数组的中的元素转换为Stream流的形式,并结合Lambda表达式的优势来进一步简化集合、数组中元素的查找、过滤、转换等操作,这一新功能就是JDK 8中的聚合操作。
操作步骤:
将原始集合或者数组对象转换为Stream流对象;
对Stream流对象中的元素进行一系列的过滤、查找等中间操作,然后返回一个Stream流对象;
对Stream流进行遍历、统计、收集等终结操作,获取想要的结果。
// 通过链式表达式的形式完成聚合操作list.stream().filter(i -> i.startsWith("张"))
.limit(2)
.forEach(j -> System.out.println(j));调用stream()方法将List集合转为Stream流对象
分别对stream流元素执行过滤filter()和截取limit()中间操作
最后对stream流元素执行终结forEach()操作,遍历元素
使用示例:
小提示
注
使用聚合操作时,涉及到两个名词Intermediate Operations(中间操作)和Terminal Operation(终结操作),官方并没有对这两个概念进行详细说明,只是为了便于区分和管理聚合操作步骤中的方法,将这些方法根据返回类型进行了区分:
将执行某个方法后返回类型仍为Stream流对象的方法归类为中间操作,如过滤、截取、排序等方法;
而将执行方法后返回类型不再是Stream流对象的方法归类为终结操作,如遍历、统计、收集等方法。
需要注意的是,在进行聚合操作时,只是改变了Stream流对象中的数据,并不会改变原始集合或数组中的源数据。
init(FilterConfig filterConfig)
1
所有的Collections集合都可以使用stream()静态方法获取Stream流对象;
2
Stream接口的of()静态方法可以获取基本类型包装类数组、引用类型数组和单个元素的Stream流对象;
3
Arrays工具类的stream()静态方法也可以获取数组元素的Stream流对象。
在JDK 8中,只针对单列集合Collections接口对象提供了stream()静态方法获取Stream流对象,并未对Map集合提供相关方法获取Stream流对象,所以想要用Map集合创建Stream流对象必须先通过Map集合的keySet()、values()、entrySet()等方法将Map集合转换为单列Set集合,然后再使用单列集合的stream()静态方法获取对应键、值集合的Stream流对象。
| 方法声明 | 功能描述 |
|---|---|
| Stream<T> filter(Predicate<? super T> predicate) | 将指定流对象中的元素进行过滤,并返回一个子流对象 |
| Stream<R> map(Function<? super T, ? extends R> mapper) | 将流中的元素按规则映射到另一个流中 |
| Stream<T> distinct() | 删除流中重复的元素 |
| Stream<T> sorted() | 将流中的元素按自然顺序排序 |
| Stream<T> limit(long maxSize) | 截取流中元素的长度 |
| Stream<T> skip(long n) | 丢弃流中前n个元素 |
| static <T> Stream<T> concat(Stream<? extends T> a, Stream<? extends T> b) | 将两个流对象合并为一个流 |
| long count() | 统计流中元素的个数 |
| R collect(Collector<? super T, A, R> collector) | 将流中的元素收集到一个容器中(如集合) |
| Object[] toArray() | 将流中的元素收集到一个数组中 |
| void forEach(Consumer<? super T> action) | 将流中的元素进行遍历 |
遍历
void forEach(Consumer<? super T> action);
stream.forEach(i -> System.out.println(i)); // 遍历并打印流元素
介绍:遍历forEach()方法名称虽然与for循环中的“foreach()”相同,但是该方法是JDK 8新增的Stream接口中用于遍历流元素,并且该方法不保证元素的遍历过程在流中是被有序执行的。
语法格式:
过滤
Stream<T> filter(Predicate<? super T> predicate);
stream.filter(i -> i.startsWith(“张”)); // 筛选出以“张”开头的流元素介绍:使用过滤filter()方法可以将一个Stream流中的元素进行筛选转换成另一个子集流。
映射
<R> Stream<R> map(Function<? super T, ? extends R> mapper);
stream.map(String::toUpperCase) // 将所有流元素字母转换为大写
介绍:Stream流对象的map()方法可以将流对象中的元素通过特定的规则进行修改然后映射为另一个流对象。
截取
stream.skip(1) // 跳过流中的前1个元素
.limit(2) // 截取剩余流中的前2个元素
介绍:Stream流对象的limit()方法用于对流对象中的元素进行截取操作,该方法只需要一个参数,并且截取的是流中的前n个元素。在多数情况下,limit()方法会与skip()方法(跳过方法)组合使用,用于截取流对象中指定位置的多个元素
收集
<R, A> R collect(Collector<? super T, A, R> collector);
介绍:collect(收集)是一种是十分有用的终结操作,它可以把Stream中的元素保存为另外一种形式,比如集合、字符串等。
Collector参数包含4种操作:supplier(初始构造器)、accumulator(累加器)、combiner(组合器)、finisher(终结者)。 在JDK 8中的java.util.stream包下的Collectors类内置了各种复杂的收集操作。
就是将源数据转换为一个流对象,然后在单线程下执行聚合操作的流(也就是单一管道流)。
串行流
(Serial Stream)
就是将源数据分为多个子流对象进行多线程操作(也就是多个管道流),然后将处理的结果再汇总为一个流对象。
并行流
(Parallel Stream)
VS
原理:Stream并行流底层会将源数据拆解为多个流对象在多个线程中并行执行,这依赖于JDK 7中新增的fork/join框架,该框架解决了应用程序并行计算的能力,但是单独使用这个框架,必须指定源数据如何进行详细拆分,而JDK 8中的聚合操作,在fork/join框架的基础上进行组合解决了这一麻烦。
注意:使用Stream并行流在一定程度上可以提升程序的执行效率,但是在多线程执行就会出现线程安全这个大问题,所以为了能够在聚合操作中使用Stream并行流,前提是要执行操作的源数据在并行执行过程中不会被修改。
通过Collection集合接口的parallelStream()方法直接将集合类型的源数据转变为Stream并行流;
通过BaseStream接口的parallel()方法将Stream串行流转变为Stream并行流。
说明:创建Stream流对象时,除非有特别声明,否则默认创建的都是串行流。
创建方式:
说明:BaseStream接口中还提供了一个isParallel()方法,用于判断当前Stream流对象是否为并行流,方法返回值为boolean类型。
示例:
// 方法一
Stream<String> parallelStream = list.parallelStream();
System.out.println(parallelStream.isParallel());
// 方法二
Stream<String> parallel = stream.parallel();
System.out.println(parallel.isParallel());
📄 展开课件原文(第 5–82 页,共 18 页)
集合概述
为什么要学习集合?
数组可以保存多个对象,但在无法确定需要保存多少个对象时,数组将不再适用,因为数组的长度不可变。
例如,要保存一个学校的学生信息,由于不停有新生来报道,同时也有学员毕业离开学校,这时学生的数目无法固定,并且随时可能变动。
为了保存这些数目不确定的对象,Java中提供了集合,集合可以存储任意类型的对象,并且长度可变。
定义:Java中的集合就像一个容器,专门用来存储Java对象。
说明:集合对象可以是任意的数据类型,并且长度可变。
注意:这些集合类都位于java.util包中,在使用时一定要注意导包的问题。
单列集合Collection
双列集合Map
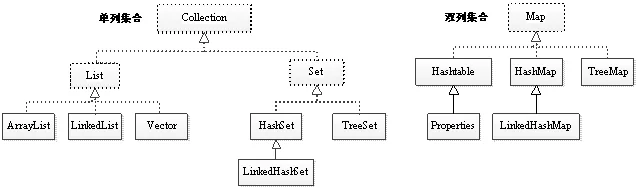
单列集合根接口,用于存储一系列符合某种规则的元素。
Collection集合有两个重要的子接口,分别是List和Set。
List集合的特点是元素有序、可重复。该接口的主要实现类有ArrayList和LinkedList。
Set集合的特点是元素无序并且不可重复。该接口的主要实现类有HashSet和TreeSet。
双列集合根接口,用于存储具有键(Key)、值(Value)映射关系的元素。
Map集合中每个元素都包含一对键值,并且Key唯一,在使用Map集合时通过指定的Key找到对应的Value。
Map接口的主要实现类有HashMap和TreeMap。
注意:虚线框里填写的都是接口类型,实线框里填写的都是具体的实现类。
📄 展开课件原文(第 12–15 页,共 4 页)
Collection接口
| 方法声明 | 功能描述 |
|---|---|
| boolean add(Object o) | 向集合中添加一个元素 |
| boolean addAll(Collection c) | 将指定集合c中的所有元素添加到该集合中 |
| void clear() | 删除该集合中的所有元素 |
| boolean remove(Object o) | 删除该集合中指定的元素 |
| boolean removeAll(Collection c) | 删除该集合中包含指定集合c中的所有元素 |
| boolean isEmpty() | 判断该集合是否为空 |
| boolean contains(Object o) | 判断该集合中是否包含某个元素 |
| boolean containsAll(Collection c) | 判断该集合中是否包含指定集合c中的所有元素 |
| Iterator iterator() | 返回在该集合的元素上进行迭代的迭代器(Iterator),用于遍历该集合所有元素 |
| int size() | 获取该集合元素个数 |
| Stream<E> stream() | 将集合源转换为有序元素的流对象(JDK 8新方法) |
📄 展开课件原文(第 16–16 页,共 1 页)
List接口
定义:List接口继承自Collection接口,是单列集合的一个重要分支,习惯性的会将实现了List接口的对象称为List集合。
特点:
List集合中允许出现重复元素,所有的元素是以一种线性方式进行存储的,在程序中可以通过索引(类似于数组中的元素角标)来访问集合中的元素。
List集合还有一个特点就是元素有序,即元素的存入顺序和取出顺序一致。
| 方法声明 | 功能描述 |
|---|---|
| void add(int index,Object element) | 将元素element插入在List集合的指定索引位置 |
| boolean addAll(int index,Collection c) | 将集合c包含的所有元素插入到List集合的指定索引位置 |
| Object get(int index) | 返回集合索引index处的元素 |
| Object remove(int index) | 删除index索引处的元素 |
| Object set(int index, Object element) | 将索引index处元素替换成element元素,并将替换后的元素返回 |
| int indexOf(Object o) | 返回对象o在List集合中首次出现的位置索引 |
| int lastIndexOf(Object o) | 返回对象o在List集合中最后一次出现的位置索引 |
| List subList(int fromIndex, int toIndex) | 返回从索引fromIndex(包括)到 toIndex(不包括)处所有元素集合组成的子集合 |
| Object[] toArray() | 将集合元素转换为数组 |
| default void sort(Comparator<? super E> c) | 根据指定的比较器规则对集合元素排序(JDK 8新方法) |
说明:
ArrayList是List接口的一个实现类,它是程序中最常见的一种集合。
ArrayList内部的数据存储结构是数组形式。
由于ArrayList的存储结构,在增加或删除指定位置的元素时,会创建新的数组,效率比较低,因此不适合做大量的增删操作。
这种数组结构允许程序通过索引的方式来访问元素,使用ArrayList集合在遍历和查找元素时显得非常高效。
示例:
ArrayList创建
ArrayList元素操作
ArrayList list = new ArrayList();
list.add("stu1");
list.add("stu2");
System.out.println("集合的长度:" + list.size());
System.out.println("第2个元素是:" + list.get(1));
LinkedList是List接口的另一个实现类。
LinkedList内部包含有两个Node类型的first和last属性的双向循环链表结构。
由于LinkedList的存储结构, LinkedList集合对于元素的遍历和查找效率较低。
LinkedList集合对于元素的增删操作表现出很高的效率。
左图为新增元素,图中的元素1和元素2在集合中彼此为前后关系,在它们之间新增一个元素时,只需要让元素1记住它后面的元素是新元素,让元素2记住它前面的元素为新元素就可以了。
右图为删除元素,要想删除元素1和元素2之间的元素3,只需要让元素1与元素2变成前后关系就可以了。
| 方法声明 | 功能描述 |
|---|---|
| void add(int index, E element) | 在此列表中指定的位置插入指定的元素。 |
| void addFirst(Object o) | 将指定元素插入集合的开头 |
| void addLast(Object o) | 将指定元素添加到集合的结尾 |
| Object getFirst() | 返回集合的第一个元素 |
| Object getLast() | 返回集合的最后一个元素 |
| Object removeFirst() | 移除并返回集合的第一个元素 |
| Object removeLast() | 移除并返回集合的最后一个元素 |
| boolean offer(Object o) | 将指定元素添加到集合的结尾 |
| boolean offerFirst(Object o) | 将指定元素添加到集合的开头 |
| boolean offerLast(Object o) | 将指定元素添加到集合的结尾 |
| 方法声明 | 功能描述 |
|---|---|
| Object peek() | 获取集合的第一个元素 |
| Object peekFirst() | 获取集合的第一个元素 |
| Object peekLast() | 获取集合的最后一个元素 |
| Object poll() | 移除并返回集合的第一个元素 |
| Object pollFirst() | 移除并返回集合的第一个元素 |
| Object pollLast() | 移除并返回集合的最后一个元素 |
| void push(Object o) | 将指定元素添加到集合的开头 |
| Object pop() | 移除并返回集合的第一个元素 |
操作:
LinkedList创建
LinkedList元素操作
LinkedList link = new LinkedList();
link.add("stu1");
link.add("stu2");
link.offer("offer"); // 向集合尾部追加元素
link.push("push"); // 向集合头部添加元素
Object object = link.peek(); //获取集合第一个元素
link.removeFirst(); // 删除集合第一个元素
link.pollLast(); // 删除集合最后一个元素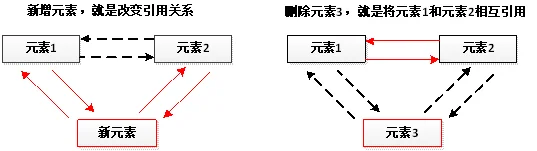
📄 展开课件原文(第 17–25 页,共 9 页)
Collection集合遍历
定义:Iterator接口是Java集合框架中的一员,主要用于迭代访问(即遍历)Collection中的元素,因此Iterator对象也被称为迭代器。
示例:
Iterator iterator = list.iterator();
while (iterator.hasNext()) {
Object obj = iterator.next(); // 取出ArrayList集合中的元素
System.out.println(obj);
}
Iterator遍历集合时,内部采用指针的方式来跟踪集合中的元素。在调用next()方法之前,索引位于第一个元素之前,不指向任何元素。
第一次调用next()方法后,索引会向后移动一位,指向第一个元素并将该元素返回;
再次调用next()方法时,索引会指向第二个元素并将该元素返回;
以此类推,直到hasNext()方法返回false,表示到达了集合的末尾终止对元素的遍历。
定义:foreach循环是一种更加简洁的for循环,也称增强for循环,用于遍历数组或集合中的元素。
语法: 示例:
for(容器中元素类型 临时变量 :容器变量) {
// 执行语句
for (Object obj : list) {
脚
下
留
心
foreach循环遍历集合和数组时,只能访问集合中的元素,不能对其中的元素进行修改。
Iterator迭代器对集合中的元素进行迭代时,如果调用了集合对象的remove()方法删除元素,会出现ConcurrentModificationException异常。
定义: forEach(Consumer action)方法是JDK 8中新增的遍历集合元素的方法,根据Lambda表达式特性,该方法所需要的参数是一个函数式接口。
list.forEach(obj -> System.out.println("迭代集合元素:"+obj));说明: JDK 8中还针对Iterator迭代器对象提供了一个forEachRemaining(Consumer action)方法来进行遍历,该方法同样需要一个函数式接口。
Iterator it = list.iterator();
it.forEachRemaining(obj -> System.out.println("迭代集合元素:"+obj));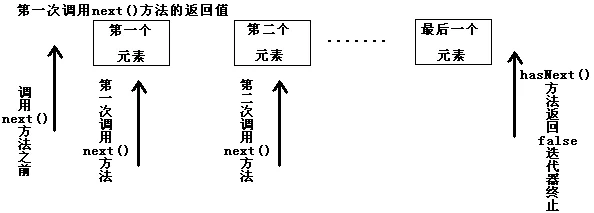
📄 展开课件原文(第 26–31 页,共 6 页)
Set接口
说明:Set接口和List接口一样,同样继承自Collection接口。
特点:Set接口中的元素无序,并且都会以某种规则保证存入的元素不出现重复。
实体内容
HashSet
Set接口
主要实现类
TreeSet
根据对象的哈希值来确定元素在集合中的存储的位置,因此具有良好的存取和查找性能
以二叉树的方式来存储元素,它可以实现对集合中的元素进行排序
说明:HashSet是Set接口的一个实现类,它所存储的元素不可重复,并且无序。
特点:当向HashSet集合中添加一个元素时,首先会调用该元素的hashCode()方法来确定元素的存储位置,然后再调用元素对象的equals()方法来确保该位置没有重复元素。
HashSet set = new HashSet();
set.add("Jack");
set.add("Eve");
...
set.forEach(o -> System.out.println(o));调用add()方法向HashSet集合存入元素
调用对象的hashCode()方法获得对象的哈希值
根据对象的哈希值计算出一个存储位置
舍弃该对象
该位置是否有对象存在
调用equals()方法比较对象是否相等
否
是
【结论】
当向集合中存入元素时,为了保证HasheSet正常工作,要求在存入对象时,需要重写Object类中的hashCode()和equals()方法。
在Java中,一些基本数据包装类、String类等都已经默认重写了hashCode()和equals()方法。
开发者向HashSet集合中添加自定义的数据类型,如Student类时,必须增加重写的hashCode()和equals()方法,才能保证数据的唯一性。
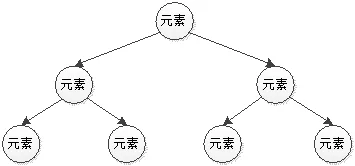
说明: TreeSet是Set接口的另一个实现类,它内部采用平衡二叉树来存储元素,来保证TreeSet集合中没有重复的元素,并且可以对元素进行排序。
定义:二叉树就是每个节点最多有两个子节点的有序树,每个节点及其子节点组成的树称为子树,左侧的节点称为“左子树”,右侧的节点称为“右子树”,其中左子树上的元素小于它的根结点,而右子树上的元素大于它的根结点。
【结构说明】
同一层的元素可分为1个根节点元素和2个子节点元素,左边的元素总是小于右边的元素。
【存储原理】
TreeSet集合没有元素时,新增的第1个元素会在二叉树最顶层;
接着新增元素时,首先会与根节点元素比较;
如果小于根节点元素就与左边的分支比较;
如果大于根节点元素就与右边的分支比较;
以此类推。
【存储过程】
将元素13个放在二叉树的最顶端;
之后存入的元素与13比较,如果小于13就将该元素放左子树上,如果大于13,就将该元素放在右子树上;
当二叉树中已经存入一个17的元素时,再向集合中存入一个为17的元素时,TreeSet会将重复的元素去掉。
添加元素: 向TreeSet中依次添加13、8、17、17、1、11、15、25元素
| 方法声明 | 功能描述 |
|---|---|
| Object first() | 返回TreeSet集合的首个元素 |
| Object last() | 返回TreeSet集合的最后一个元素 |
| Object lower(Object o) | 返回TreeSet集合中小于给定元素的最大元素,如果没有返回null |
| Object floor(Object o) | 返回TreeSet集合中小于或等于给定元素的最大元素,如果没有返回null |
| Object higher(Object o) | 返回TreeSet集合中大于给定元素的最小元素,如果没有返回null |
| Object ceiling(Object o) | 返回TreeSet集合中大于或等于给定元素的最小元素,如果没有返回null |
| Object pollFirst() | 移除并返回集合的第一个元素 |
| Object pollLast() | 移除并返回集合的最后一个元素 |
向TreeSet集合添加元素时,都会调用compareTo()方法进行比较排序,该方法是Comparable接口中定义的,因此要想对集合中的元素进行排序,就必须实现Comparable接口。
Java中大部分的类都实现了Comparable接口,并默认实现了接口中的CompareTo()方法,如Integer、Double和String等。
向TreeSet集合添加元素时,是怎样保证排序的?
2、定制排序
要求自定义一个比较器,该比较器必须实现Comparator接口,并重写compare()方法,然后将该比较器作为参数传入集合的有参构造。
1、自然排序
要求存储的元素类必须实现Comparable接口,并重写compareTo()方法。
适合元素类本身未实现Comparable接口,无法进行比较。
适合元素类实现的Comparable接口排序规则无法满足用户需求。
会额外定义一个实现Comparator接口的比较器。
元素类本身实现Comparable接口。
依赖compareTo()方法的实现
实现Comparable接口排序规则比较单一,不利于后续改进。
📄 展开课件原文(第 32–42 页,共 11 页)
Map接口
说明:Map接口是一种双列集合,它的每个元素都包含一个键对象Key和值对象Value,键和值对象之间存在一种对应关系,称为映射。
特点:Map中的映射关系是一对一的,一个键对象Key对应唯一一个值对象Value,其中键对象Key和值对象Value可以是任意数据类型,并且键对象Key不允许重复,这样在访问Map集合中的元素时,只要指定了Key,就能找到对应的Value。
| 方法声明 | 功能描述 |
|---|---|
| void put(Object key, Object value) | 向Map集合中添加指定键值映射的元素 |
| int size() | 返回Map集合键值对映射的个数 |
| Object get(Object key) | 返回指定键所映射的值,如果此映射不包含该键的映射关系,则返回null |
| boolean containsKey(Object key) | 查看Map集合中是否存在指定的键对象key |
| boolean containsValue(Object value) | 查看Map集合中是否存在指定的值对象value |
| Object remove(Object key) | 删除并返回Map集合中指定键对象Key的键值映射元素 |
| void clear() | 清空整个Map集合中的键值映射元素 |
| Set keySet() | 以Set集合的形式返回Map集合中所有的键对象Key |
| 方法声明 | 功能描述 |
|---|---|
| Collection values() | 以Collection集合的形式返回Map集合中所有的值对象Value |
| Set<Map.Entry<Key,Value>> entrySet() | 将Map集合转换为存储元素类型为Map的Set集合 |
| Object getOrDefault(Object key, Object defaultValue) | 返回Map集合指定键所映射的值,如果不存在则返回默认值defaultValue(JDK 8新方法) |
| void forEach(BiConsumer action) | 通过传入一个函数式接口对Map集合元素进行遍历(JDK 8新方法) |
| Object putIfAbsent(Object key, Object value) | 向Map集合中添加指定键值映射的元素,如果集合中已存在该键值映射元素,则不再添加而是返回已存在的值对象Value(JDK 8新方法) |
| boolean remove(Object key, Object value) | 删除Map集合中键值映射同时匹配的元素(JDK 8新方法) |
| boolean replace(Object key, Object value) | 将Map集合中指定键对象Key所映射的值修改为value(JDK 8新方法) |
说明:HashMap集合是Map接口的一个实现类,它用于存储键值映射关系,该集合的键和值允许为空,但键不能重复,且集合中的元素是无序的。
特点:HashMap底层是由哈希表结构组成的,其实就是“数组+链表”的组合体,数组是HashMap的主体结构,链表则主要是为了解决哈希值冲突而存在的分支结构。正因为这样特殊的存储结构,HashMap集合对于元素的增、删、改、查操作表现出的效率都比较高。
在哈希表结构中,主体结构为图中水平方向的数组结构,其长度称为HashMap集合的容量(capacity);
数组结构垂直对应的是链表结构,链表结构称为一个桶(bucket),每个桶的位置在集合中都有对应的桶值,用于快速定位集合元素添加、查找时的位置。
调用键对象k的hash(k)方法,快速定位并寻址到该元素在集合中要存储的位置
1、键对象k的hash值所在桶位置为空,则可以直接向该桶位置插入元素对象
2、键对象k的hash值所对应的桶位置不为空,接着通过键对象k的equals(k)方法比较是否有重复k值存在
有重复键对象k存在,将对原有节点元素值oldValue进行替换并返回
添加元素
oldValue
newValue
没有重复键对象k存在,在该桶顶部位置以链表结构新增一个节点,并插入元素对象
小提示
使用HashMap集合时,如果通过键对象k定位到的桶位置不含链表结构,那么对于查找、添加等操作很快;如果定位到的桶位置包含链表结构,对于添加操作,其时间复杂度依然不大,因为最新的元素会插入链表头部,只需要简单改变引用链即可;而对于查找操作来讲,此时就需要遍历链表,然后通过键对象k的equals(k)方法逐一查找比对。
所以,从性能方面考虑,HashMap中的链表出现越少,性能才会越好,这就要求HashMap集合中的桶越多越好。
HashMap根据实际情况,内部实现了动态地分配桶数量的策略。
通过new HashMap()方法创建HashMap时,会默认集合容量capacity大小为16,加载因子loadFactor为0.75(HashMap桶多少权衡策略的经验值),此时该集合桶的阀值就为12(容量capacity与加载因子loadFactor的乘积),如果向HashMap集合中不断添加完全不同的键值对<k,v>,当超过12个存储元素时,HashMap集合就会默认新增加一倍桶的数量(也就是集合的容量),此时集合容量就变为32。
init(FilterConfig filterConfig)
1
使用Iterator迭代器遍历集合
2
使用JDK 8提供的forEach(Consumer action)方法遍历集合
Iterator迭代器遍历Map集合
遍历思路:先将Map集合转换为Iterator接口对象,然后进行遍历。由于Map集合中元素是由键值对组成的,所以使用Iterator接口遍历Map集合时,会有两种将Map集合转换为Iterator接口对象再进行遍历的方法。
遍历方法:keySet()方法和entrySet()方法。
Iterator迭代器遍历Map集合——keySet()方法
Set keySet = map.keySet(); // 获取键的集合
Iterator it = keySet.iterator(); // 迭代键的集合
while (it.hasNext()) {
Object key = it.next();
Object value = map.get(key); // 获取每个键所对应的值
System.out.println(key + ":" + value);
}
遍历思路:先将Map集合中所有键对象转换为Set单列集合,接着将包含键对象的Set集合转换为Iterator接口对象,然后遍历Map集合中所有的键,再根据键获取相应的值。
Iterator迭代器遍历Map集合——entrySet()方法
Set entrySet = map.entrySet();
Iterator it = entrySet.iterator(); // 获取Iterator对象
Map.Entry entry = (Map.Entry) (it.next());
Object key = entry.getKey(); // 获取Entry中的键
Object value = entry.getValue(); // 获取Entry中的值
遍历思路:将原有Map集合中的键值对作为一个整体返回为Set集合,接着将包含键值对对象的Set集合转换为Iterator接口对象,然后获取集合中的所有的键值对映射关系,再从映射关系中取出键和值。
JDK 8新方法遍历Map集合
map.forEach((key,value) -> System.out.println(key + ":" + value));说明:在JDK 8中,根据Lambda表达式特性新增了一个forEach(BiConsumer action)方法来遍历Map集合,该方法所需要的参数也是一个函数式接口,因此可以使用Lambda表达式的书写形式来进行集合遍历。
Map集合值遍历——values()方法
Collection values = map.values(); // 获取Map集合中value值集合对象
values.forEach(v -> System.out.println(v));
说明:在Map集合中,除了以上介绍的两种主要的遍历方式外,还提供了一个values()方法,通过这个方法可以直接获取Map中存储所有值的Collection集合。
注
多
学
一
招
使用LinkedHashMap集合保证元素添加顺序
HashMap集合并不保证集合元素存入和取出的顺序。
如果想让这两个顺序一致,可以使用LinkedHashMap类,它是HashMap的子类。和LinkedList一样也使用双向链表来维护内部元素的关系,使LinkedHashMap元素迭代的顺序与存入的顺序一致。
一般情况下,用的最多的是HashMap,在Map中插入、删除和定位元素,HashMap 是最好的选择。但如果需要输出的顺序和输入的相同,那么用LinkedHashMap可以实现,它还可以按读取顺序来排列。
介绍: TreeMap集合是Map接口的另一个实现类,在TreeMap内部是通过二叉树的原理来保证键的唯一性,这与TreeSet集合存储的原理一样,因此TreeMap中所有的键是按照某种顺序排列的。
说明:为了实现TreeMap元素排序,可以参考TreeSet 集合排序方式,使用自然排序和定制排序。
介绍: Map接口还有一个实现类Hashtable,它和HashMap十分相似,其中一个主要区别在于Hashtable是线程安全的。
说明:Hashtable类有一个子类Properties。Properties主要用来存储字符串类型的键和值,在实际开发中,经常使用Properties集合类来存取应用的配置项。
Properties pps = new Properties();
pps.load(new FileInputStream("test.properties"));
pps.forEach((k, v) -> System.out.println(k + "=" + v));
FileOutputStream out = new FileOutputStream("test.properties");
pps.setProperty("charset", "UTF-8");
pps.store(out, "新增charset编码");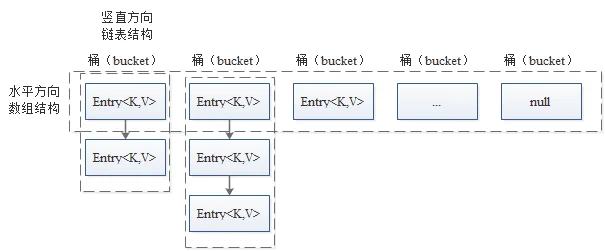
📄 展开课件原文(第 43–59 页,共 17 页)
泛型
集合中可以存储任意类型的对象元素,但是当把一个对象存入集合后,集合会“忘记”这个对象的类型,将该对象从集合中取出时,这个对象的编译类型就统一变成了Object类型。
换句话说,在程序中无法确定一个集合中的元素到底是什么类型,那么在取出元素时,如果进行强制类型转换就很容易出错。
为什么要引入泛型?
定义:泛型可以限定操作的数据类型,在定义集合类时,可以使用“<参数化类型>”的方式指定该集合中存储的数据类型。
语法:以ArrayList集合为例
ArrayList<参数化类型> list = new ArrayList<参数化类型>();
使用:以ArrayList集合为例
ArrayList<String> list = new ArrayList<String>();
📄 展开课件原文(第 60–61 页,共 2 页)
常用工具类
说明:Java提供了一个工具类专门用来操作集合,这个类就是Collections,它位于java.util包中。
Collections类中提供了大量的静态方法用于对集合中元素进行排序、查找和修改等操作。
添加、排序操作——常用方法
| 方法声明 | 功能描述 |
|---|---|
| static <T> boolean addAll(Collection<? super T> c, T... elements) | 将所有指定元素添加到指定集合c中 |
| static void reverse(List list) | 反转指定List集合中元素的顺序 |
| static void shuffle(List list) | 对List集合中的元素进行随机排序 |
| static void sort(List list) | 根据元素的自然顺序对List集合中的元素进行排序 |
| static void swap(List list,int i,int j) | 将指定List集合中角标i处元素和j处元素进行交换 |
查找、替换操作——常用方法
| 方法声明 | 功能描述 |
|---|---|
| static int binarySearch(List list,Object key) | 使用二分法搜索指定对象在List集合中的索引,查找的List集合中的元素必须是有序的 |
| static Object max(Collection col) | 根据元素的自然顺序,返回给定集合中最大的元素 |
| static Object min(Collection col) | 根据元素的自然顺序,返回给定集合中最小的元素 |
| static boolean replaceAll(List list,Object oldVal,Object newVal) | 用一个新值newVal替换List集合中所有的旧值oldVal |
init(FilterConfig filterConfig)
destroy()
1
sort()方法排序;
2
binarySearch(Object[] a, Object key)方法查找元素
3
copyOfRange(int[] original, int from, int to)方法拷贝元素
4
fill(Object[] a, Object val)方法替换元素
说明:在java.util包中,针对数组操作提供了一个工具类——Arrays。Arrays工具类提供了大量针对数组操作的静态方法。
📄 展开课件原文(第 62–65 页,共 4 页)
本章小结
本章详细讲解了Java中常用集合类,从Collection、Map根接口开始讲起,重点讲解了List集合、Set集合、Map集合之间的区别,以及常用实现类的使用方法和需要注意的问题,另外还介绍了泛型的使用、常用工具类Collections和Arrays,最后重点讲解了JDK 8新增功能—聚合操作的使用。
📄 展开课件原文(第 83–84 页,共 2 页)
课件里的提醒 课件原文中的“注意 / 说明 / 定义”
- 例如,要保存一个学校的学生信息,由于不停有新生来报道,同时也有学员毕业离开学校,这时学生的数目无法固定,并且随时可能变动。
- 定义:Java中的集合就像一个容器,专门用来存储Java对象。
- 说明:集合对象可以是任意的数据类型,并且长度可变。
- 注意:这些集合类都位于java.util包中,在使用时一定要注意导包的问题。
- 注意:虚线框里填写的都是接口类型,实线框里填写的都是具体的实现类。
- 定义:List接口继承自Collection接口,是单列集合的一个重要分支,习惯性的会将实现了List接口的对象称为List集合。
- 定义:Iterator接口是Java集合框架中的一员,主要用于迭代访问(即遍历)Collection中的元素,因此Iterator对象也被称为迭代器。
- 定义:foreach循环是一种更加简洁的for循环,也称增强for循环,用于遍历数组或集合中的元素。
- 定义: forEach(Consumer action)方法是JDK 8中新增的遍历集合元素的方法,根据Lambda表达式特性,该方法所需要的参数是一个函数式接口。
- 说明: JDK 8中还针对Iterator迭代器对象提供了一个forEachRemaining(Consumer action)方法来进行遍历,该方法同样需要一个函数式接口。
- 说明:Set接口和List接口一样,同样继承自Collection接口。
- 说明:HashSet是Set接口的一个实现类,它所存储的元素不可重复,并且无序。
本章代码速览 把课件里的示例代码集中起来,可直接复制运行
ArrayList list = new ArrayList();list.add("stu1");list.add("stu2");System.out.println("集合的长度:" + list.size());System.out.println("第2个元素是:" + list.get(1));LinkedList link = new LinkedList();link.add("stu1");link.add("stu2");link.offer("offer"); // 向集合尾部追加元素link.push("push"); // 向集合头部添加元素Object object = link.peek(); //获取集合第一个元素link.removeFirst(); // 删除集合第一个元素