第7章 IO流
File 类、字节流与字符流、缓冲流、转换流、对象序列化——把数据读写到文件。
本章学习目标
- 能用 File 表示文件与目录并做基本操作
- 理解字节流与字符流的区别
- 能用缓冲流提升读写效率
- 能完成对象序列化与反序列化
本章导览
核心内容
I/O流概述
定义:I/O(Input/Output)流,即输入/输出流,是Java中实现输入/输出的基础,它可以方便地实现数据的输入/输出操作。
分类:
字节流和字符流
节点流和处理流
输入流和输出流
根据流操作的数据单位的不同,可以分为字节流和字符流
根据流传输方向的不同,又可分为输入流和输出流
根据流的功能不同,可以分为节点流和处理流
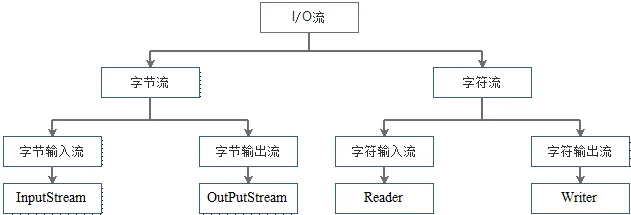
结构:Java中的I/O流主要定义在java.io包中,该包下定义了很多类,其中有4个类为流的顶级类,分别为InputStream和OutputStream,Reader和Writer。
说明:
InputStream和OutPutStream是字节流,而Reader和Writer是字符流;
InputStream和Reader是输入流,而OutPutStream和Writer是输出流;
图中的4个顶级类都是抽象类,并且是所有流类型的父类。
📄 展开课件原文(第 10–11 页,共 2 页)
字节流
定义:在计算机中,无论是文本、图片、音频还是视频,所有文件都是以二进制(字节)形式存在的,I/O流中针对字节的输入/输出提供了一系列的流,统称为字节流。
说明:
字节流是程序中最常用的流。
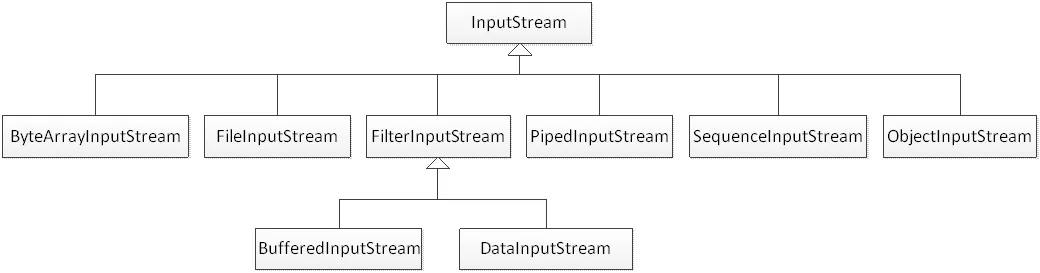
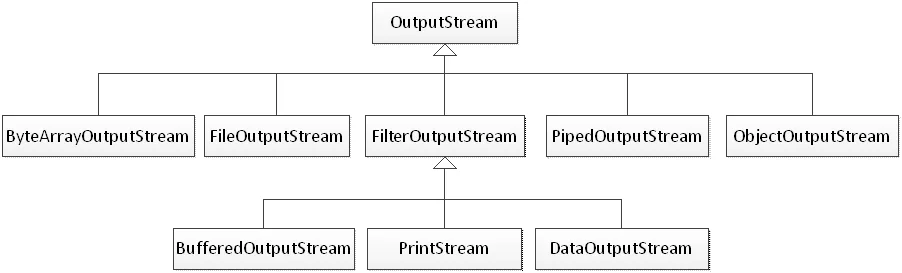
在JDK中,所有的字节输入流都继承自InputStream,所有的字节输出流都继承自OutputStream。
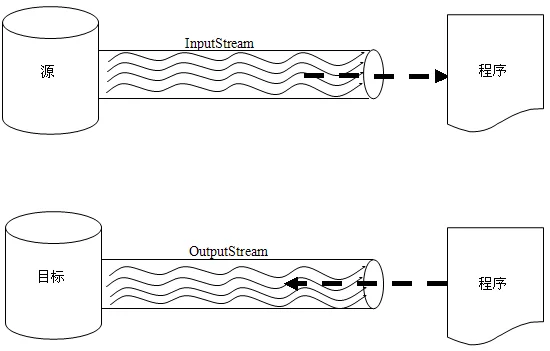
说明: InputStream被看成一个输入管道,OutputStream被看成一个输出管道,数据通过InputStream从源设备输入到程序,通过OutputStream从程序输出到目标设备,从而实现数据的传输。
前三个read()方法都是用来读数据的,分按字节读取和按字节数组读取。
进行I/O流操作时,应该调用close()方法关闭流,从而释放当前I/O流所占的系统资源。
| 方法声明 | 功能描述 |
|---|---|
| int read() | 从输入流读取一个8位的字节,把它转换为0~255之间的整数,并返回这一整数。当没有可用字节时,将返回-1 |
| int read(byte[] b) | 从输入流读取若干字节,把它们保存到参数b指定的字节数组中,返回的整数表示读取字节的数目 |
| int read(byte[] b,int off,int len) | 从输入流读取若干字节,把它们保存到参数b指定的字节数组中,off指定字节数组开始保存数据的起始下标,len表示读取的字节数目 |
| void close() | 关闭此输入流并释放与该流关联的所有系统资源 |
前三个write()方法都是用来写数据的,分按字节读取和按字节数组写入。
flush()方法用来将当前输出流缓冲区(通常是字节数组)中的数据强制写入目标设备,此过程称为刷新。
close()方法是用来关闭流并释放与当前IO流相关的系统资源。
| 方法声明 | 功能描述 |
|---|---|
| void write(int b) | 向输出流写入一个字节 |
| void write(byte[] b) | 把参数b指定的字节数组的所有字节写到输出流 |
| void write(byte[] b,int off,int len) | 将指定byte数组中从偏移量off开始的len个字节写入输出流 |
| void flush() | 刷新此输出流并强制写出所有缓冲的输出字节 |
| void close() | 关闭此输出流并释放与此流相关的所有系统资源 |
7.2.1 字节流概述——InputStream与OutputStream的继承体系
针对文件的读写操作,JDK专门提供了两个类,分别是FileInputStream和FileOutputStream。
FileInputStream是InputStream的子类,它是操作文件的字节输入流,专门用于读取文件中的数据。
从文件读取数据是重复的操作,因此需要通过循环语句来实现数据的持续读取。
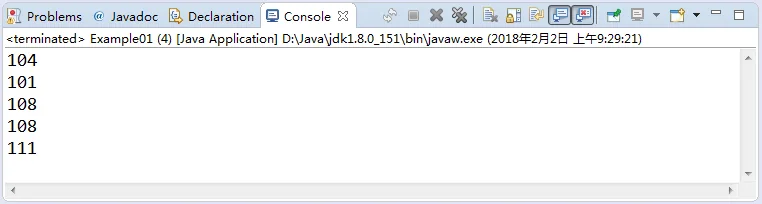
示例(读取包含“hello”内容的txt文件):
结果:
FileInputStream in = new FileInputStream("test.txt");
int b = 0;
while((b=in.read()) != -1){
System.out.println(b);
}
in.close();在读取文件数据时,必须保证文件在相应目录存在并且是可读的,否则会抛出FileNotFoundException。
【注意】
示例(向txt文件写入数据):
FileOutputStream out = new FileOutputStream("out.txt");
String str = "hello";
out.write(str.getBytes());
out.close();
注意:通过FileOutputStream向一个已经存在的文件中写入数据,该文件中的数据首先会被清空,再写入新的数据。若希望在已存在的文件内容之后追加新内容,则可使用构造函数FileOutputStream(String fileName, boolean append)来创建文件输出流对象,并把append参数的值设置为true。
FileOutputStream out = new FileOutputStream("out.txt",true);
String str = " world";
注意:I/O流在进行数据读写操作时会出现异常,为了保证I/O流的close()方法一定执行来释放占用的系统资源,通常会将关闭流的操作写在finally代码块中。
finally{
try{
if(in!=null) in.close();
}catch(Exception e){
e.printStackTrace();
if(out!=null) out.close();
说明:I/O流通常都是成对出现的,即输入流和输出流一起使用。例如文件的拷贝就需要通过输入流来读取源文件中的数据,并通过输出流将数据写入新文件。
FileInputStream in = new FileInputStream("source/src.jpg");
FileOutputStream out = new FileOutputStream("target/dest.jpg");
int len = 0;
long beginTime = System.currentTimeMillis();
while ((len = in.read()) != -1) {
out.write(len);
long endTime = System.currentTimeMillis();
System.out.println("花费时间为:"+(endTime-beginTime) +"毫秒");
说明:上述示例在拷贝过程中,通过while循环将字节逐个进行拷贝。在拷贝文件时,由于计算机性能等各方面原因,会导致拷贝文件所消耗的时间不确定,因此每次运行程序的结果并不一定相同。
假设从北京运送快递到上海,如果有一万件
快递,一件一件的运送就必须运输一万次,这样
的效率显然非常低。为了减少运输次数,可以先
把一批快递装在一个车厢中,这样就可以成批的运送快递,这时的车厢就相当于一个临时缓冲区。
同理:在文件拷贝过程中,通过以字节形式逐个拷贝,效率也非常低。为此,可以定义一个字节数组缓冲区,在拷贝文件时,就可以一次性读取多个字节的数据。
示例(使用字节流缓冲区拷贝文件):
byte[] buff = new byte[1024];
while ((len = in.read(buff)) != -1) {
out.write(buff,0,len);
从图可以看出拷贝文件所消耗的时间明显减少了很多,这说明使用缓冲区读写文件可以有效的提高程序的传输效率。
程序中的缓冲区就是一块内存,该内存主要用于存放暂时输入/输出的数据,由于使用缓冲区减少了对文件的操作次数,所以可以提高读写数据的效率。
说明:除了定义字节缓冲区来提高文件拷贝效率外,IO中还提供了两个字节缓冲流来提高文件拷贝效率:BufferedInputStream和BufferedOutputStream。它们的构造方法中分别接收InputStream和OutputStream类型的参数作为对象,在读写数据时提供缓冲功能。
缓冲流示意图:
示例(使用字节缓冲流拷贝文件):
BufferedInputStream bis = new BufferedInputStream(
new FileInputStream("source/src.jpg"));
BufferedOutputStream bos = new BufferedOutputStream(
new FileOutputStream("target/dest.jpg"));
while ((bis.read()) != -1) {
bos.write(len);
bis.close();
bos.close();
从图可以看出拷贝文件所消耗的时间明显减少了很多,这说明使用字节缓冲流同样可以有效的提高程序的传输效率。
这种方式与字节流的缓冲区类似,都对数据进行了缓冲,从而有效的提高了数据的读写效率。
📄 展开课件原文(第 12–29 页,共 18 页)
字符流
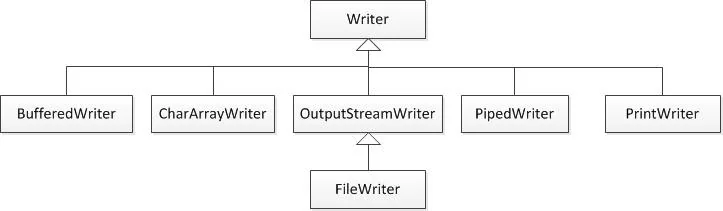
说明:除了字节流,JDK还提供了用于实现字符操作的字符流,同字节流一样,字符流也有两个抽象的顶级父类,分别是Reader和Writer。
Reader和Write继承体系:
说明:想从文件中直接读取字符便可以使用字符输入流FileReader,通过此流可以从文件中读取一个或一组字符。
示例(逐个字符读取文件):
FileReader fileReader = new FileReader("reader.txt");
int len = 0;
while ((len = fileReader.read()) != -1) {
System.out.print((char)len);
}
fileReader.close();说明:要向文件中写入字符就需要使用FileWriter类,该类是Writer的一个子类。
示例(逐个字符写入文件):
同理:使用字符流向文件追加写入数据,需要调用重载的构造方法。
FileWriter fileWriter = new FileWriter("writer.txt");
fileWriter.write("轻轻的我走了,\r\n");
fileWriter.write("正如我轻轻的来;\r\n");
fileWriter.write("我轻轻的招手,\r\n");
fileWriter.write("作别西天的云彩。\r\n");
fileWriter.close();
FileWriter fileWriter = new FileWriter("writer.txt",true);
说明:使用字符流逐个字符的读写文件也需要频繁的操作文件,效率仍非常低。为此,同字节流操作文件一样,也可以使用提供的字符流缓冲区(类似于字节流缓冲区)和字符缓冲流(类似于字节缓冲流)进行读写操作,来提高执行效率。
使用:
字符流缓冲区需要定义一个字符数组作为字符缓冲区,通过操作字符缓冲区来提高文件读写效率。
字符缓冲流需要使用BufferedReader和BufferedWriter,其中BufferedReader用于对字符输入流进行操作,BufferedWriter用于对字符输出流进行操作。在BufferedReader中有一个readLine()方法,用于一次读取一行文本。
示例(使用字符流缓冲区拷贝文件):
char[] buff = new char[1024];
while ((len = fileReader.read(buff)) != -1) {
fileWriter.write(buff, 0, len);
示例(使用字符缓冲流拷贝文件):
BufferedReader br = new BufferedReader(new FileReader("reader.txt "));
BufferedWriter bw = new BufferedWriter(new FileWriter("writer.txt"));
String str = null;
while ((str = br.readLine()) != null) {
bw.write(str);
bw.newLine();
br.close();
bw.close();
说明:在JDK中,提供了两个类用于实现将字节流转换为字符流,它们分别是InputStreamReader和OutputStreamWriter。
InputStreamReader是Reader的子类,它可以将一个字节输入流转换成字符输入流,方便直接读取字符。
OutputStreamWriter是Writer的子类,它可以将一个字节输出流转换成字符输出流,方便直接写入字符。
转换流操作文件示意图:
示例(使用转换流拷贝文件):
FileInputStream in = new FileInputStream("reader.txt");
InputStreamReader isr = new InputStreamReader(in);
BufferedReader br = new BufferedReader(isr);
FileOutputStream out = new FileOutputStream("writer.txt");
OutputStreamWriter osw = new OutputStreamWriter(out);
BufferedWriter bw = new BufferedWriter(osw);
String line = null;
while ((line = br.readLine()) != null) {
bw.write(line);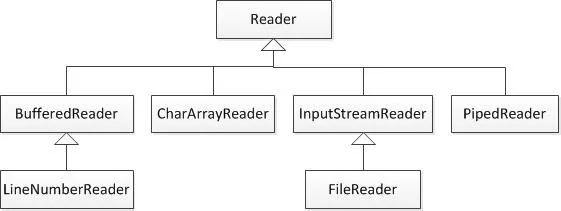
📄 展开课件原文(第 30–37 页,共 8 页)
File类
说明:File类用于封装一个路径,这个路径可以是从系统盘符开始的绝对路径,也可以是相对于当前目录而言的相对路径。封装的路径可以指向一个文件,也可以指向一个目录,在File类中提供了针对这些文件或目录的一些常规操作。
File类常用构造方法:
| 方法声明 | 功能描述 |
|---|---|
| File(String pathname) | 通过指定的一个字符串类型的文件路径来创建一个新的File对象 |
| File(String parent,String child) | 根据指定的一个字符串类型的父路径和一个字符串类型的子路径(包括文件名称)创建一个File对象 |
| File(File parent,String child) | 根据指定的File类的父路径和字符串类型的子路径(包括文件名称)创建一个File对象 |
| 方法声明 | 功能描述 |
|---|---|
| boolean exists() | 判断File对象对应的文件或目录是否存在,若存在则返回ture,否则返回false |
| boolean delete() | 删除File对象对应的文件或目录,若成功删除则返回true,否则返回false |
| boolean createNewFile() | 当File对象对应的文件不存在时,该方法将新建一个此File对象所指定的新文件,若创建成功则返回true,否则返回false |
| String getName() | 返回File对象表示的文件或文件夹的名称 |
| String getPath() | 返回File对象对应的路径 |
| String getAbsolutePath() | 返回File对象对应的绝对路径(在Unix/Linux等系统上,如果路径是以正斜线/开始,则这个路径是绝对路径;在Windows等系统上,如果路径是从盘符开始,则这个路径是绝对路径) |
| String getParent() | 返回File对象对应目录的父目录(即返回的目录不包含最后一级子目录) |
| boolean canRead() | 判断File对象对应的文件或目录是否可读,若可读则返回true,反之返回false |
| boolean canWrite() | 判断File对象对应的文件或目录是否可写,若可写则返回true,反之返回false |
| boolean isFile() | 判断File对象对应的是否是文件(不是目录),若是文件则返回true,反之返回false |
| 方法声明 | 功能描述 |
|---|---|
| boolean isFile() | 判断File对象对应的是否是文件(不是目录),若是文件则返回true,反之返回false |
| boolean isDirectory() | 判断File对象对应的是否是目录(不是文件),若是目录则返回true,反之返回false |
| boolean isAbsolute() | 判断File对象对应的文件或目录是否是绝对路径 |
| long lastModified() | 返回1970年1月1日0时0分0秒到文件最后修改时间的毫秒值 |
| long length() | 返回文件内容的长度 |
| String[] list() | 列出指定目录的全部内容,只是列出名称 |
| String[] list(FilenameFilter filter) | 接收一个FilenameFilter参数,通过该参数可以只列出符合条件的文件 |
| File[] listFiles() | 返回一个包含了File对象所有子文件和子目录的File数组 |
示例(对当前目录下的txt文件进行操作):
File file = new File("example.txt");
System.out.println("文件名称:" + file.getName());
System.out.println("文件的相对路径:" + file.getPath());
System.out.println("文件的绝对路径:" + file.getAbsolutePath());
System.out.println("文件的父路径:" + file.getParent());
System.out.println(file.canRead() ? "文件可读" : "文件不可读");
System.out.println(file.canWrite() ? "文件可写": "文件不可写");
System.out.println(file.isFile() ? "是一个文件" :"不是一个文件");
System.out.println(file.isDirectory()? "是一个目录":"不是一个目录");
System.out.println(file.isAbsolute() ? "是绝对路径": "不是绝对路径");
System.out.println("最后修改时间为:" + file.lastModified());
System.out.println("文件大小为:" + file.length() + " bytes");
System.out.println("是否成功删除文件"+file.delete());
说明:File类中有一个list()方法,该方法用于遍历某个指定目录下的所有文件的名称。
示例:
File file = new File("F:\\Java基础入门\\workspace\\chapter07");
if (file.isDirectory()) {
String[] fileNames = file.list();
Arrays.stream(fileNames)
.forEach(f -> System.out.println(f));}
说明:File类中提供了一个重载的list(FilenameFilter filter)方法,该方法接收一个FilenameFilter接口类型的参数,其中定义了一个抽象方法accept(File dir,String name)用于依次对指定File的所有子目录或文件进行迭代。
示例(筛选遍历扩展名“.txt”文件):
String[] fileNames = file.list((dir,name) -> name.endsWith(".txt"));
public static void main(String[] args){
File file = new File(" F:\\Java基础入门\\workspace\\chapter07");
fileDir(file);
public static void fileDir(File file) {
File[] listFiles = file.listFiles();
for (File files : listFiles) {
if(files.isDirectory()){
fileDir(files);
System.out.println(files);listFiles()方法返回一个File对象数组
递归调用遍历目录方法
File files = new File("D:\\test\\新建文件夹");deleteDir(files);
public static void deleteDir(File files) {
File[] listFiles = files.listFiles();
for (File file : listFiles) {
if(file.isDirectory()){
deleteDir(file);
file.delete();
files.delete();
递归调用删除目录方法
直接删除文件
最后删除最外层目录
Java中删除目录的操作是通过Java虚拟机直接删除而不走回收站的,文件一旦删除就无法恢复。
【注意】
📄 展开课件原文(第 38–45 页,共 8 页)
RandomAccesseFile
说明:在IO包中,提供了一个RandomAccesseFile类,它不属于流类,但具有读写文件数据的功能,可以随机从文件的任何位置开始并以指定的操作权限(如只读、可读写等)执行读写数据的操作。
RandomAccesseFile类构造方法:
| 方法声明 | 功能描述 |
|---|---|
| RandomAccessFile(File file,String mode) | 使用参数file指定被访问的文件,并使用mode来指定访问模式 |
| RandomAccessFile(String name,String mode) | 使用参数name指定被访问文件的路径,并使用mode来指定访问模式 |
RandomAccessFile(String name,String mode)中的参数mode用于指定访问文件的模式,也就是文件的操作权限。
参数mode取值:
r:以只读的方式打开文件。如果执行写操作,会报IOException异常。
rw:以“读写”的方式打开文件。如果文件不存在,会自动创建该文件。
rws:以“读写”方式打开文件。与“rw”相比,它要求对文件的内容或元数据的每个更新都同步写入到底层的存储设备。
rwd:以“读写”方式打开文件。与“rw”相比,它要求对文件的内容的每个更新都同步写入到底层的存储设备。
原理:RandomAccessFile对象包含了一个记录指针来标识当前读写处的位置。
当新建RandomAccessFile对象时,该对象的文件记录指针会在文件开始处(即标识为0的位置);
当读写了n个字节后,文件记录指针会向后移动n个字节。
除了按顺序读写外,RandomAccessFile对象还可以自由的移动记录指针,既可以向前移动,也可以向后移动。
RandomAccessFile常用方法:
说明:seek(long pos)方法可以使RandomAccessFile对象中的记录指针向前、向后自由移动,通过getFilePointer()方法,便可获取文件当前记录指针的位置。
| 方法声明 | 功能描述 |
|---|---|
| long getFilePointer() | 返回当前读写指针所处的位置 |
| void seek(long pos) | 设定读写指针的位置,与文件开头相隔pos个字节数 |
| int skipBytes(int n) | 使读写指针从当前位置开始,跳过n个字节 |
| void write(byte[] b) | 将指定的字节数组写入到这个文件,并从当前文件指针开始 |
| void setLength(long newLength) | 设置此文件的长度 |
| final String readLine() | 从指定文件当前指针读取下一行内容 |
示例(模拟软件使用次数):
RandomAccessFile raf = new RandomAccessFile("time.txt", "rw");
int times = Integer.parseInt(raf.readLine())-1;
if(times > 0){
System.out.println("您还可以试用"+ times+"次!");
raf.seek(0); // 将记录指针重新指向文件开头
raf.write((times+“”).getBytes()); // 将剩余次数再写入文件
}else{
System.out.println("试用次数已经用完!");
}
raf.close();示例(通过Serializable接口实现对象序列化):
public class Person implements Serializable {
// 为该类指定一个serialVersionUID变量值
private static final long serialVersionUID = 1L;
//声明变量
private int id;
private String name;
private int age;
// 此处省略各属性的getter和setter方法
...
标识Java类的序列化版本。如果不显示的定义serialVersionUID变量值,那么将由JVM根据类的相关信息计算出一个serialVersionUID变量值。
指定类实现序列化接口
小提示
serialVersionUID适用于Java的序列化机制。在进行反序列化时,JVM会把传来的字节流中的serialVersionUID与本地相应实体类的serialVersionUID进行比较,如果相同就可以进行反序列化,否则就会出现异常。因此,为了在反序列化时确保序列化版本的兼容性,最好在每一个要序列化的类中加入private static final long serialVersionUID的变量值,具体数值可自定义(默认是1L,系统还可以根据类名、接口名、成员方法及属性等生成的一个64位的哈希字段)。这样,某个对象被序列化之后,即使它所对应的类被修改了,该对象也依然可以被正确的反序列化。
📄 展开课件原文(第 46–55 页,共 7 页)
对象序列化
程序在运行过程中,可能需要将一些数据永久的保存到磁盘上,而数据在Java中都是保存在对象当中的。那么我们要怎样将对象中的数据保存到磁盘上呢?这时就需要使用Java中的对象序列化。
对象序列化有什么作用?
定义:对象的序列化(Serializable)是指将一个Java对象转换成一个I/O流中字节序列的过程。
目的:为了将对象保存到磁盘中,或允许在网络中直接传输对象。
说明:
对象序列化可以使内存中的Java对象转换成与平台无关的二进制流;
既可以将这种二进制流持久地保存在磁盘上,又可以通过网络将这种二进制流传输到另一个网络节点;
其他程序在获得了这种二进制流后,还可以将它恢复成原来的Java对象;
这种将I/O流中的字节序列恢复为Java对象的过程被称之为反序列化(Deserialize)。
说明:想让某个对象支持序列化,那么这个对象所在的类必须是可序列化的。在Java中,可序列化的类必须实现Serializable或Externalizable两个接口之一。
2、实现Externalizable接口
由程序员决定存储的信息
接口中提供了两个空方法,实现该接口必须为两个方法提供实现
性能较好
编程复杂度大
1、实现Serializable接口
系统自动存储必要信息
Java内部支持,易实现,只需实现该接口即可,不需要其他代码支持
性能较差
容易实现,实际开发使用较多
📄 展开课件原文(第 51–53 页,共 3 页)
NIO
定义:从JDK 1.4开始,Java提供了一系列改进的用于处理输入/输出的新功能,这些新功能被称之为NIO(New I/O)。
说明:
NIO采用内存映射文件的方式来处理输入/输出,它将文件或文件的一段区域映射到内存中,这样就可以像访问内存一样来访问文件了。
在NIO中,使用的是Channel(通道)和Buffer(缓冲器)。
数据总是从通道读入缓冲器,或从缓冲器写入通道。
NIO相关包:
java.nio:主要包含各种与Buffer相关的类。
java.nio.channels:主要包含与Channel和Selector(多线程相关选择器)相关的类。
java.nio.channels.spi:主要包含与Channel相关的服务提供者编程接口。
java.nio.charset:主要包含与字符集相关的类。
java.nio.charset.spi:主要包含与字符集相关的服务提供者编程接口。
Buffer
(缓冲器)
Channel
(通道)
Selecter
(选择器)
Buffer本质是一个数组缓冲区,读入或写出到Channel中的所有对象都会先放在Buffer中。
Channel是对传统的输入/输出的模拟,在NIO中,所有的数据都需要通过通道流的形式传输。
Selecter用于监听多个通道的事件(例如:连接打开、数据到达等),主要用于多线程处理。
作用:Java NIO中的Buffer用于和NIO中的Channel进行交互,交互时数据会从Channel读取到Buffer中,或从Buffer写入到Channel中。
图示:
Buffer类似于一个数组,它可以保存多个类型相同的数据。
Buffer是一个抽象类,其子类有ByteBuffer、CharBuffer、DoubleBuffer、FloatBuffer、IntBuffer、LongBuffer和ShortBuffer。
Buffer子类中最常用的是ByteBuffer和CharBuffer
使用:
Buffer类的子类中并没有提供构造方法,因此不能通过构造方法来创建对象。
创建Buffer对象,通常会通过子类中的static XxxBuffer allocate(int capacity)方法来实现(其中Xxx表示不同的数据类型,而capacity表示容量)。
示例(创建一个容量为6的CharBuffer对象):
CharBuffer buffer = CharBuffer.allocate(6);capacity(容量)
position(位置)
limit(界限)
缓冲器的容量表示该Buffer的最大数据容量,即最多可以存储多少数据。缓冲器的容量值不能为负数,也不能够改变。
表示Buffer容器中不可被读取的区域的第一个索引,即位于Buffer容器中索引为0到limit之间的区域都可以进行读取操作。缓冲器的limit值从不为负,也从不大于其容量。
用于指定下一个可以被读写的缓冲器位置索引。新创建的Buffer对象,position的默认值为0,每进行一次读取或写入操作,position的值都会自动向后移动一步。
| 方法声明 | 功能描述 |
|---|---|
| int capacity() | 获取缓冲区的大小 |
| Buffer clear() | 清除缓冲区,将position设置为0,limit设置为capacity |
| Buffer flip() | 反转缓冲区,先将limit设置为当前position位置,然后再将position设置为0 |
| boolean hasRemaining() | 判断当前位置(position)和界限(limit)之间是否还有元素 |
| int limit | 获取Buffer的limit位置 |
| Buffer limit(int newLimit) | 设置limit的值,并返回一个新的limit缓冲区对象 |
| Buffer mark() | 设置Buffer的标记(mark),只能在0与position之间做标记 |
| int position() | 获取Buffer中position的值 |
| Buffer position(int newPosition) | 设置Buffer的position,并返回位置被修改之后的Buffer对象 |
| int remaining() | 获取当前位置和界限之间的元素个数 |
| Buffer reset() | 将此缓冲区的位置重置为先前标记的位置 |
| Buffer rewind() | 倒带缓冲区,将position设置为0,并取消设置的标记 |
Channel可以异步的执行I/O读写操作。
Channel的读写操作是双向的,既可以从Channel中读取数据,又可以写数据到Channel,而流的读写操作通常都是单向的。
Channel可以直接将指定文件的部分或者全部直接映射成Buffer。
Channel只能与Buffer进行交互,程序不能直接读写Channel中的数据。
说明:Channel接口的实现类主要包括DatagramChannel、FileChannel、Pipe.SinkChannel、Pipe.SourceChannel、ServerSocketChannel、SocketChannel等。
DatagramChannel用于支持UDP网络通信;
FileChannel用于从文件中读写数据;
Pipe.SinkChannel和Pipe.SourceChannel用于支持线程之间的通信;
ServerSocketChannel和SocketChannel用于支持TCP网络通信。
Channel对象并不是通过构造方法来创建的,而是通过传统I/O的getChannel()方法来获取对应的Channel。
不同的流所获取的Channel是不同的,例如FileInputStream和FileOutputStream获取的是FileChannel,同时还可以使用RandomAccessFile获取该对象。
PipedInputStream和PipedOutputStream所获得的是Pipe.SinkChannel和Pipe.SourceChannel。
| 方法声明 | 功能描述 |
|---|---|
| MappedByteBuffer map(MapMode mode, long position, long size) | 将该通道文件的区域直接映射到内存中。其中第1个参数用于执行映射时的模式,包含只读、读写等模式;第2个参数表示映射区域开始的文件中的位置;第3个参数表示要映射区域的大小 |
| long position() | 返回该通道的文件位置 |
| Int read(ByteBuffer dst) | 从这个通道读取一个字节序列到给定的缓冲区 |
| Int read(ByteBuffer dst, long position) | 从给定的文件位置开始,从这个通道读取一个字节序列到给定的缓冲区 |
| long read(ByteBuffer[] dsts, int offset, int length) | 从这个通道读取一个字节序列到给定缓冲区的子序列 |
| long size() | 返回该通道文件的当前大小 |
| 方法声明 | 功能描述 |
|---|---|
| long transferTo(long position, long count, WritableByteChannel target) | 读取该通道文件中给定位置的字节数,并将它们写入目标通道 |
| Int write(ByteBuffer src) | 从给定的缓冲区写入这个通道的字节序列 |
| long write(ByteBuffer[] srcs, int offset, int length) | 从给定缓冲区的子序列中写入该通道的字节序列 |
| Int write(ByteBuffer src, long position) | 从给定的缓冲区开始,从给定的文件位置开始向该通道写入一个字节序列 |
示例(FileChannel拷贝文件):
RandomAccessFile infile = new RandomAccessFile("source/src.jpg","rw");
FileChannel inChannel = infile.getChannel();
RandomAccessFile outfile =new RandomAccessFile("target/dest.jpg","rw");
FileChannel outChannel = outfile.getChannel();
// 使用transferTo()方法进行整体复制
long transferTo = inChannel.transferTo(0, inChannel.size(), outChannel);
if(transferTo>0){
System.out.println("复制成功!");
}
infile.close();
inChannel.close();
outfile.close();
outChannel.close();
📄 展开课件原文(第 56–69 页,共 14 页)
NIO.2
定义:JDK 7引入了新的I/O API,对原有I/O API中的功能进行改进,这个改进之后的NIO就称之为NIO.2。
说明:
NIO.2最大的改进是提供了全面的文件输入/输出以及文件系统的访问与支持;
并且新增了java.nio.file包及其子包;
而且还提供基于异步Channel的输入/输出。
什么是NIO.2?
作用:Path接口是一个共用在文件系统中定位文件的对象,通常表示一个依赖于系统的文件路径。
除此之外,NIO.2还提供了Paths和Files两个工具类;
Paths类中提供了两个返回Path的静态方法,通过这两个方法可以创建Path对象;
Files类中提供了大量的静态方法来操作文件。
| 方法声明 | 功能描述 |
|---|---|
| boolean endsWith(String other) | 判断当前路径是否以指定的字符串结尾 |
| Path getName(int index) | 返回此路径的名称元素作为路径对象 |
| int getNameCount() | 返回路径中名称元素的数量 |
| Path getParent() | 返回父路径,如果此路径没有父路径,则返回null |
| Path getRoot() | 返回该路径的根组件作为路径对象,如果此路径没有根组件,则返回null |
| Path toAbsolutePath() | 返回表示此路径的绝对路径的路径对象 |
| URI toUri() | 返回表示此路径的URI地址 |
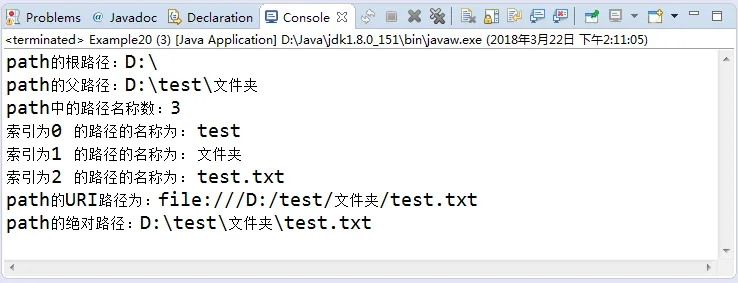
示例:
Path path = Paths.get("D:\\test\\文件夹\\test.txt");
System.out.println("path的根路径:" + path.getRoot());
System.out.println("path的父路径:" + path.getParent());
System.out.println("path中的路径名称数:" + path.getNameCount());
for (int i = 0; i < path.getNameCount(); i++) {
Path name = path.getName(i);
System.out.println("索引为" + i + " 的路径的名称为: " + name);
}
System.out.println("path的URI路径为:" + path.toUri());
System.out.println("path的绝对路径:" + path.toAbsolutePath());
结果:
说明:示例中首先使用Paths的get()方法创建了Path对象,然后分别使用Path对象中的各种方法来输出对象中的路径信息。
| 方法声明 | 功能描述 |
|---|---|
| static Path createDirectories(Path dir, FileAttribute<?>... attrs) | 创建多级文件目录 |
| static Path createFile(Path path, FileAttribute<?>... attrs) | 创建一个新的空文件,如果文件已经存在,则创建失败 |
| static Path copy(Path source, Path target,CopyOption... options) | 该方法将一个文件复制到目标文件,并使用选项参数指定如何执行复制 |
| static List<String> readAllLines(Path path) | 从文件中读取所有行 |
| static long size(Path path) | 返回文件的大小(以字节为单位) |
| static Stream<Path> list(Path dir) | 将指定路径转换为Stream流对象 |
| static Path write(Path path, Iterable<? extends CharSequence> lines, OpenOption... options) | 将文本行写入文件,并传入指定的写入模式 |
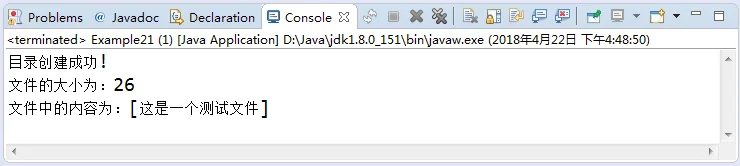
Path directoryPath = Paths.get("D:/test/sample");
Files.createDirectories(directoryPath);
System.out.println("目录创建成功!");
Path filePath = Paths.get("D:/test/sample/test.txt");
Files.createFile(filePath);
List<String> list = new ArrayList<String>();
list.add("这是一个测试文件");
Files.write(filePath, list, StandardOpenOption.APPEND);
List<String> lines = Files.readAllLines(filePath);
System.out.println("文件的大小为:" + Files.size(filePath));
System.out.println("文件中的内容为:" + lines);
示例中演示了Files工具类的一些用法,包括文件的创建、写入、读取等功能。
关于Files类中更多方法的使用,读者可查找官方文档来学习。
📄 展开课件原文(第 70–77 页,共 8 页)
本章小结
本章主要介绍了Java输入、输出体系的相关知识。首先讲解了如何使用字节流和字符流来读写磁盘上的文件,然后介绍了如何使用File对象访问本地文件系统,最后又讲解了NIO和NIO.2相关知识。
📄 展开课件原文(第 78–79 页,共 2 页)
课件里的提醒 课件原文中的“注意 / 说明 / 定义”
- 定义:I/O(Input/Output)流,即输入/输出流,是Java中实现输入/输出的基础,它可以方便地实现数据的输入/输出操作。
- 定义:在计算机中,无论是文本、图片、音频还是视频,所有文件都是以二进制(字节)形式存在的,I/O流中针对字节的输入/输出提供了一系列的流,统称为字节流。
- 说明: InputStream被看成一个输入管道,OutputStream被看成一个输出管道,数据通过InputStream从源设备输入到程序,通过OutputStream从程序输出到目标设备,从而实现数据的传输。
- 注意:通过FileOutputStream向一个已经存在的文件中写入数据,该文件中的数据首先会被清空,再写入新的数据。若希望在已存在的文件内容之后追加新内容,则可使用构造函数FileOutputStream(String fileName, boolean append)来创建文件输出流对象,并把append参数的值设置为true。
- 注意:I/O流在进行数据读写操作时会出现异常,为了保证I/O流的close()方法一定执行来释放占用的系统资源,通常会将关闭流的操作写在finally代码块中。
- 说明:I/O流通常都是成对出现的,即输入流和输出流一起使用。例如文件的拷贝就需要通过输入流来读取源文件中的数据,并通过输出流将数据写入新文件。
- 说明:上述示例在拷贝过程中,通过while循环将字节逐个进行拷贝。在拷贝文件时,由于计算机性能等各方面原因,会导致拷贝文件所消耗的时间不确定,因此每次运行程序的结果并不一定相同。
- 说明:除了定义字节缓冲区来提高文件拷贝效率外,IO中还提供了两个字节缓冲流来提高文件拷贝效率:BufferedInputStream和BufferedOutputStream。它们的构造方法中分别接收InputStream和OutputStream类型的参数作为对象,在读写数据时提供缓冲功能。
- 说明:除了字节流,JDK还提供了用于实现字符操作的字符流,同字节流一样,字符流也有两个抽象的顶级父类,分别是Reader和Writer。
- 说明:想从文件中直接读取字符便可以使用字符输入流FileReader,通过此流可以从文件中读取一个或一组字符。
- 说明:要向文件中写入字符就需要使用FileWriter类,该类是Writer的一个子类。
- 说明:使用字符流逐个字符的读写文件也需要频繁的操作文件,效率仍非常低。为此,同字节流操作文件一样,也可以使用提供的字符流缓冲区(类似于字节流缓冲区)和字符缓冲流(类似于字节缓冲流)进行读写操作,来提高执行效率。
本章代码速览 把课件里的示例代码集中起来,可直接复制运行
FileInputStream in = new FileInputStream("test.txt");int b = 0;while((b=in.read()) != -1){System.out.println(b);in.close();FileOutputStream out = new FileOutputStream("out.txt");String str = "hello";out.write(str.getBytes());out.close();FileOutputStream out = new FileOutputStream("out.txt",true);String str = " world";finally{