单元3 Hive数据定义
数据库、表、分区、分桶、视图、物化视图 —— Hive 的“数据蓝图”全在这里
本单元学习目标 摘自课件“学习目标/Target”页
- 了解数据库操作,能够使用HiveQL语句完成数据库的创建、查询、删除等操作。
- 掌握表操作,能够熟练使用HiveQL语句实现表的创建、查询、删除等操作。
- 掌握分区操作,能够熟练使用HiveQL语句创建分区表,并实现添加与删除分区等操作。
- 熟悉分桶操作,能够使用HiveQL语句创建分桶表。
- 熟悉临时表操作,能够使用HiveQL语句创建临时表。
- 熟悉视图操作,能够使用HiveQL语句实现视图的创建、查询、删除等操作。
- 熟悉物化视图操作,能够使用HiveQL语句实现物化视图的创建、查询、删除等操作。
单元概述
Hive数据定义是数据仓库建设中的基础环节,主要用于定义和维护数据库、表、分区、视图等元数据信息。数据定义通常通过数据定义语言(Data Definition Language,简称DDL)实现,支持创建、修改、查看和删除等操作。需要说明的是,由于Hive索引机制在实际使用中维护成本较高,查询优化器利用率有限,在许多场景下性能提升并不明显,甚至可能降低查询效率,因此自Hive 3.0起,官方已移除对索引机制的支持。本单元在介绍Hive数据定义相关内容时,将不再涉及索引操作。
知识地图
学完本单元,你应该能回答
- 内部表与外部表在删除时有什么不同?
- 分区表与分桶表分别解决什么场景的问题?
- 视图与物化视图的取舍依据是什么?
- CREATE TABLE 中 ROW FORMAT、STORED AS 分别管什么?
知识链位置
核心知识 点击标题右侧勾选框可标记“已掌握”,进度会保存在本机浏览器
3.1 管理数据库
创建数据库
了解数据库操作,能够使用HiveQL语句完成数据库的创建操作。
在Hive中,系统默认提供一个名为default的数据库供用户使用。不过,在实际应用中,通常需要根据具体的业务需求创建对应的数据库,以实现更清晰的数据组织。在Hive中创建数据库的语法格式如下。
CREATE DATABASE [IF NOT EXISTS] db_name[COMMENT database_comment]
[LOCATION hdfs_path]
[MANAGEDLOCATION hdfs_path]
[WITH DBPROPERTIES (property_name=property_value,...)];语法格式
用于在Hive中创建一个新的数据库
用于在创建数据库前进行存在性判断
用于定义数据库的名称
用于为数据库添加描述信息
用于指定数据库在HDFS上的根目录
指定数据库中内部表的存储路径
用于为数据库添加属性
在MySQL中构建Hive运行所需的元数据表结构时,系统默认将表的字符集设置为latin1。这将导致当用户在Hive中创建数据库并指定中文描述信息或属性时,出现乱码问题。为解决该问题,需要在MySQL中存储Hive元数据的remote数据库执行如下操作。
▸ 课件步骤 01
DBS表中的DESC字段用于存储数据库的描述信息,因此需要将该字段的字符集和排序规则修改为utf8mb4和utf8mb4_unicode_ci,以确保中文内容能够正常存储与显示。在虚拟机Node03中使用root用户登录MySQL,在MySQL命令行界面执行如下命令。
ALTER TABLE remote.DBSMODIFY COLUMN `DESC` VARCHAR(4000)
CHARACTER SET utf8mb4
COLLATE utf8mb4_unicode_ci;▸ 课件步骤 02
DATABASE_PARAMS表中的PARAM_KEY和PARAM_VALUE字段用于存储数据库的属性名称和属性值,因此需要将这两个字段的字符集和排序规则修改为utf8mb4和utf8mb4_unicode_ci,以确保中文内容能够正常存储与显示。在虚拟机Node03中使用root用户登录MySQL,在MySQL命令行界面执行如下命令。
ALTER TABLE remote.DATABASE_PARAMSMODIFY COLUMN `PARAM_KEY` VARCHAR(180) CHARACTER SET utf8mb4 COLLATE utf8mb4_unicode_ci,
MODIFY COLUMN `PARAM_VALUE` VARCHAR(4000) CHARACTER SET utf8mb4 COLLATE utf8mb4_unicode_ci;▸ 课件步骤 02
接下来,演示如何在Hive中创建名为analytics的数据库,具体HiveQL语句如下。
CREATE DATABASE IF NOT EXISTS analyticsCOMMENT '分析业务数据库'
LOCATION '/data/hive/analytics.db'
MANAGEDLOCATION '/data/hive/analytics.db/managed'
WITH DBPROPERTIES ('creator'='itcast',
'created_at'='2025-07-18'
);建一个带注释、指定存储目录的库,并立即验证。
CREATE DATABASE IF NOT EXISTS school
COMMENT '校园选课演示库'
LOCATION '/user/hive/warehouse/school.db'
WITH DBPROPERTIES ('creator'='student', 'date'='2025-07-01');

DESCRIBE DATABASE EXTENDED school;
💡 库在 HDFS 上就是一个目录;WITH DBPROPERTIES 用来记录责任人、创建时间等信息。
📄 展开课件原文(第 8–13 页,共 6 页)
查询数据库
了解数据库操作,能够使用HiveQL语句完成数据库的查询操作。
SHOW DATABASES [LIKE pattern];在实际工作中,用户往往需要查看当前操作的Hive中有哪些数据库可用,以便确定接下来要进行操作的目标。通过查询数据库,用户可以快速获取数据库的名称列表。在Hive中查询数据库的语法格式如下。
具体格式
用于在Hive中查询数据库
用于按照SQL通配符模式匹配数据库名称
用于指定匹配模式,用单引号包裹
案例
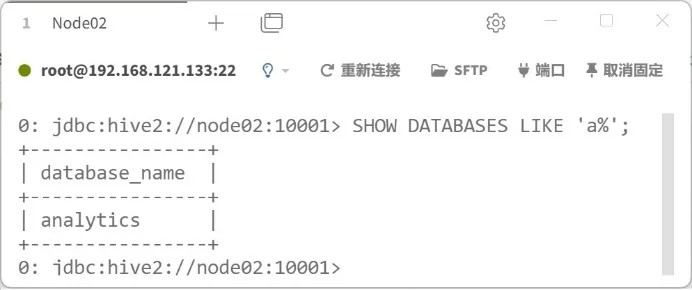
接下来,演示如何在Hive中查询名称以字母 a 开头的数据库,具体HiveQL语句如下。
SHOW DATABASES LIKE 'a%';上述命令执行完成后的效果如图。
📄 展开课件原文(第 14–16 页,共 3 页)
查看数据库信息
了解数据库操作,能够使用HiveQL语句完成查看数据库信息的操作。
DESCRIBE DATABASE [EXTENDED] db_name;为便于更清晰地了解已创建数据库的详细信息,例如数据库的存储位置、描述信息等内容,用户可使用查看数据库信息的命令查看指定数据库的元数据。在Hive中查看数据库信息的语法格式如下。
语法格式
用于在Hive中查看数据库信息
用于显示数据库的属性信息
用于指定要查看的数据库名称
案例
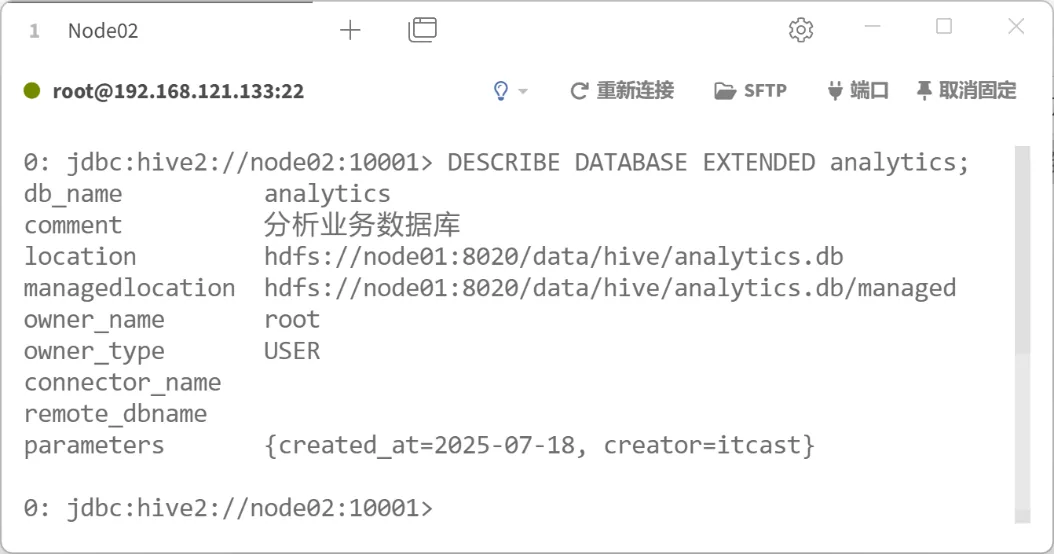
接下来,演示如何在Hive中查看analytics数据库的信息,具体HiveQL语句如下。
DESCRIBE DATABASE EXTENDED analytics;在执行上述命令之前,建议读者通过交互式命令!outputformat将Beeline中查询结果的输出格式设置为vertical,以避免信息内容过长导致换行混乱,影响阅读效果,具体命令如下。
表示数据库名称
表示数据库的描述信息
表示数据库在HDFS上的根目录
表示数据库中内部表的存储路径
表示数据库拥有者的主体名
表示数据库拥有者的类型
表示数据库映射到远端数据库的连接器名称
如果存储在Hive的中文数据或元数据在其他客户端工具(如DataGrip)中显示正常,但在Beeline中显示为问号,则需要在启动Beeline之前,将系统的语言环境和编码设置为简体中文和UTF-8,具体命令如下。
Beeline中文乱码
export LC_ALL=zh_CN.UTF-8上述命令仅在当前终端中生效,关闭终端后会自动失效。若希望永久生效,可以将上述命令写入系统环境变量文件profile,并初始化系统环境变量。
📄 展开课件原文(第 17–20 页,共 4 页)
切换数据库
了解数据库操作,能够使用HiveQL语句完成切换数据库的操作。
USE db_name;当用户连接Hive时,默认使用名为default的数据库。在实际应用中,通常会存在多个数据库,用户常常需要在不同的数据库之间进行切换,以便执行针对不同的数据集执行分析操作。在Hive中切换数据库的语法格式如下。
语法格式
USE语句用于切换数据库
案例
接下来,演示如何在Hive中将当前使用的数据库切换为analytics,HiveQL语句如下。
USE analytics;上述命令执行完成后,通过执行如下HiveQL语句查看当前使用的数据库,确认数据库是否切换成功。
SELECT current_database();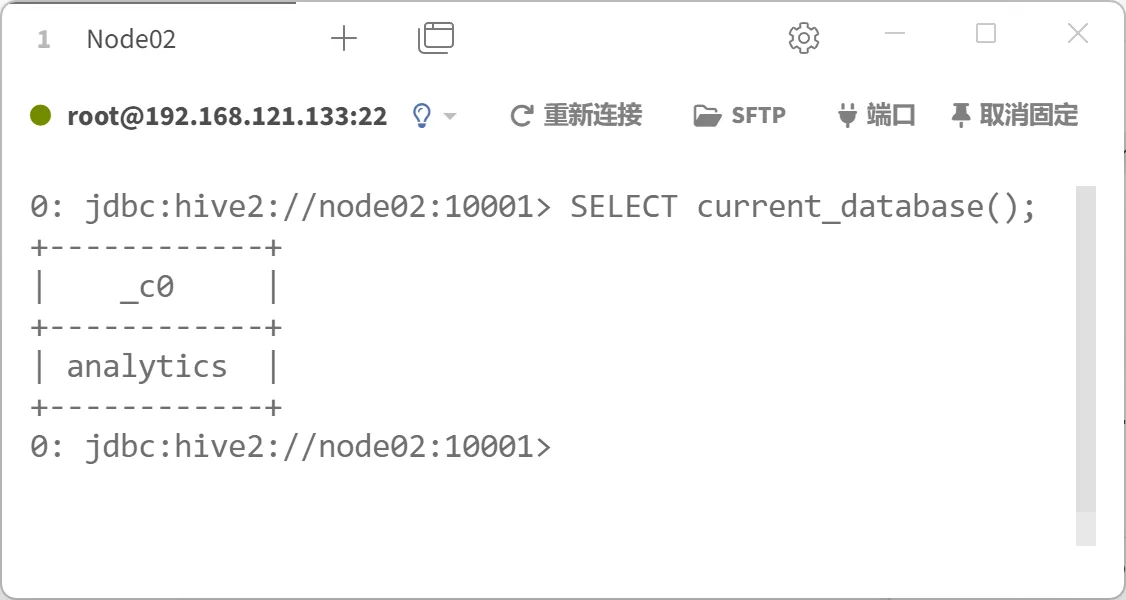
📄 展开课件原文(第 21–23 页,共 3 页)
修改数据库
了解数据库操作,能够使用HiveQL语句完成修改数据库的操作。
ALTER DATABASE db_name SET DBPROPERTIES (property_name=property_value,...);
ALTER DATABASE db_name SET OWNER user;
ALTER DATABASE db_name SET LOCATION hdfs_path;
ALTER DATABASE db_name SET MANAGEDLOCATION hdfs_path;
数据库创建之后,随着业务需求或环境的变化,可能需要对数据库的相关信息进行调整。Hive支持修改数据库的属性、拥有者、根目录以及内部表的存储路径,语法格式如下。
语法格式
修改数据库属性
修改数据库拥有者
修改数据库在HDFS上的根目录
修改数据库中内部表的存储路径
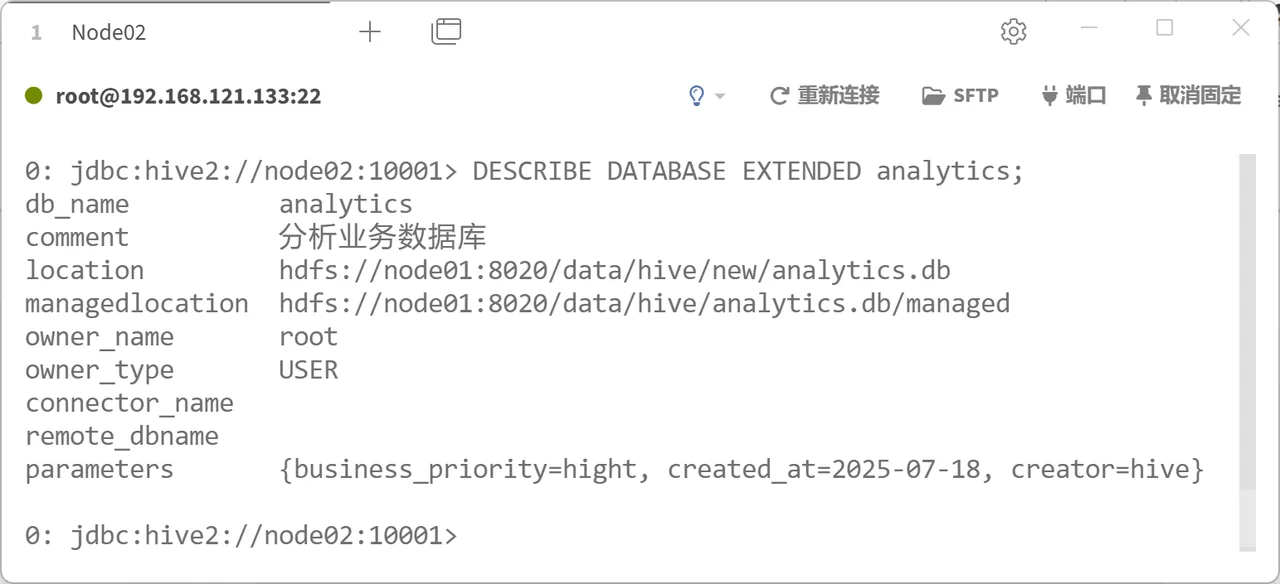
接下来,将演示如何在Hive中修改数据库的属性和根目录,操作步骤如下。
▸ 课件步骤 01
将analytics数据库中,属性名称为creator的属性值修改为hive,并添加一个属性名称为business_priority且属性值为hight的属性,具体HiveQL语句如下。
ALTER DATABASE analytics SET DBPROPERTIES ('creator'='hive',
'business_priority'='hight'
);▸ 课件步骤 02
将analytics数据库在HDFS上的根目录修改为/data/hive/new/analytics.db,具体HiveQL语句如下。
ALTER DATABASE analytics SET LOCATION '/data/hive/new/analytics.db';▸ 课件步骤 03
查看analytics数据库的信息,确认属性和根目录是否修改成功,如图。
📄 展开课件原文(第 24–29 页,共 6 页)
删除数据库
了解数据库操作,能够使用HiveQL语句完成删除数据库的操作。
DROP DATABASE [IF EXISTS] db_name [RESTRICT|CASCADE];当数据库不再使用或需要清理资源时,用户需要执行数据库删除操作。删除数据库操作涉及到较高的风险,尤其是在生产环境下需要慎重进行。在Hive中删除数据库的语法格式如下。
语法格式
用于删除数据库
用于在删除数据库前进行存在性判断
表示数据库不为空时,删除操作将失败
表示删除数据库的同时一并删除该数据库包含的所有表
案例
接下来,将演示如何在Hive中删除analytics数据库,具体HiveQL语句如下。
DROP DATABASE IF EXISTS analytics;上述命令执行完成后,查询Hive中所有数据库的效果如图。
任务:管理表
3.2
📄 展开课件原文(第 30–33 页,共 4 页)
3.2 管理表
分析CREATE TABLE语句
掌握表操作,能够熟练CREATE TABLE语句的语法。
在Hive中,系统默认提供一个名为default的数据库供用户使用。不过,在实际应用中,通常需要根据具体的业务需求创建对应的数据库,以实现更清晰的数据组织。在Hive中创建数据库的语法格式如下。
点击查看
TEMPORARY关键字为可选,用于创建临时表。
1. TEMPORARY 关键字
EXTERNAL关键字为可选,用于创建外部表。若未指定该关键字,默认创建的是内部表。
2. EXTERNAL 关键字
IF NOT EXISTS子句为可选,用于在创建表前进行存在性判断。当使用该子句时,若表所在数据库中已存在同名的表、视图或物化视图,则不会报错,而是跳过创建操作,从而避免触发异常。不过,在创建临时表时,IF NOT EXISTS子句仅用于判断是否存在同名的临时表。
3. IF NOT EXISTS子句
db_name参数为可选,用于指定数据库的名称,表示在该数据库中创建表。若未指定,则表将创建在当前使用的数据库中。
4. db_name 参数
table_name参数用于指定表的名称。
5. table_name 参数
col_name参数用于指定字段的名称。
6. col_name 参数
data_type参数用于指定字段的数据类型。
7. data_type 参数
column_constraint参数为可选,用于指定字段的约束条件。
下面主要介绍NOT NULL和DEFAULT约束。
NOT NULL表示字段值不能为空。
DEFAULT表示为字段指定默认值,其语法格式如下。
DEFAULT default_value用于指定默认值
8. db_name 参数
COMMENT子句为可选,用于为字段或表添加描述信息。col_comment和table_comment参数分别用于定义字段和表的描述内容。
9. COMMENT 子句
table_constraint参数为可选,用于指定表的约束条件。目前,Hive中所有表的约束均为软约束。
10. table_constraint参数
PARTITIONED BY子句为可选,用于为表指定分区。
11. table_constraint参数
CLUSTERED BY子句为可选,用于为表指定分桶。
12. CLUSTERED BY 子句
SKEWED BY子句为可选,用于处理数据倾斜问题,通过对指定字段的特定取值进行优化处理,以提升查询性能。参数col_name和col_value分别用于指定倾斜字段及其倾斜取值。当倾斜字段为单个字段时,可对应一个或多个倾斜取值;当倾斜字段为多个字段的组合时,每组倾斜取值应与字段一一对应。STORED AS DIRECTORIES(可选)子句表示Hive在HDFS上为每个倾斜值或组合单独创建目录。若未指定该子句,则所有数据仍写入表的目录中。
13. SKEWED BY 子句
ROW FORMAT子句为可选,用于指定表中每行数据的序列化与反序列化(Serialization Deserialization,简称SerDe)方式。序列化是指Hive在插入数据时,将表中字段值转换为符合目标文件格式的数据,写入HDFS;反序列化是指Hive在读取数据时,将HDFS上的数据文件解析为表中各字段的值。
14. ROW FORMAT 子句
用户可根据实际数据格式,通过ROW FORMAT子句设定序列化与反序列化的方式。Hive支持原生SerDe和自定义SerDe两种模式用于对数据进行序列化与反序列化,具体介绍如下。
(1)原生SerDe是默认模式,它通过指定字段、键值对、行等分隔符来解析数据结构,其语法格式如下。
ROW FORMAT DELIMITED
[FIELDS TERMINATED BY char [ESCAPED BY char]]
[COLLECTION ITEMS TERMINATED BY char]
[MAP KEYS TERMINATED BY char]
[LINES TERMINATED BY char]
[NULL DEFINED AS char]
用于指定转义字符,用于在字段值中保留分隔符本身,默认值为空
用于指定ARRAY、MAP和STRUCT类型中元素之间的分隔符,默认值为\002
用于指定MAP类型中键和值之间的分隔符,默认为\003
用于指定行的分隔符,默认值为\n
用于指定哪些字符串表示NULL值,默认值为\N
关于使用原生SerDe模式的示例代码如下。
基本格式
(2)自定义SerDe模式适用于复杂或非结构化格式的数据。通过指定Java实现类的全限定名及属性来解析数据,其语法格式如下。
SERDE serde_name [WITH SERDEPROPERTIES (property_name=property_value,...)]用于指定SerDe对应Java实现类的全限定名
用于指定SerDe所需的属性
接下来,针对三种常用自定义SerDe的介绍。
RegexSerDe
A
JsonSerDe
B
CSVSerDe
C
RegexSerDe通过正则表达式对文本数据进行解析,适用于格式灵活但结构可通过模式捕获的文本行。RegexSerDe的解析过程包括模式匹配和捕获组映射,其中模式匹配是指每行文本需完全匹配指定正则表达式,否则该行返回NULL;捕获组映射是指正则表达式中的捕获组按顺序映射至表的字段,捕获组数量必须与表的字段数一致。捕获组是指正则表达式中用圆括号定义的部分。
JsonSerDe用于解析JSON格式的数据。默认情况下,当JSON中的键名与表的字段名匹配(大小写不敏感)时,会自动映射。从Hive 3.0开始,JsonSerDe对应Java实现类的全限定名为org.apache.hadoop.hive.serde2.JsonSerDe。关于使用JsonSerDe的程序结构如下。
ROW FORMAT SERDE 'org.apache.hadoop.hive.serde2.JsonSerDe'CSVSerDe用于解析CSV(逗号分隔值)格式的数据,对应Java实现类的全限定名为org.apache.hadoop.hive.serde2.OpenCSVSerde,常用属性如下。
field.delim:
quoteChar:
escapeCha:
用于指定转义字符。
用于指定字段之间的分隔符。
用于指定引用符。
skip.header.line.count:
用于指定从文件开头跳过的行数
关于使用CSVSerDe的程序结构如下。
ROW FORMAT SERDE 'org.apache.hadoop.hive.serde2.OpenCSVSerde'WITH SERDEPROPERTIES ('field.delim' = '\t',
'quoteChar' = "'",
'escapeChar' = '\\',
'skip.header.line.count' = '1'
)
STORED AS(可选)子句用于指定表在HDFS上存储数据时采用的文件格式。Hive支持的文件格式如表。
15. STORED AS 子句
| 文件格式 | 存储方式 | 介绍 |
|---|---|---|
| TEXTFILE | 行式存储 | TEXTFILE是Hive默认的文件格式,采用纯文本形式存储数据,每行表示一条记录 |
| SEQUENCEFILE | 行式存储 | SEQUENCEFILE是Hadoop原生的二进制文件格式,采用键值对形式存储数据 |
| RCFILE | 行列混合存储 | RCFILE是Hive早期推出的文件格式,将数据按行分组后再按列存储 |
| ORC | 列式存储 | ORC是Hive推出的高性能文件格式 |
| 文件格式 | 存储方式 | 介绍 |
|---|---|---|
| PARQUET | 列式存储 | PARQUET是一种跨平台的文件格式,支持复杂嵌套结构,兼容Spark、Impala等多种大数据框架 |
| AVRO | 行式存储 | AVRO是一种基于二进制的、带模式定义的数据序列化格式 |
| JSONFILE | 行式存储 | JSONFILE是Hive 4.0新增的文件格式,用于直接存储JSON数据 |
| 自定义格式 | 视实现而定 | Hive支持用户通过INPUTFORMAT和OUTPUTFORMAT指定自定义格式,开发者可实现特定的读写逻辑以满足特殊场景需求。 语法格式如下: INPUTFORMAT input_classname OUTPUTFORMAT output_classname input_classname和output_classname分别用于指定读写数据的Java类全限定名。 |
Hive中的数据存储方式主要分为行式存储与列式存储两类,具体介绍如下。
1.行式存储以记录为单位。
2.将每行的所有字段顺序写入磁盘。
3.写入逻辑简单,适用于日志落地、流式写入或批量追加等场景。
行式存储
列式存储
1. 列式存储以字段为单位。
2.将同一字段的数据连续存储,通常先将多行数据聚合为数据块,再在数据块内按字段划分。
3. 适配以全表扫描为主的分析型查询。
16. LOCATION 子句
LOCATION(可选)子句用于指定表在HDFS中的数据存储目录,其中参数hdfs_path用于定义目标路径。该子句通常与外部表配合使用。如果指定的目录中已存在数据文件,且其格式符合表定义的解析规则,则这些数据会被直接加载到表中。
TBLPROPERTIES(可选)子句用于为表添加属性。参数property_name和property_value分别用于定义属性名称和属性值。用户既可自定义属性,也可使用预定义属性。建议对属性名称和属性值均使用单引号包裹,以确保语法兼容性与解析准确性。
17. TBLPROPERTIES 子句
关于Hive常用预定义属性的介绍如表。
| 预定义属性 | 介绍 |
|---|---|
| comment | 用于为表添加描述信息,等价于COMMENT子句 |
| hbase.table.name | 用于将Hive表映射到指定的HBase表,实现通过Hive操作HBase中的数据。属性值用于指定HBase表的名称 |
| immutable | 用于标识表是否为不可变表。当不可变表已存在数据时,不支持后续的插入数据操作。 默认值为FALSE。若设为TRUE,则将表标识为不可变表 |
| 预定义属性 | 介绍 |
|---|---|
| orc.compress | 用于指定ORC文件格式的数据压缩算法。默认值为ZLIB,可选值包括NONE、ZSTD、SNAPPY、LZO和LZ4 |
| transactional | 用于控制表是否启用事务支持。默认值为FALSE。当将其设置为TRUE,表示启用事务支持,所创建的表即为事务表(ACID表) |
| NO_AUTO_COMPACTION | 用于控制事务表是否禁用自动触发Minor Compaction和Major Compaction。默认值为FALSE。若设为TRUE,则禁用自动触发,需要用户手动触发 |
| compactor.mapreduce.map.memory.mb | 用于指定在执行合并任务时,Map任务所分配的内存大小。默认值依赖于Hadoop的相关配置 |
| 预定义属性 | 介绍 |
|---|---|
| compactorthreshold.hive.compactor.delta.num.threshold | 用于设置自动触发Minor Compaction的增量文件数量,默认值为10 |
| compactorthreshold.hive.compactor.delta.pct.threshold | 用于设置自动触发Major Compaction的增量文件大小占基础文件大小的百分比阈值,默认值为0.1 |
| auto.purge | 用于控制删除表、删除分区、清空表或覆盖插入时,是否跳过HDFS回收站,直接删除数据文件。默认值为FALSE。若设为TRUE,则直接删除数据文件 |
| external.table.purge | Hive 4.0新增属性,控制删除外部表时是否一并删除其对应的数据文件。默认值为FALSE。若设为TRUE,则删除表的同时删除其对应的数据文件 |
18. AS(可选) 子句
AS子句用于在创建表时,通过执行指定的SELECT语句,将查询结果直接作为表的数据进行加载。常用于基于已有数据快速创建并初始化新表,实现建表与数据填充的合并操作。
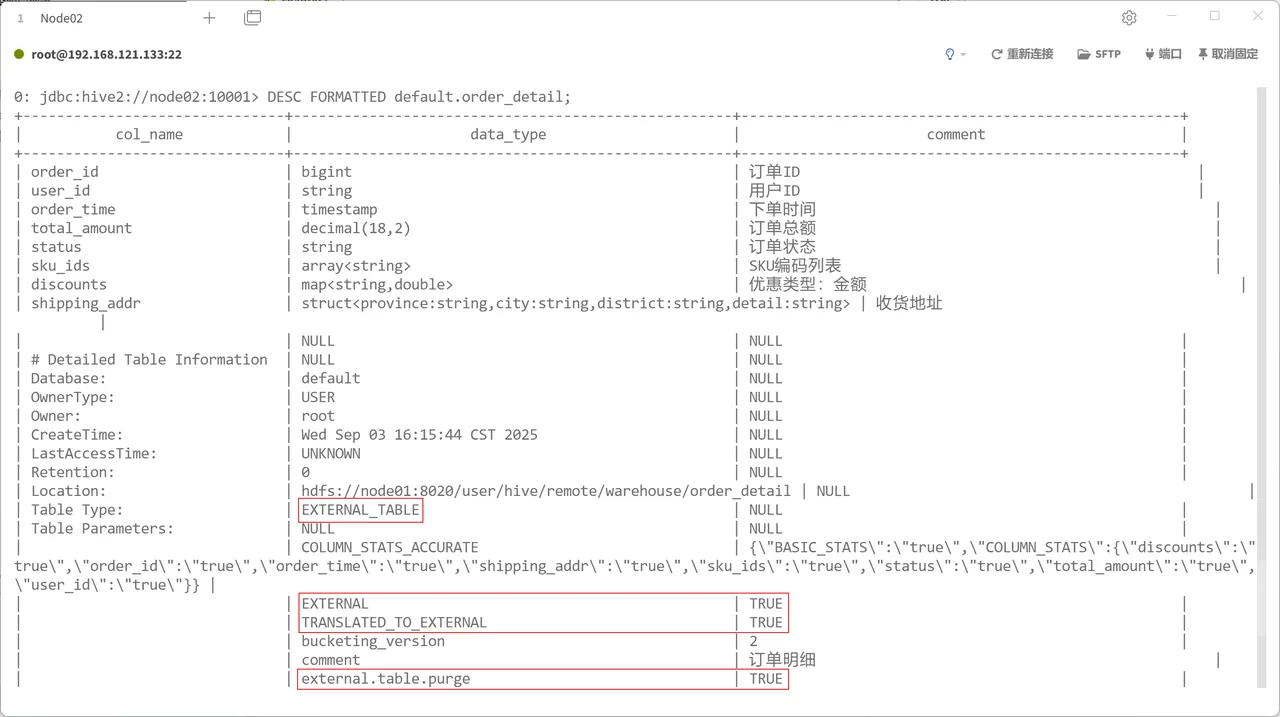
在Hive 4.1.0中,若创建的内部表未启用事务支持,系统会默认将其转换为外部表,并将属性external.table.purge设为TRUE,以保持删除行为与内部表一致,即在删除元数据的同时删除对应的数据文件。
内部表转换为外部表
把 CREATE TABLE 的每个子句都落到一个真实例子上。
CREATE EXTERNAL TABLE IF NOT EXISTS school.ext_student(   -- ① 建什么
    stu_id   STRING COMMENT '学生id',                        -- ② 字段与类型
    stu_name STRING COMMENT '姓名'
)
COMMENT '学生外部表'                                          -- ③ 表注释
PARTITIONED BY (dt STRING)                                   -- ④ 分区
ROW FORMAT DELIMITED FIELDS TERMINATED BY ','                -- ⑤ 分隔符
STORED AS TEXTFILE                                           -- ⑥ 文件格式
LOCATION '/user/hadoop/student'                              -- ⑦ 数据目录
TBLPROPERTIES ('skip.header.line.count' = '1');              -- ⑧ 跳过表头
💡 写建表语句按这八块顺序检查,基本不会漏子句;EXTERNAL + LOCATION 常常成对出现。
📄 展开课件原文(第 34–59 页,共 26 页)
创建表
掌握表操作,能够熟练使用HiveQL语句实现表的创建。
通过上一节的学习,读者已对Hive中的建表语句CREATE TABLE有了初步了解。本节将进一步演示Hive中创建表的基本操作,包括内部表与外部表的创建。
在MySQL中构建Hive运行所需的元数据表结构时,系统默认将表的字符集设置为latin1。这将导致当用户在Hive中创建表并指定中文描述信息或属性时,出现乱码问题。为解决该问题,需要在MySQL中存储Hive元数据的remote数据库执行如下操作。
(1)COLUMNS_V2表中的COMMENT字段用于存储Hive表中字段的描述信息。因此,需要将COMMENT字段的字符集和排序规则修改为utf8mb4和utf8mb4_unicode_ci,以确保中文内容能够正常存储与显示。在虚拟机Node03中使用root用户登录MySQL,在MySQL命令行界面执行如下命令。
ALTER TABLE remote.COLUMNS_V2MODIFY COLUMN `COMMENT` VARCHAR(4000)
CHARACTER SET utf8mb4
COLLATE utf8mb4_unicode_ci;(2)TABLE_PARAMS表中的PARAM_KEY字段用于存储表的属性名称,PARAM_VALUE字段用于存储表的属性值和描述信息。因此,需要将这两个字段的字符集和排序规则修改为utf8mb4和utf8mb4_unicode_ci,以确保中文内容能够正常存储与显示。在虚拟机Node03中使用root用户登录MySQL,在MySQL命令行界面执行如下命令。
ALTER TABLE remote.TABLE_PARAMSMODIFY COLUMN `PARAM_KEY` VARCHAR(256) CHARACTER SET utf8mb4 COLLATE utf8mb4_unicode_ci,
MODIFY COLUMN `PARAM_VALUE` mediumtext CHARACTER SET utf8mb4 COLLATE utf8mb4_unicode_ci;(3)PARTITION_KEYS表中的PKEY_COMMENT字段用于存储Hive表中分区字段的描述信息。因此,需要将PKEY_COMMENT字段的字符集和排序规则修改为utf8mb4和utf8mb4_unicode_ci,以确保中文内容能够正常存储与显示。在虚拟机Node03中使用root用户登录MySQL,在MySQL命令行界面执行如下命令。
ALTER TABLE remote.PARTITION_KEYSMODIFY COLUMN `PKEY_COMMENT` VARCHAR(4000)接下来,演示如何在Hive中创建内部表和外部表,具体内容如下。
(1)在Hive的default数据库中创建名为order_detail的内部表,具体HiveQL语句如下。
点击查看
(2)在Hive的default数据库中创建名为click_log的外部表,具体HiveQL语句如下。
先建一张表,再把数据放进去、查出来——建表之后一定要验证。
CREATE TABLE IF NOT EXISTS school.student_info(
    stu_id STRING, stu_name STRING, birthday STRING, sex STRING
)
ROW FORMAT DELIMITED FIELDS TERMINATED BY ','
STORED AS TEXTFILE;

LOAD DATA LOCAL INPATH '/home/hadoop/shell/data/student_info.txt' INTO TABLE school.student_info;

SELECT * FROM school.student_info LIMIT 3;| stu_id | stu_name | birthday | sex |
|---|---|---|---|
| 001 | 彭于晏 | 1995-05-16 | 男 |
| 002 | 胡歌 | 1994-03-20 | 男 |
| 003 | 周杰伦 | 1995-04-30 | 男 |
💡 建完表用 DESC FORMATTED 看结构,用 SELECT … LIMIT 看数据,是最快的自检方式。
📄 展开课件原文(第 60–68 页,共 9 页)
查询表
掌握表操作,能够熟练使用HiveQL语句实现表的查询操作。
语法格式
在实际使用Hive的过程中,用户常常需要查询数据库中已有的表,以便快速定位数据,支持后续的分析或管理操作。通过查询表,用户可以快速获取数据库中表的名称列表。在Hive中查询表的语法格式如下。
SHOW TABLES [IN db_name] [pattern];用于在Hive中查询表
用于查询指定数据库中已有的表
用于指定数据库名称
用于指定表名的匹配模式
案例
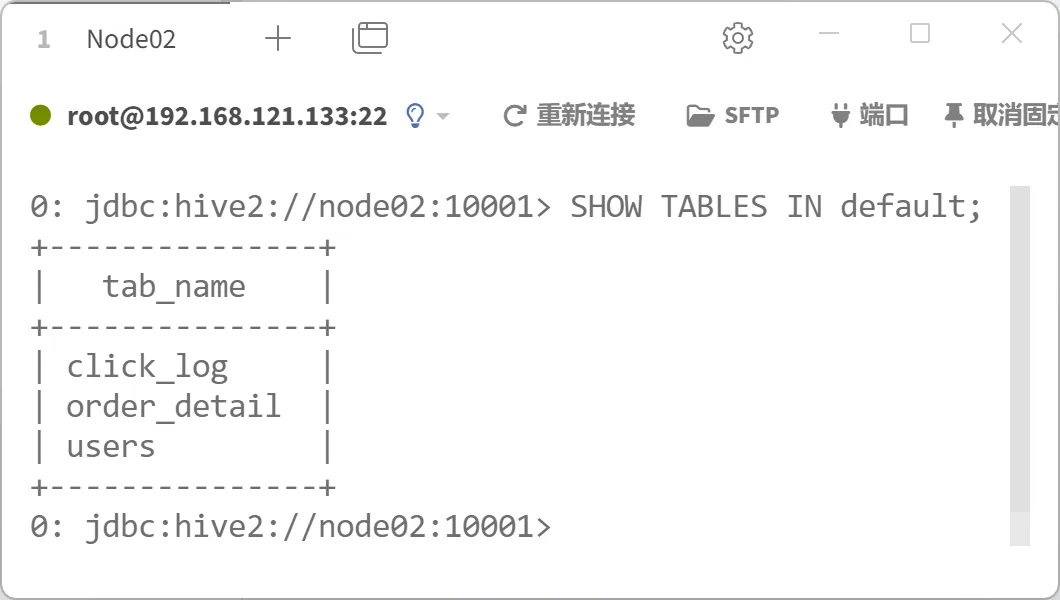
接下来,演示如何查询default数据库中所有表的名称,具体HiveQL语句如下。
SHOW TABLES IN default;上述命令执行完成后的效果如图。
📄 展开课件原文(第 69–71 页,共 3 页)
查询表信息
掌握表操作,能够熟练使用HiveQL语句实现表查询信息的操作。
语法格式
为了深入了解某个表的详细信息,例如表结构、字段类型、存储格式、分区字段、分桶信息等,用户可使用查看表信息的命令查看指定表的元数据。在Hive中查看表信息的语法格式如下。
DESC [EXTENDED|FORMATTED] [db_name.]table_name;用于在Hive中查看表信息
若指定EXTENDED关键字时,将以扩展模式显示表信息
若指定FORMATTED关键字时,将以格式化模式展示表的完整信息
案例
接下来,演示如何通过格式化模式查看default数据库中order_detail表的信息,具体HiveQL语句如下。
DESC FORMATTED default.order_detail;上述命令执行完成后的效果如图。
查看建表语句
Hive提供SHOW CREATE TABLE语句,用于查看指定表的完整建表语句,便于在其他环境中重建表结构,其语法格式如下。
SHOW CREATE TABLE [db_name.]table_name;用于查看视图的完整创建语句,只需将上述语法格式中的table_name替换为视图名称即可
📄 展开课件原文(第 72–75 页,共 4 页)
修改表
掌握表操作,能够熟练使用HiveQL语句实现修改表的操作。
随着业务的持续发展,用户往往需要根据实际需求对表的结构或属性进行调整,以更好地支持新的业务场景。接下来,将重点介绍如何修改表名、属性以及字段操作。
修改表名
A
修改表属性
B
字段操作
C
在数据仓库迭代过程中,随着业务含义的变化,旧表名可能已不准确,需要及时调整。自Hive 2.2.0起,修改外部表的表名仅更新元数据,不会更改其在HDFS中存储数据的目录。而当修改内部表的表名时,若未通过LOCATION子句显式指定目录,且数据存储目录位于数据库默认的根目录,则不仅更新元数据,还会同步重命名对应的HDFS目录。
1. 修改表名
语法格式
在Hive中修改表名的语法格式如下。
ALTER TABLE [db_name.]table_name RENAME TO [db_name.]new_table_name;用于在Hive中修改表
用于修改表名
用于指定旧表名
用于指定新表名
案例
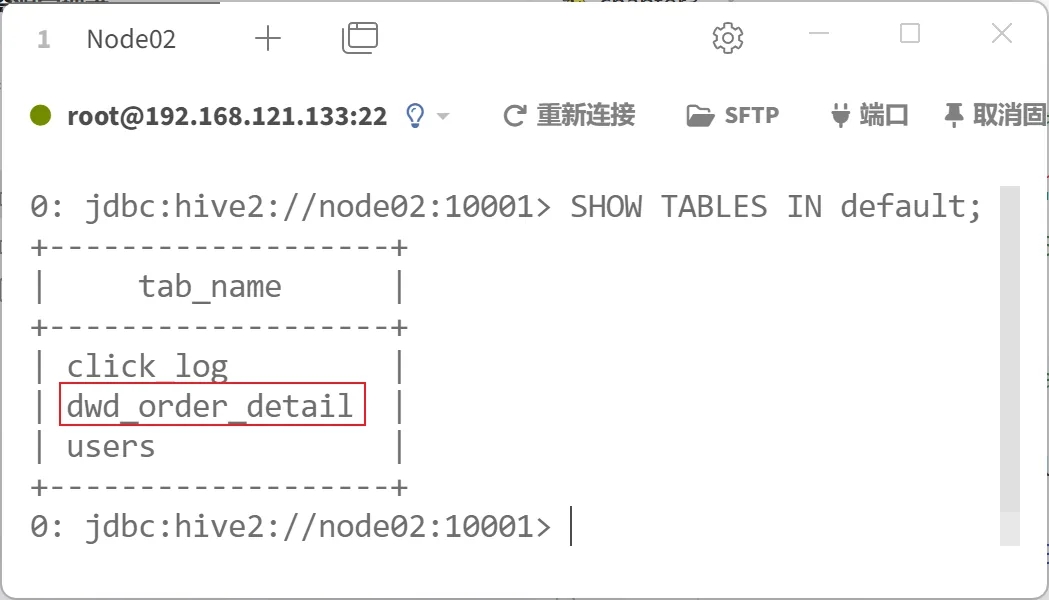
接下来,演示如何将default数据库中order_detail表的名称修改为dwd_order_detail,具体HiveQL语句如下。
ALTER TABLE default.order_detail RENAME TO default.dwd_order_detail;上述命令执行完成后,查询default数据库中所有表的名称,如图。
表的定义不仅取决于字段,还依赖一系列表属性,以描述其存储特性与运行行为。然而,业务需求并非一成不变。随着数据量增长、分析场景变化或执行引擎升级,原有表属性可能不再适用。
2. 修改表属性
在Hive中修改表属性的语法格式如下。
ALTER TABLE [db_name.]table_name
SET TBLPROPERTIES (property_name=property_value,...);
SET TBLPROPERTIES子句用于修改表属性
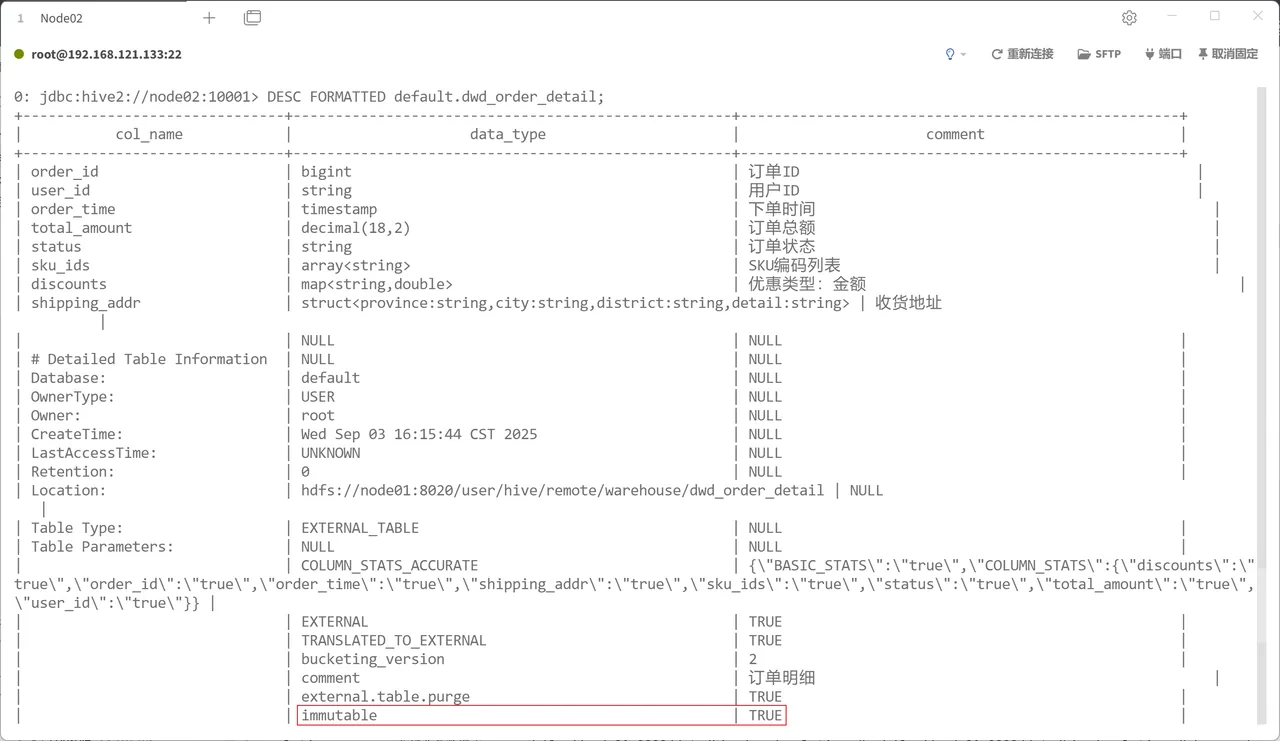
接下来,演示如何将default数据库中dwd_order_detail表的immutable属性设为TRUE,将其标识为不可变表,具体HiveQL语句如下。
ALTER TABLE default.dwd_order_detail SET TBLPROPERTIES ('immutable'='TRUE');上述命令执行完成后,通过格式化模式查看default数据库中dwd_order_detail表的信息,如图。
在数据仓库的生命周期中,表结构定义会随业务需求的变化而演进。最初的字段设计可能只为特定任务服务,但在后续的数据处理与分析过程中,常会发现字段定义存在不足。例如,有些字段需要重命名以提升可读性;有些字段需要调整数据类型以适配新的数据格式;还有些场景需要在表中新增字段,以匹配最新的数据模型。
3. 字段操作
接下来,将主要介绍修改表字段和添加表字段的语法格式,具体内容如下。
(1)在Hive中修改表字段的语法格式如下。
ALTER TABLE [db_name.]table_name CHANGE col_old_name col_new_name data_type [COMMENT col_comment] [FIRST|AFTER column_name];用于修改表字段
用于指定原字段名
用于指定新的字段名
用于指定新字段的数据类型
用于重新定义字段的描述信息
用于将新字段置为表的首个字段
用于将新字段置为指定字段column_name之后
接下来,演示如何对default数据库中dwd_order_detail表的字段进行修改,具体HiveQL语句如下。
ALTER TABLE default.dwd_order_detail CHANGE order_id orderid STRING AFTER user_id;上述语句将order_id字段的名称和数据类型分别修改为orderid和STRING,并将其置为user_id字段之后。
上述命令执行完成后,通过简略模式查看default数据库中dwd_order_detail表的信息,如图。
(2)在Hive中添加表字段的语法格式如下。
ALTER TABLE [db_name.]table_name ADD COLUMNS (col_name data_type [COMMENT col_comment],...)用于在表的末尾新增字段
接下来,演示如何向default数据库中的dwd_order_detail表新增字段,具体HiveQL语句如下。
ALTER TABLE default.dwd_order_detail
ADD COLUMNS (
shipping_fee DECIMAL(18, 2) COMMENT '运费',
pay_method STRING COMMENT '支付方式'
);上述语句在dwd_order_detail表中新增shipping_fee和pay_method字段。
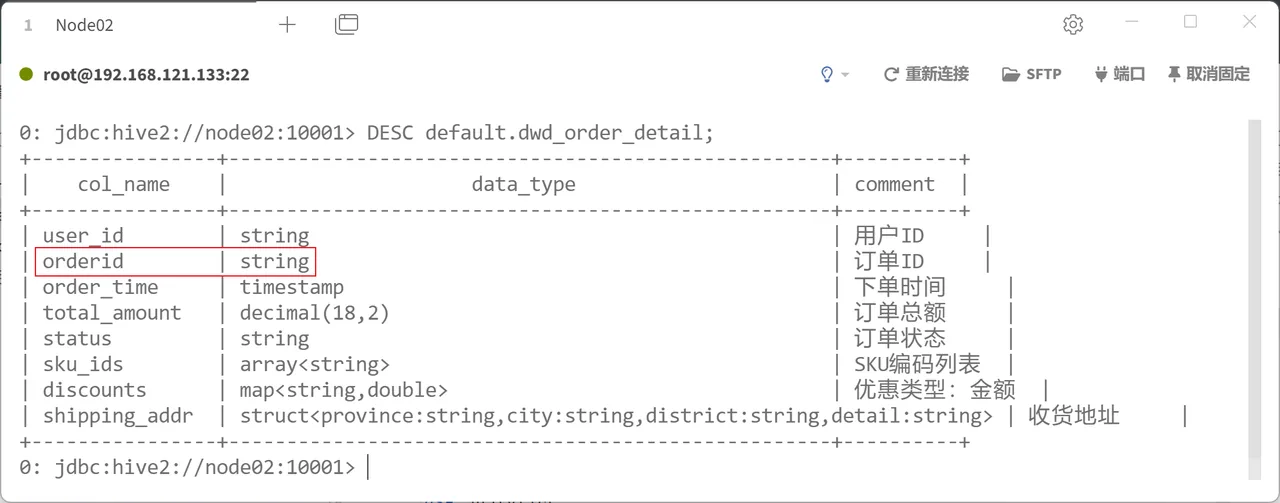
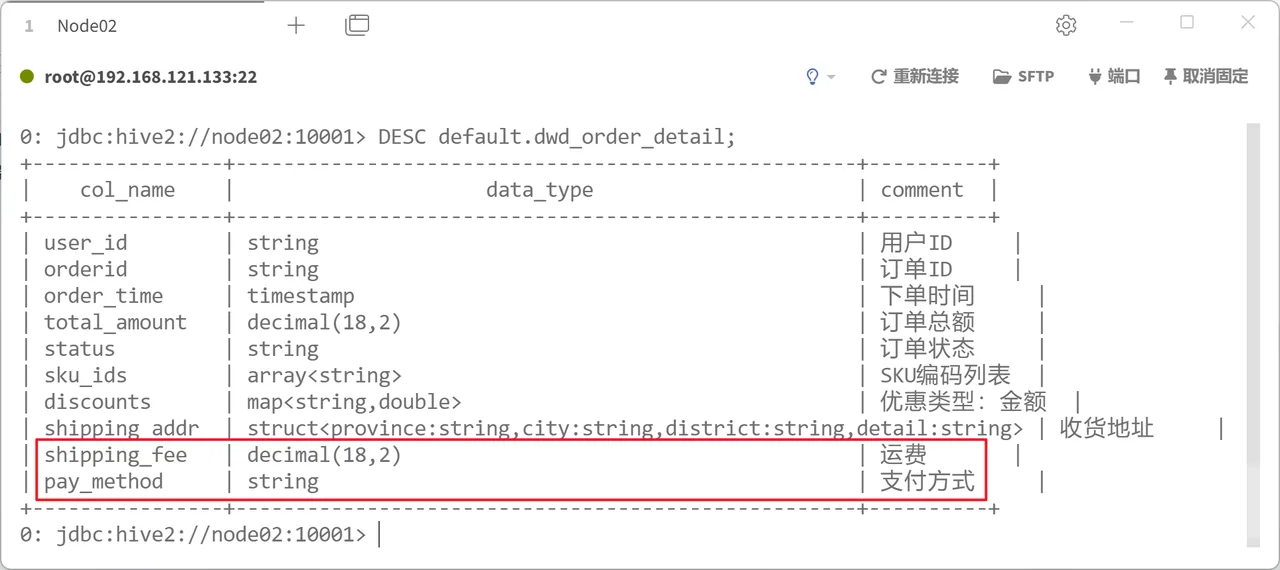
改表名、加字段、改字段类型、改注释。
ALTER TABLE student_info RENAME TO student_info_bak;      -- 改表名
ALTER TABLE student_info_bak ADD COLUMNS (class_id STRING COMMENT '班级');  -- 加字段
ALTER TABLE student_info_bak CHANGE sex gender STRING COMMENT '性别';        -- 改字段名/类型
ALTER TABLE student_info_bak SET TBLPROPERTIES ('comment' = '学生信息(备份)');
💡 加字段只能加在末尾(分区列之前);改字段类型属于元数据变更,已有数据不会自动转换。
📄 展开课件原文(第 76–91 页,共 16 页)
删除表
掌握表操作,能够熟练使用HiveQL语句实现表的删除操作。
在数据仓库的建设与维护过程中,表的生命周期并非永久存在。随着业务流程的调整、数据模型的迭代或历史数据的清理需求出现,一些表可能不再具有实际价值。为了避免无效表占用存储空间、增加元数据管理负担,我们需要对不再使用的表进行删除操作。
语法格式
在Hive中删除表的语法格式如下。
DROP TABLE [IF EXISTS] [db_name.]table_name [PURGE];用于删除表
用于在删除表前进行存在性判断
用于在删除表及其数据时,决定是否跳过将删除的数据移动至HDFS的回收站
案例
接下来,演示如何删除default数据库中的dwd_order_detail表,具体HiveQL语句如下。
DROP TABLE IF EXISTS default.dwd_order_detail;上述命令执行完成后,查询default数据库中所有表的名称,如图。
HDFS回收站
在HDFS中,文件一旦删除,若无额外保护会立即移除,且无法通过常规手段恢复。这在生产环境中风险较大,一次误操作可能导致关键数据永久丢失。为降低此类风险,HDFS提供了回收站机制,用于在文件删除后提供一段缓冲期,便于用户在限定时间内进行恢复。
当用户在HDFS执行删除操作且回收站已开启时,文件不会被立刻删除,而会被移动到回收站目录,通常路径为/user/<username>/.Trash/Current(<username>为执行操作的用户)。回收站中的文件会保留一段时间,期满后系统会自动清理以释放存储空间。用户可在回收站有效期内手动将文件恢复到原始位置,从而避免误删造成的损失。
在HDFS中,回收站需要显式开启。用户需要在Hadoop的core-site.xml配置文件中添加如下配置。
<property>
<name>fs.trash.interval</name>
<value>1440</value>
</property>
<name>fs.trash.checkpoint.interval</name>
<value>60</value>
开启回收站并指定文件在回收站保留的时长(单位:分钟)
生成回收站检查点的间隔(单位:分钟),建议小于保留的时长
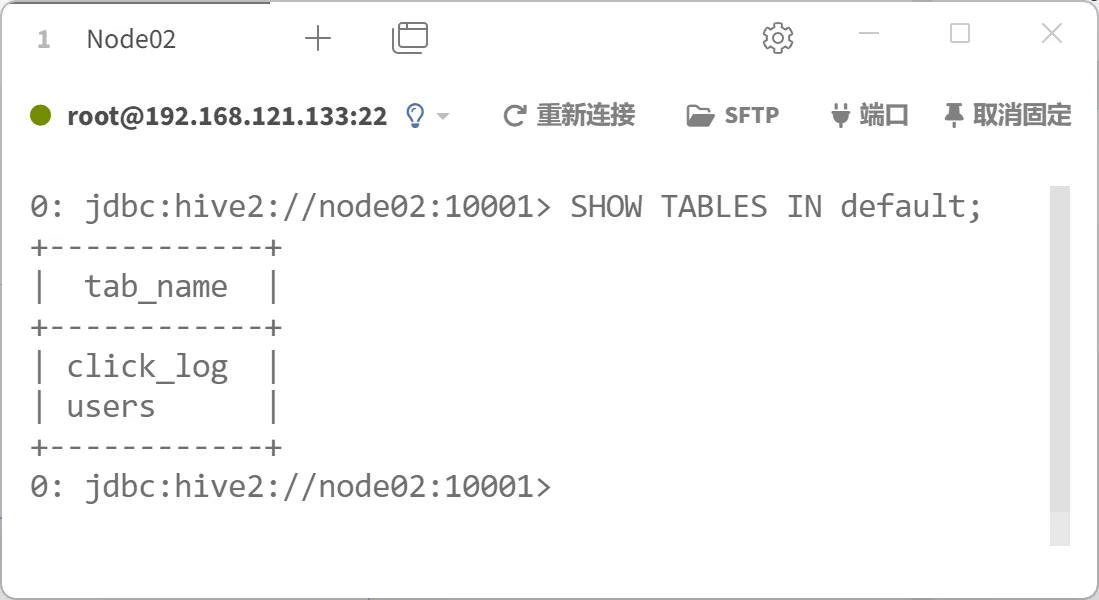
删表前先确认是内部表还是外部表——这决定了数据会不会一起没。
DROP TABLE IF EXISTS student_info_bak;        -- 内部表:元数据 + 数据一起删
DROP TABLE IF EXISTS ext_student;             -- 外部表:只删元数据,HDFS 文件保留
SHOW TABLES;
💡 IF EXISTS 保证表不存在时不报错,脚本里建议都带上。
📄 展开课件原文(第 92–97 页,共 6 页)
清空表
掌握表操作,能够熟练使用HiveQL语句实现表的清空操作。
清空表是指在保留表结构的前提下删除所有数据。与直接删除表不同,清空表不会移除元数据,因此操作后表仍然存在,可立即重新插入数据。这种方式比重新建表更高效,尤其适用于大数据量表的重置。
语法格式
在Hive中清空表的语法格式如下。
TRUNCATE [db_name.]table_name;用于清空表
需要注意的是,通过EXTERNAL关键字创建的外部表无法执行清空表操作。
案例
例如,对default数据库中的users表执行清空表操作的HiveQL语句如下。
TRUNCATE default.users;任务:管理分区
3.3
清空表数据但保留表结构。
TRUNCATE TABLE student_info;      -- 只清数据,结构还在
SELECT count(*) FROM student_info; -- 0
-- 注意:外部表不能 TRUNCATE
💡 清空后表目录还在,只是文件被删掉;想恢复只能重新加载。
📄 展开课件原文(第 98–102 页,共 5 页)
3.3 管理分区
创建分区表
掌握分区操作,能够熟练使用HiveQL语句创建分区表。
语法格式
在Hive中,定义了分区的表称为分区表。分区表的创建依赖于CREATE TABLE语句中的PARTITIONED BY子句,语法格式如下。
PARTITIONED BY (
col_name data_type [COMMENT col_comment],
col_name data_type [COMMENT col_comment],...
)
用于指定分区字段,它与实际存储数据的字段相互独立,且不能同名
用于指定分区字段的数据类型
用于定义分区字段的描述信息
接下来,演示如何在default数据库中创建分区表page_view,具体HiveQL语句如下。
CREATE TABLE IF NOT EXISTS default.page_view(viewTime INT,
userid BIGINT,
page_url STRING,
referrer_url STRING,ip STRINGdt STRING COMMENT '日期',
country STRING COMMENT '地区'
STORED AS SEQUENCEFILE;分区表属性
在Hive 4.0中,新增了两个适用于分区表的属性,用于实现分区自动发现和分区保留功能,具体介绍如下。
(1)discover.partitions属性用于启用分区自动发现功能。当该属性的值为true时,Hive会定期扫描HDFS中新出现或已被删除分区的目录,并将这些变动同步到元数据中,从而实现分区的自动更新。
(2)partition.retention.period属性用于启用分区保留功能。通过设置一个保留周期(如7d表示7天,1h表示1小时),Hive会自动删除创建时间超过该周期的旧分区及其数据。
建一张按课程分区的成绩表,并说明分区列为什么不在字段列表里。
CREATE TABLE IF NOT EXISTS school.score_part(
    stu_id STRING COMMENT '学生id',
    score  INT    COMMENT '成绩'
)
PARTITIONED BY (course_id STRING COMMENT '课程id')
ROW FORMAT DELIMITED FIELDS TERMINATED BY ','
STORED AS TEXTFILE;

-- 静态分区:手动指定分区值
LOAD DATA LOCAL INPATH '/home/hadoop/shell/data/score_01.txt'
INTO TABLE school.score_part PARTITION (course_id = '01');
💡 分区列是目录名(…/score_part/course_id=01/),所以不能重复写在字段里。
📄 展开课件原文(第 103–106 页,共 4 页)
添加分区
掌握分区操作,能够熟练使用HiveQL语句添加分区。
在分区表的日常管理中,添加分区是最常见的运维操作之一。随着业务增长,新的时间段、地域或业务类别的数据持续产生,这些数据需要以新的分区形式存储到HDFS。例如,对于按年份与月份分区的销售表,每到新的一月都需生成对应分区的目录,用于存放当月数据。
语法格式
为使分区表能通过指定分区的目录读取目标数据,必须先在元数据中注册该分区,这一过程称为添加分区。在Hive中添加分区的语法格式如下。
ALTER TABLE [db_name.]table_name ADD [IF NOT EXISTS]PARTITION (col=value[,col=value,...]) [LOCATION hdfs_path]
[PARTITION (col=value[,col=value,...]) [LOCATION hdfs_path]...];用于在添加分区前进行存在性判断
用于指定分区存储数据文件的路径
用于指定目标路径
HiveQL语句
接下来,演示如何为default数据库中的分区表page_view添加两个分区,具体HiveQL语句如下。
ALTER TABLE default.page_viewADD IF NOT EXISTSPARTITION (dt = '20250901', country = 'beijing')
PARTITION (dt = '20250903', country = 'beijing')
LOCATION '/data/page/view/dt=20250903/country=beijing';上述语句在分区表page_view中添加了两个分区,它们在HDFS存储数据文件的路径如下。
/user/hive/remote/warehouse/page_view/dt=20250901/country=beijing
/data/page/view/dt=20250903/country=beijing
📄 展开课件原文(第 107–111 页,共 5 页)
查询分区
掌握分区操作,能够熟练使用HiveQL语句查询分区。
在分区表的管理中,随着数据量与分区数增长,分区结构会日益复杂。对运维人员和数据分析师而言,清楚掌握表中已有分区是开展数据管理与查询优化的前提,这有助于精准构建查询条件,实现分区裁剪。
语法格式
在Hive中查询分区的语法格式如下。
SHOW PARTITIONS [db_name.]table_name
[PARTITION (col=value[,col=value,...])]
[WHERE where_condition]
[ORDER BY col_list]
[LIMIT rows];
用于在添加分区前进行存在性判断
用于查询特定分区下的子分区,适用于多级分区
用于通过条件过滤分区
用于按指定分区字段的值进行排序,支持升序和降序。
用于限制返回的分区数量,适用于分区数量较多的场景,以避免一次性返回所有分区。
案例
接下来,演示如何查询default数据库中分区表page_view的所有分区,具体HiveQL语句如下。
SHOW PARTITIONS default.page_view;上述命令执行完成后的效果如图。
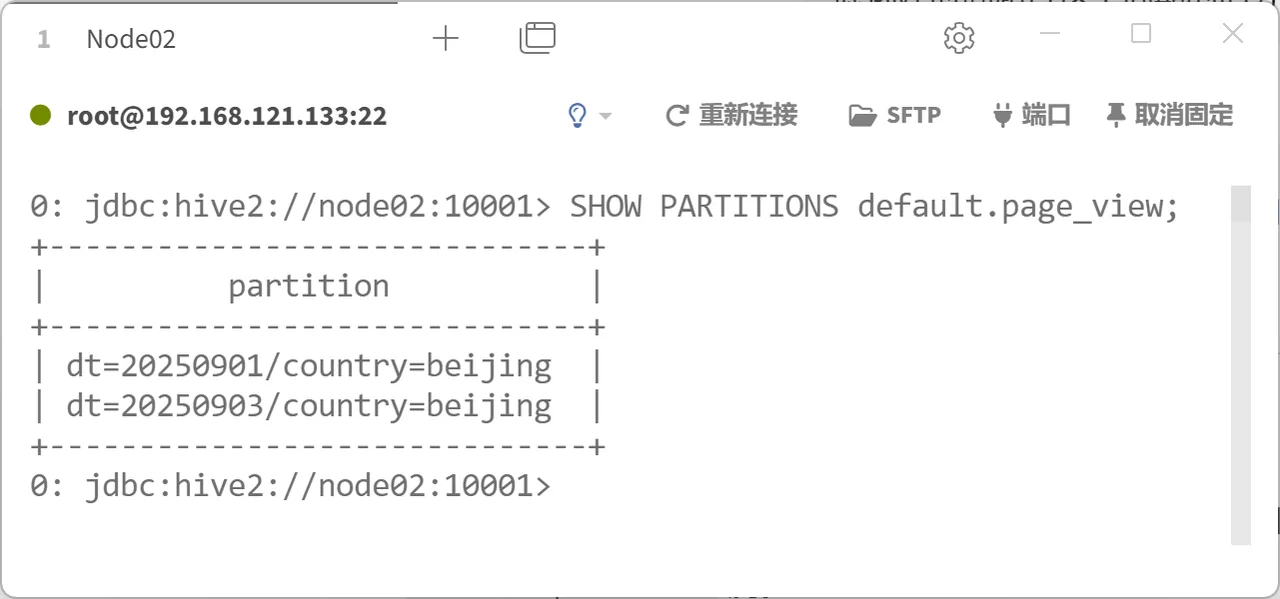
📄 展开课件原文(第 112–115 页,共 4 页)
重命名分区
掌握分区操作,能够熟练使用HiveQL语句重命名分区。
如果在创建分区表时未指定EXTERNAL关键字,那么重命名操作不仅会更新元数据,还会修改HDFS上对应目录的名称。此外,如果重命名的分区使用了LOCATION子句,那么重命名后Hive会根据分区字段取值的变化在表默认存储数据的目录下创建新的目录。
如果在创建分区表时指定EXTERNAL关键字,那么重命名分区只会更新元数据,不会修改HDFS上对应目录的名称。
重命名分区是指通过修改Hive元数据中分区字段的取值,以更新分区的名称。Hive会根据分区表在创建时是否指定EXTERNAL关键字,来决定在重命名分区时是否修改HDFS上的目录,具体说明如下。
语法格式
在Hive中重命名分区的语法格式如下。
ALTER TABLE [db_name.]table_namePARTITION (col=old_value[,col=old_value,...])
RENAME TO PARTITION (col=new_value[,col=new_value,...]);用于重命名分区
用于指定分区字段的原始取值
用于指定分区字段的新取值
案例
接下来,演示如何对default数据库中分区表page_view的分区进行重命名操作,具体HiveQL语句如下。
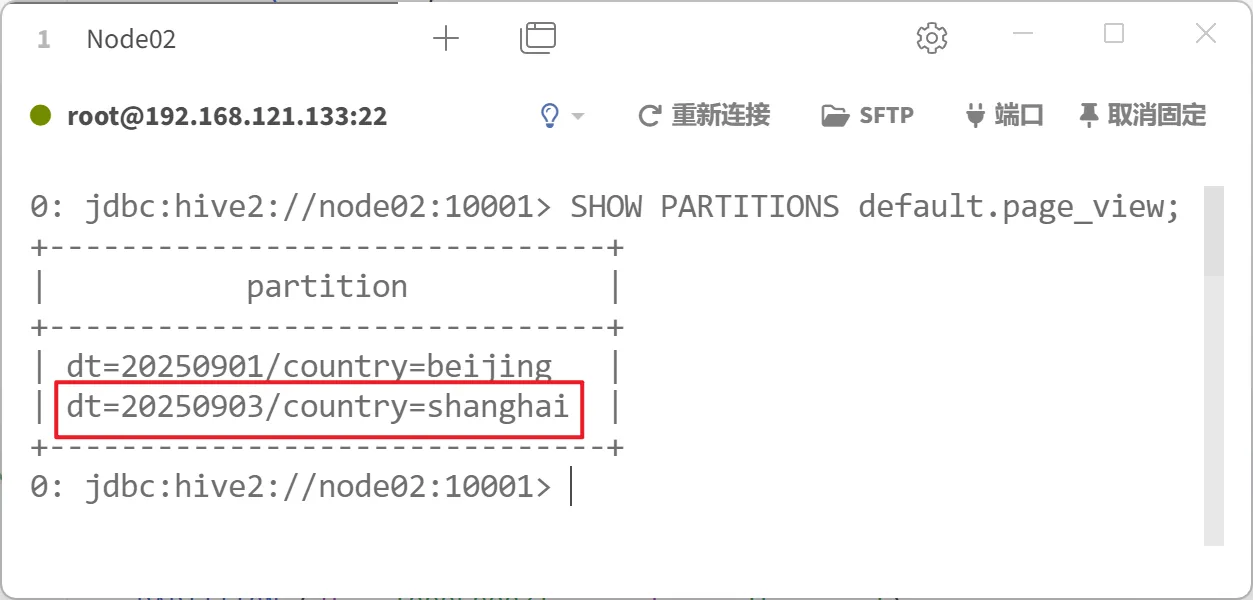
ALTER TABLE default.page_viewPARTITION (dt = '20250903', country = 'beijing')
RENAME TO PARTITION (dt = '20250903', country = 'shanghai');上述语句将分区dt=20250903/country=beijing重命名为dt=20250903/country=shanghai。
上述语句执行完成后,查询default数据库中分区表page_view的所有分区,如图。
📄 展开课件原文(第 116–120 页,共 5 页)
移动分区
掌握分区操作,能够熟练使用HiveQL语句重命名分区。
移动分区是指将源分区表中的指定分区迁移到目标分区表中,并同步更新两张分区表的元数据。在移动过程中,Hive会在目标分区表存储数据文件的目录中创建相应分区的目录。
语法格式
在Hive中移动分区的语法格式如下。
ALTER TABLE [db_name.]table_name_tagEXCHANGE PARTITION (col=value[,col=value,...])WITH TABLE [db_name.]table_name_src用于指定移动的分区
用于指定目标分区表
用于指定源分区表
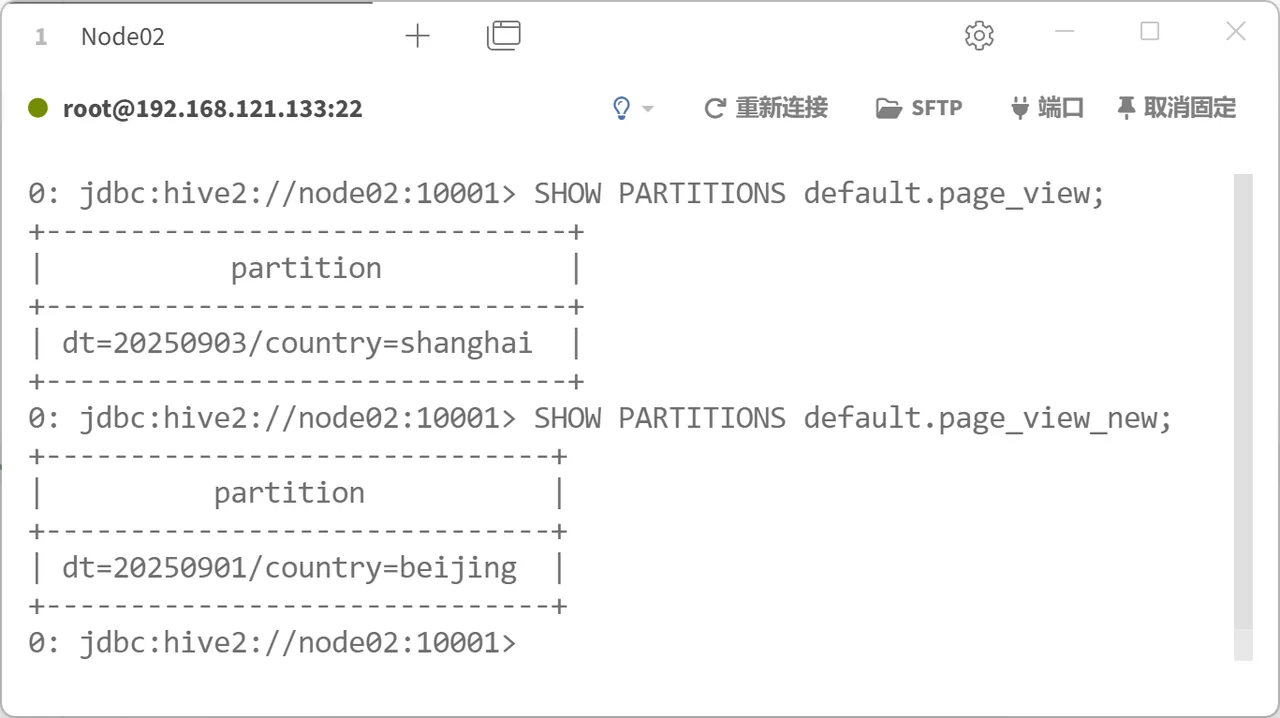
接下来,演示如何将default数据库中分区表page_view的指定分区移动到分区表page_view_new,具体操作步骤如下。
▸ 课件步骤 01
在default数据库中创建与分区表page_view的表结构完全一致的分区表page_view_new,具体HiveQL语句如下。
点击查看
▸ 课件步骤 02
ALTER TABLE default.page_view_newEXCHANGE PARTITION (dt = '20250901', country = 'beijing')WITH TABLE default.page_view;▸ 课件步骤 02
上述命令执行完成后,分别查询default数据库中分区表page_view和page_view_new的所有分区,如图。
📄 展开课件原文(第 121–127 页,共 7 页)
删除分区
掌握分区操作,能够熟练使用HiveQL语句删除分区。
在分区表的日常管理中,并非所有分区都会长期保留。随着时间推移,部分历史数据在完成业务分析任务后已不再具有保留价值,或者在数据治理过程中,发现某些分区数据存在异常,可能需要将其移除并重新加载。此外,出于存储成本控制的考虑,删除过期分区也是一种常见的运维操作。
语法格式
在Hive中删除分区的语法格式如下。
ALTER TABLE [db_name.]table_nameDROP [IF EXISTS]
PARTITION (col=value[,col=value,...])
[,PARTITION (col=value[,col=value,...]),...] [PURGE];用于在删除分区及其数据时,决定是否跳过将删除的数据移动至HDFS的回收站
用于在删除分区前进行存在性判断
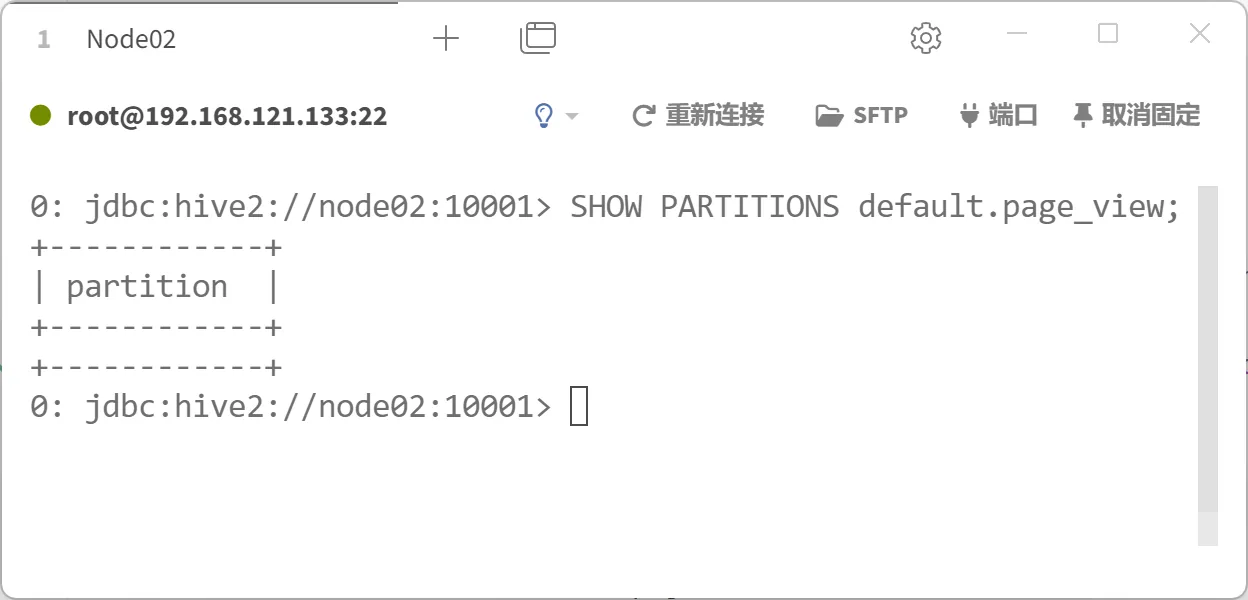
接下来,演示如何删除default数据库中分区表page_view的分区dt=20250903/country=shanghai。由于该分区为多级分区,并且分区dt=20250903下仅包含一个子分区country=shanghai,所以可以直接删除上层分区dt=20250903,具体HiveQL语句如下。
ALTER TABLE default.page_view DROP IF EXISTS PARTITION (dt='20250903');上述命令执行完成后,查询default数据库中分区表page_view的所有分区,如图。
清空分区
清空分区是指在保留分区的前提下,删除该分区中包含的所有数据。与直接删除分区不同,清空分区不会移除元数据,因此操作完成后,分区仍然存在,并且可以立即重新插入数据。
在Hive中清空分区的语法格式如下。
TRUNCATE [db_name.]table_name PARTITION (col=value[,col=value,...]);任务:创建分桶表
3.4
📄 展开课件原文(第 128–134 页,共 7 页)
创建分桶表
熟悉分桶操作,能够使用HiveQL语句创建分桶表。
语法格式
分桶是对分区的一种补充,旨在进一步提高数据处理效率和执行引擎的并行度。在Hive中,定义了分桶的表称为分桶表。分桶表的创建依赖于CREATE TABLE语句中的CLUSTERED BY子句,语法格式如下。
CLUSTERED BY (bucket_col[,bucket_col,...])
[SORTED BY (sort_col [ASC|DESC],...)]
INTO num_buckets BUCKETS
用于对桶内数据进行排序,以提升TopN查询和范围查询的效率
用于指定分桶字段,必须是分桶表中实际存储数据的字段
用于指定分桶数量
接下来,演示如何在default数据库中创建分桶表orders,具体HiveQL语句如下。
CREATE TABLE IF NOT EXISTS default.orders (order_id INT,
product_id INT,
user_id INT,
amount DOUBLE,
order_date STRING)
CLUSTERED BY (user_id)
SORTED BY (amount DESC)
INTO 8 BUCKETS
STORED AS ORC;
任务:临时表
3.5
建分桶表,并用 TABLESAMPLE 取一个桶。
CREATE TABLE IF NOT EXISTS school.score_bucket(
    stu_id STRING, course_id STRING, score INT
)
CLUSTERED BY (stu_id) INTO 4 BUCKETS
ROW FORMAT DELIMITED FIELDS TERMINATED BY ','
STORED AS TEXTFILE;

SET hive.enforce.bucketing = true;
INSERT OVERWRITE TABLE school.score_bucket SELECT * FROM school.score_info;

SELECT * FROM school.score_bucket TABLESAMPLE(BUCKET 1 OUT OF 4 ON stu_id);
💡 桶数决定文件数;分桶表只能用 INSERT…SELECT 写入,不能直接 LOAD。
📄 展开课件原文(第 135–138 页,共 4 页)
临时表
熟悉临时表操作,能够使用HiveQL语句创建临时表。
临时表是一种会话级别的表,仅在创建它的会话中可见,不会出现在其他会话中。因此,多个用户可在各自会话中创建同名临时表而互不干扰。当会话结束时,Hive会自动删除临时表的元数据和数据文件。临时表设计目的是为临时数据处理和中间数据存储提供一种轻量级解决方案,无须显式管理表的生命周期。
由于临时表仅对当前会话可见,无需跨会话共享,所以其元数据不会写入关系型数据库,而是保存在本地内存中。这种设计的优势是减少网络开销,并提升数据处理效率。同时,临时表的数据会作为临时文件存储在HDFS。
在Hive中,临时表的创建依赖于CREATE TABLE语句中的TEMPORARY关键字。接下来,演示如何在default数据库中创建临时表tmp_sales,具体HiveQL语句如下。
CREATE TEMPORARY TABLE default.tmp_sales (id BIGINT,
product STRING,
amount DOUBLE)
ROW FORMAT DELIMITED
FIELDS TERMINATED BY '\t'
COLLECTION ITEMS TERMINATED BY '|'
MAP KEYS TERMINATED BY ':'
STORED AS TEXTFILE;
任务:管理视图
3.6
📄 展开课件原文(第 139–143 页,共 5 页)
3.6 管理视图
管理视图(任务导学)
视图(View)是一种基于已有查询结果定义的虚拟表,本身不存储数据,而是在元数据中保存一条用于获取数据的查询语句,该查询语句可以基于其他表或视图构建。当用户访问视图时,Hive会在后台执行对应的查询语句,并将查询结果返回给用户。本节将介绍视图的相关操作。
📄 展开课件原文(第 144–144 页,共 1 页)
创建视图
熟悉视图操作,能够使用HiveQL语句实现视图的创建。
在数据分析中,某些查询逻辑可能非常复杂,如果每次都手动编写这类HiveQL语句,不仅效率低下,还容易出错。通过创建视图,可以将复杂查询封装成虚拟表,后续执行时像访问普通表一样,既简化了查询过程,又提高了代码的复用性和可维护性。
在Hive中创建视图的语法格式如下。
CREATE VIEW [IF NOT EXISTS] [db_name.]view_name[(column_name [COMMENT column_comment], ...)]
[COMMENT view_comment]
[TBLPROPERTIES (property_name = property_value, ...)]
AS select_statement;用于创建视图
用于在创建视图前进行存在性判断
用于定义视图的字段
用于为字段或视图添加描述信息
用于为视图添加属性
用于指定查询语句
接下来,演示如何在default数据库中创建视图product_sales_view,具体HiveQL语句如下。
CREATE VIEW IF NOT EXISTS default.product_sales_view (product_id COMMENT '商品ID',
total_sales COMMENT '销售总额'
)
COMMENT '商品销售汇总视图'
TBLPROPERTIES (
'creator' = 'itcast',
'create_date' = '2025-09-03'
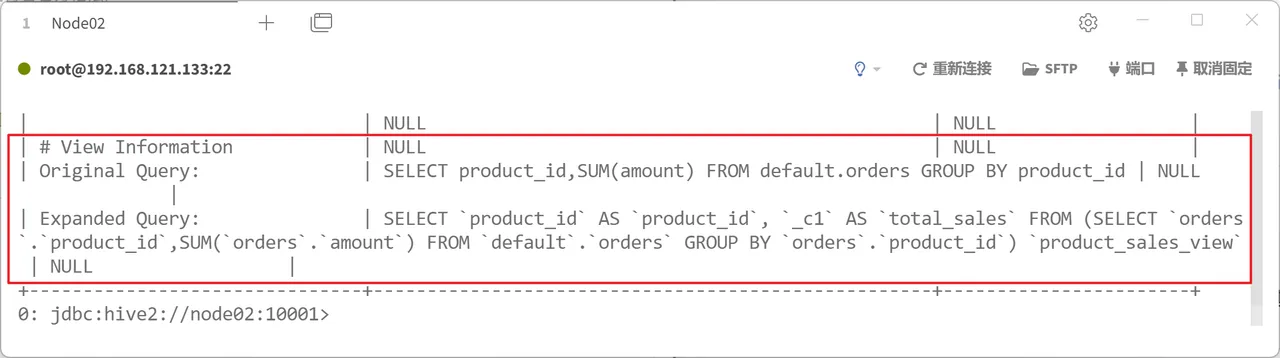
AS SELECT product_id,SUM(amount)FROM default.orders GROUP BY product_id;使用DESC语句的格式化模式可以查看视图中定义的查询语句。例如,查看视图product_sales_view中定义查询语句的效果如图。
视图使用的注意事项
视图使用的注意事项如下。
(1)在执行引用视图的查询时,会先执行视图中定义查询的子句,再执行引用视图的查询子句。例如,若视图中定义的查询包含LIMIT 5,则引用该视图的查询即使设置LIMIT 10,最终返回的行数也最多为5行。
(2)如果视图引用的表结构发生修改,这些变更不会自动反映到视图中。如果删除了视图引用的表或其他视图,那么将导致视图无法使用。
(3)视图是只读的,不支持向视图中插入数据。
把四表关联封装成视图,之后按宽表查。
CREATE VIEW IF NOT EXISTS school.v_score_detail AS
SELECT s.stu_id, s.stu_name, s.sex, c.course_name, t.tea_name, sc.score
FROM school.score_info sc
JOIN school.student_info s ON sc.stu_id = s.stu_id
JOIN school.course_info  c ON sc.course_id = c.course_id
JOIN school.teacher_info t ON c.tea_id = t.tea_id;

SELECT * FROM school.v_score_detail WHERE score >= 95 ORDER BY score DESC;| stu_name | course_name | tea_name | score |
|---|---|---|---|
| 胡歌 | 体育 | 李体音 | 100 |
| 唐国强 | 英语 | 刘丽英 | 99 |
💡 视图 = 一段被保存下来的 SQL,不占存储;SHOW VIEWS; 可以列出所有视图。
📄 展开课件原文(第 145–150 页,共 6 页)
查询视图
熟悉视图操作,能够使用HiveQL语句实现视图的查询。
在实际工作中,用户往往需要查看当前Hive环境中有哪些可用的视图,以便确定接下来的操作目标。通过查询视图,用户可以快速获取视图名称列表。用户可以直接使用SHOW TABLES语句获取指定数据库中的视图,但该语句的结果中同时包含表、视图和物化视图,不便于区分。为此,Hive提供了SHOW VIEWS命令,用于列出指定数据库中已创建的所有视图名称,其语法格式如下。
SHOW VIEWS [IN db_name] [LIKE pattern];用于查询指定数据库中已有的视图
用于指定数据库名称
用于指定视图名的匹配模式,用单引号包裹
案例
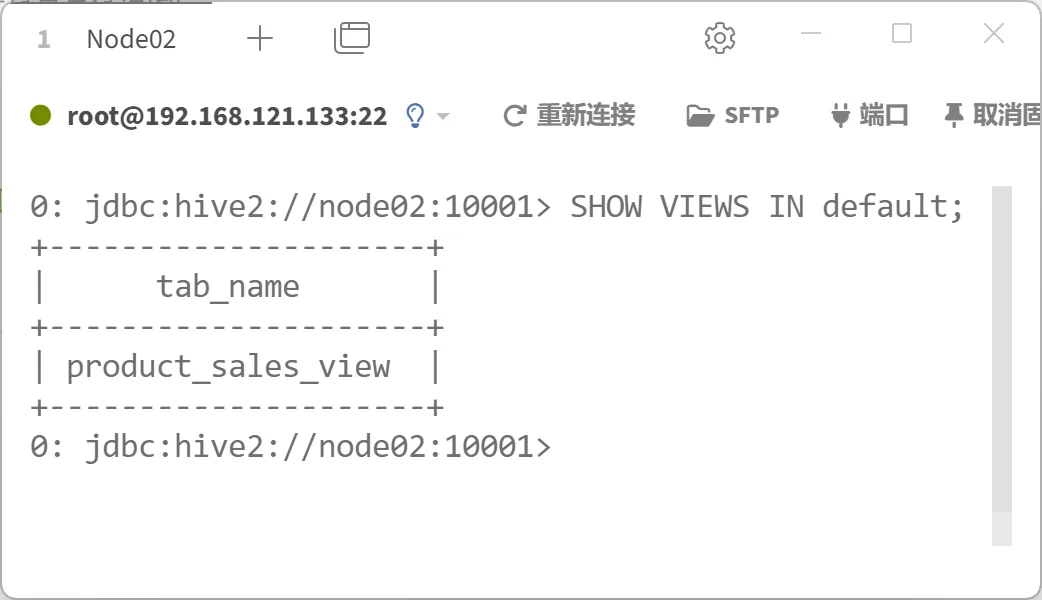
接下来,演示如何查询default数据库中已创建的所有视图,具体HiveQL语句如下。
SHOW VIEWS IN default;上述命令执行完成后的效果如图。
📄 展开课件原文(第 151–153 页,共 3 页)
修改视图
熟悉视图操作,能够使用HiveQL语句实现视图的修改。
视图的定义并非一成不变。随着业务需求的变化,可能需要调整视图的查询逻辑以适应新的分析场景,或更新视图的属性以补充关键信息。接下来,将重点介绍如何修改视图的查询语句和属性。
修改视图的属性
修改视图的查询语句
在Hive中修改视图查询语句的语法格式如下。
1. 修改视图的查询语句
语法格式
ALTER VIEW [db_name.]view_name AS select_statement;用于修改视图
用于指定修改后的查询语句
接下来,将演示如何修改default数据库中视图product_sales_view的查询语句,具体HiveQL语句如下。
ALTER VIEW default.product_sales_view AS
SELECT product_id,SUM(amount) FROM default.ordersWHERE order_date = '2024-09-03' GROUP BY product_id;在Hive中修改视图属性的语法格式如下。
2. 修改视图的属性
ALTER VIEW [db_name.]view_name
SET TBLPROPERTIES (property_name=property_value,...);
需要说明的是,在修改视图的属性时,若指定的属性名称已存在,则新设置的属性值将覆盖原有值;若属性名称不存在,则会添加一个新的属性。
接下来,将演示如何修改default数据库中视图product_sales_view的属性,具体HiveQL语句如下。
HiveQL语句
ALTER VIEW default.product_sales_view
SET TBLPROPERTIES (
'creator' = 'sale_team',
'sale_date' = '2024-09-03'
);📄 展开课件原文(第 154–159 页,共 6 页)
删除视图
熟悉视图操作,能够使用HiveQL语句实现视图的删除。
在数据仓库中,部分视图可能因为业务下线、查询逻辑过时等因素而失去使用价值。为了保持数据库结构简洁、降低维护成本,应定期清理无用视图。在Hive中删除视图的语法格式如下。
语法格式
DROP VIEW [IF EXISTS] [db_name.]view_name;用于删除视图
用于在删除视图前进行存在性判断
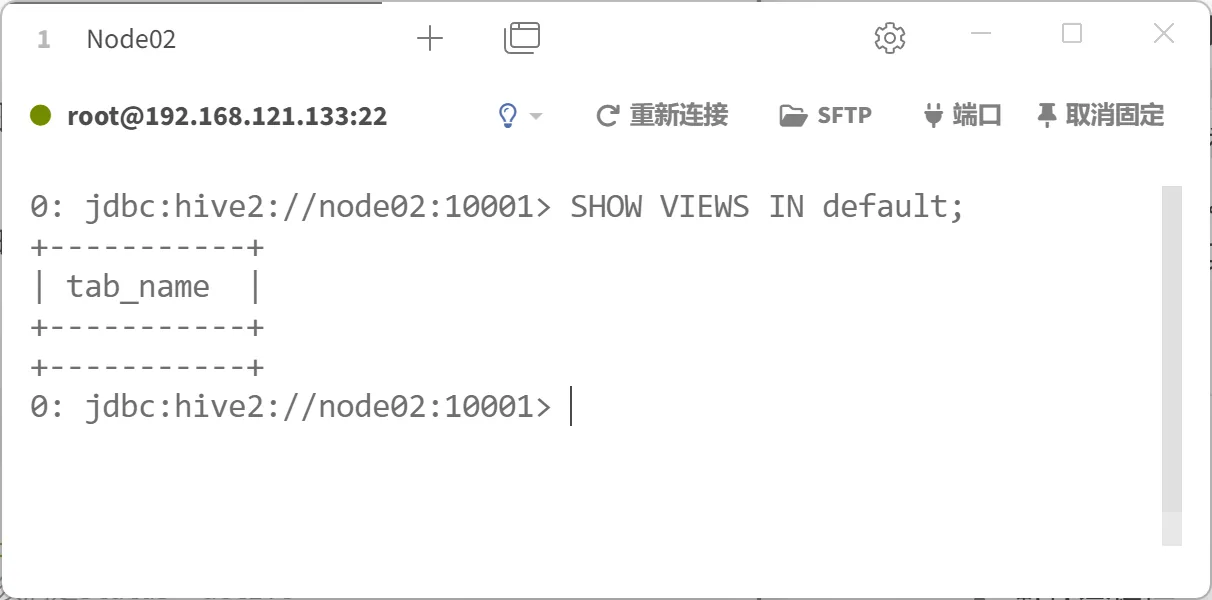
DROP VIEW IF EXISTS default.product_sales_view;上述命令执行完成后,查询default数据库中已创建的所有视图,如图。
案例
接下来,将演示如何删除default数据库中的视图product_sales_view,具体HiveQL语句如下。
任务:管理物化视图
3.7
📄 展开课件原文(第 160–163 页,共 4 页)
3.7 管理物化视图
管理物化视图(任务导学)
物化视图是Hive 3.0新增的一种持久化存储查询结果的特殊视图。与视图相比,物化视图的主要区别体现在以下两方面。
视图仅在元数据中保存查询语句,不存储实际数据。
物化视图不仅在元数据中保存查询语句,还会将查询结果保存为实际数据文件,因此会额外占用存储空间。
数据存储
列式存储
1.视图在创建时并不会执行查询语句,但每次查询时会重新执行查询语句。
优点是可以实时反映所引用表的数据变化。
缺点是增加计算开销。
2.物化视图在创建时执行一次查询语句,并将查询结果存储起来,后续查询可直接读取已存储的数据。
优点是避免重复计算,显著提升查询性能。
缺点是数据需要刷新才能保持最新。
📄 展开课件原文(第 164–164 页,共 1 页)
创建物化视图
熟悉物化视图操作,能够使用HiveQL语句实现物化视图的创建。
在数据分析中,经常会遇到计算复杂、执行耗时的查询,例如跨多张大表的连接或大规模分组聚合。如果每次查询都从原始表开始全量计算,不仅会消耗大量资源,还会显著增加延迟。通过创建物化视图,可以将这些复杂查询的结果持久化存储,后续查询时直接复用即可,而无需重复计算底层数据。这样既能大幅提升查询性能,也能有效减轻计算引擎的负载。
在Hive中创建物化视图的语法格式如下。
点击查看
接下来,演示如何在default数据库中创建物化视图mv_daily_product_sales,具体HiveQL语句如下。
CREATE MATERIALIZED VIEW IF NOT EXISTS mv_daily_product_salesDISABLE REWRITECOMMENT '按天汇总不同商品的销售额'
PARTITIONED ON (order_date) CLUSTERED ON (product_id)TBLPROPERTIES (
'creator' = 'itcast',
'create_date' = '2025-09-03'
)
AS SELECT order_date,product_id,SUM(amount) AS revenueFROM orders GROUP BY order_date, product_id;启动或禁用查询重写机制
当物化视图创建完成后,用户也可以通过HiveQL语句对查询重写机制进行启动或禁用,具体语法格式如下。
ALTER MATERIALIZED VIEW [db_name.]materialized_view_name ENABLE|DISABLE REWRITE;表示启用查询重写机制
表示禁用查询重写机制
把耗时的聚合结果物化下来,并演示查询重写。
CREATE MATERIALIZED VIEW IF NOT EXISTS school.mv_course_avg AS
SELECT course_id, count(*) AS cnt, round(avg(score), 2) AS avg_score
FROM school.score_info GROUP BY course_id;

SELECT * FROM school.mv_course_avg ORDER BY avg_score DESC;

-- 开启查询重写:以后直接查底表,优化器会改读物化视图
SET hive.materializedview.rewriting = true;
ALTER MATERIALIZED VIEW school.mv_course_avg REBUILD; -- 底表变了要刷新| course_id | cnt | avg_score |
|---|---|---|
| 05 | 5 | 74.6 |
| 03 | 19 | 69.42 |
| 01 | 19 | 67.16 |
| 04 | 12 | 63.42 |
| 02 | 19 | 59.63 |
💡 物化视图有真实数据文件,所以占存储、需要维护;换来的是复杂查询的秒级响应。
📄 展开课件原文(第 165–169 页,共 5 页)
查询物化视图
熟悉物化视图操作,能够使用HiveQL语句实现物化视图的查询。
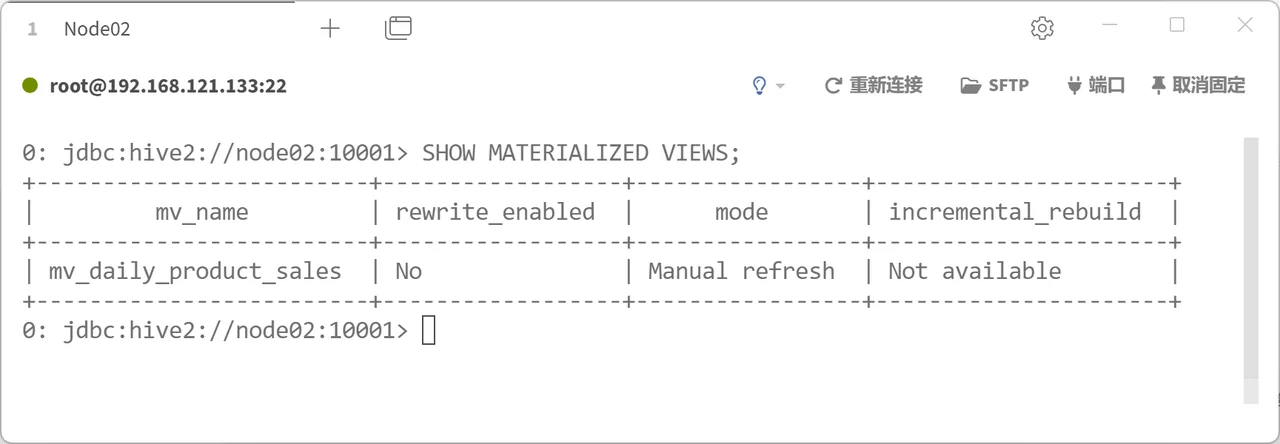
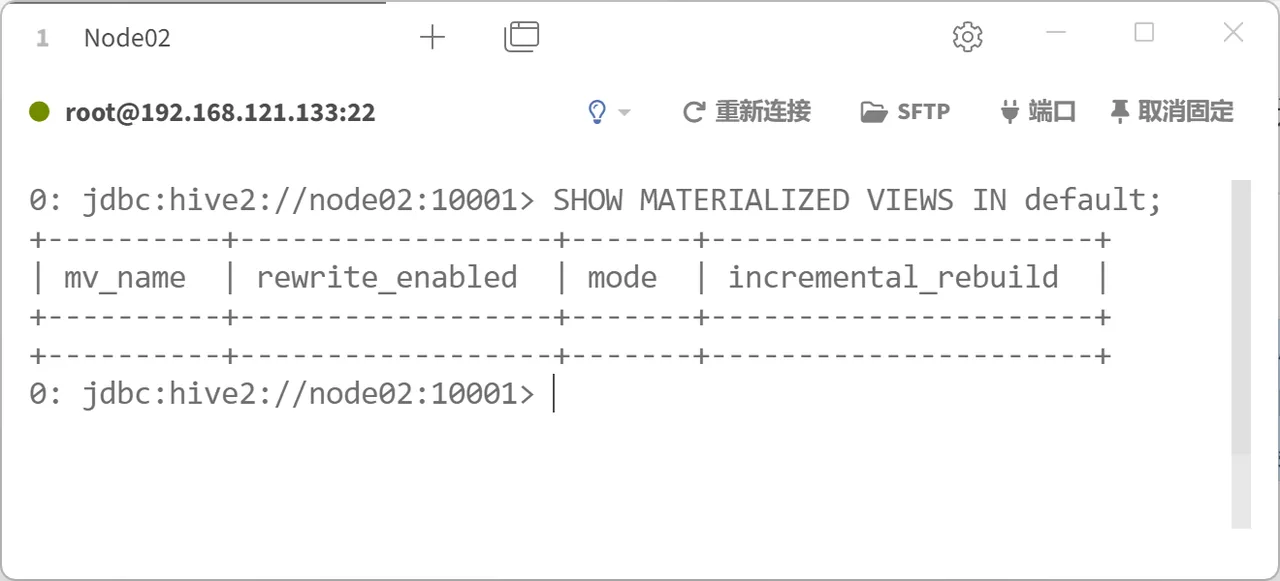
用户可以直接使用SHOW TABLES语句获取指定数据库中的物化视图,但该语句的结果中同时包含表、视图和物化视图,不便于区分。为此,Hive提供了SHOW MATERIALIZED VIEWS命令,用于列出指定数据库中已创建的所有物化视图,并展示其名称、是否支持查询重写、维护模式以及是否支持增量重建的信息,其语法格式如下。
SHOW MATERIALIZED VIEWS [IN db_name] [LIKE pattern];案例
接下来,演示如何查询default数据库中已创建的所有物化视图,具体HiveQL语句如下。
SHOW MATERIALIZED VIEWS IN default;上述命令执行完成后的效果如图。
📄 展开课件原文(第 170–172 页,共 3 页)
维护物化视图
熟悉物化视图操作,能够使用HiveQL语句实现维护物化视图的操作。
在Hive中,物化视图通过持久化存储查询结果,大幅提升了复杂查询的性能。然而,物化视图并不是一劳永逸的,它所依赖的表往往会不断更新,如果不加以维护,物化视图中的数据就可能与真实业务数据不一致,进而影响查询结果的准确性。
在维护物化视图时,用户既可以手动刷新,也可以结合定时查询实现周期性刷新。在刷新过程中,系统会优先判断物化视图是否支持增量重建。增量重建指仅读取自上次刷新以来引用表变更的数据,并将其合并到现有物化视图中;若条件不满足,则改为全量重建,即重新读取引用表的全部数据并重写物化视图。判断物化视图是否支持增量重建需要满足多个条件,包括引用表必须是事务表、物化视图通过transactional属性定义为支持事务等。
关于手动刷新和周期性刷新物化视图数据的介绍如下。
周期性刷新
手动
刷新
在Hive中手动刷新物化视图数据的语法格式如下。
1. 手动刷新
语法格式
ALTER MATERIALIZED VIEW [db_name.]materialized_view_name REBUILD;Hive 4.0引入了定时查询(Scheduled Queries)机制,用于创建定时查询,在Hive内部周期性执行指定的HiveQL语句。用户可以将该机制与手动刷新物化视图的HiveQL语句结合使用,从而实现物化视图数据的自动周期性刷新。2. 周期性刷新
关于定时查询的语法格式如下。
CREATE SCHEDULED QUERY scheduled_query_namescheduleSpecification
DEFINED AS query;用于在Hive中创建一个定时查询
用于指定定时查询的唯一标识
用于指定定时查询的执行周期
用于指定执行的HiveQL语句
用于指定单条HiveQL语句
scheduleSpecification参数用于指定定时查询的执行周期,支持CRON表达式和EVERY语法两种方式,具体介绍如下。
(1)使用CRON表达式的语法格式如下。
CRON quartz_schedule_expression用于指定具体的CRON表达式,必须用单引号括起
(2)使用EVERY的语法格式如下。
EVERY [num] SECOND | MINUTE | HOUR | DAY [AT time]
用于指定间隔时间,默认为1
用于指定时间单位,分别表示秒、分、时和天
用于周期内的固定触发时间
用于指定具体时间
接下来,演示如何为default数据库中的物化视图mv_daily_product_sales设置周期性刷新,具体HiveQL语句如下。
CREATE SCHEDULED QUERY mv_rebuild EVERY 3 HOUR
DEFINED AS ALTER MATERIALIZED VIEW default.mv_daily_product_sales REBUILD;
案例
在虚拟机Node03中使用root用户登录MySQL,在MySQL命令行界面执行如下命令。
SELECT * FROM remote.SCHEDULED_QUERIES \G上述命令将输出结果以垂直格式显式,便于查看定时查询的详细信息,如图。
删除定向查询
随着业务需求的变化,一些定时查询可能逐渐失去作用,或者被新的执行逻辑所替代。如果这些过期的定时查询仍然保留在系统中,不仅会造成元数据冗余,还可能在执行过程中引发混淆甚至错误。因此,适时地删除不再需要的定时查询,是数据仓库日常运维中不可或缺的一部分。在Hive中删除定时查询的语法格式如下。
DROP SCHEDULED QUERY scheduled_query_name;例如,删除Hive中名为mv_rebuild的定时查询,具体HiveQL语句如下。
DROP SCHEDULED QUERY mv_rebuild;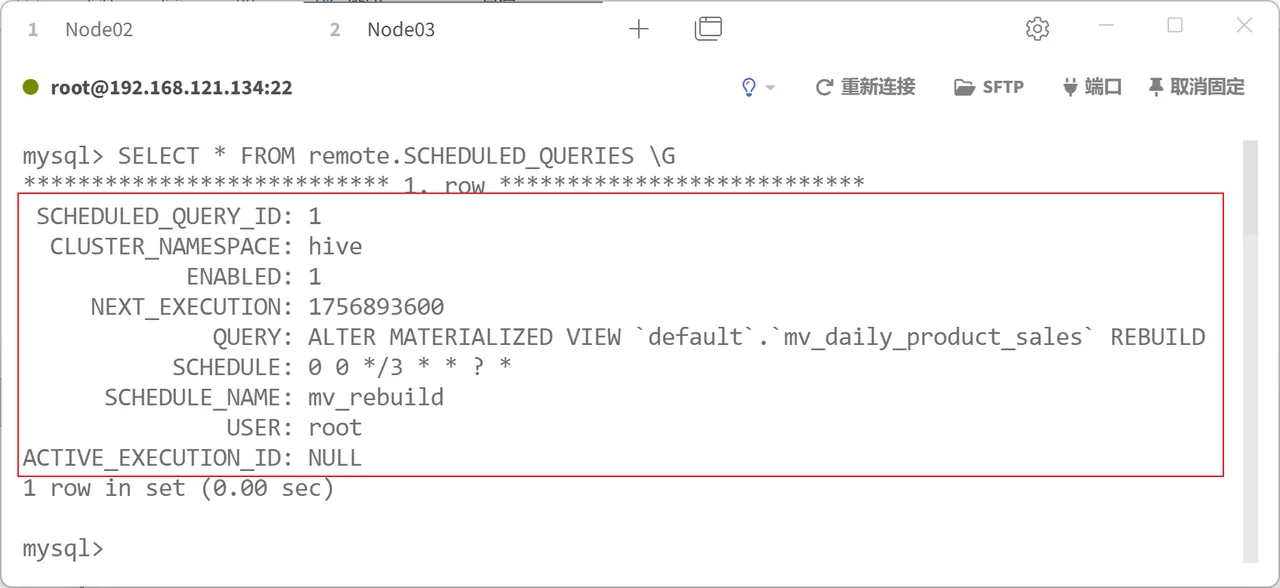
📄 展开课件原文(第 173–185 页,共 13 页)
删除物化视图
熟悉物化视图操作,能够使用HiveQL语句实现删除物化视图的操作。
随着业务逻辑的变化和数据模型的演进,部分物化视图可能逐渐失去价值,甚至成为系统负担。例如,业务需求调整后,原有的统计逻辑被新的查询方式取代;某些物化视图占用大量存储空间,却很少被使用,从而造成资源浪费。在这种情况下,继续保留无效的物化视图不仅会增加元数据管理的复杂度,还可能干扰查询重写的准确性。因此,应及时删除不再需要的物化视图。
在Hive中删除物化视图的语法格式如下。
语法格式
DROP MATERIALIZED VIEW [db_name.]materialized_view_name;用于删除物化视图
案例
接下来,演示如何删除default数据库中的物化视图mv_daily_product_sales,具体HiveQL语句如下。
DROP MATERIALIZED VIEW default.mv_daily_product_sales;上述命令执行完成查询default数据库中已创建的所有物化视图,如图。
2. 周期性刷新
AI助学
学完本单元后,读者已经初步掌握了Hive中数据库、表、分区等对象的定义与管理方法。然而,在实际设计Hive表结构时,仍可能难以判断各类数据对象的使用是否合理。此时,可以借助AI对业务需求和初步设计方案进行分析,帮助发现可能存在的问题,并提出改进建议。
AI
助
学
单元总结
本单元主要讲解了Hive的数据定义语言。首先,介绍了数据库和表的相关操作,包括创建、查询、删除等。然后,介绍了分区和分桶的相关操作,包括创建分区表、创建分桶表、添加分区等。最后,介绍了临时表、视图和物化视图的相关操作,包括创建临时表、创建视图、创建物化视图等。通过本单元的学习,读者能够熟练使用HiveQL语句完成数据库、表、视图等数据对象的设计与维护,为实际应用中数据仓库的构建与管理提供支持。
单
元
总
结
📄 展开课件原文(第 186–191 页,共 6 页)
🧪 动手做一遍 从零建一套“校园选课”数据仓库表结构
预计用时约 40 分钟 · 每一步都给出可执行语句与预期结果,建议边看边在 Beeline / DataGrip 里敲一遍
本实例步骤
- 01 建库
- 02 建内部表并加载数据
- 03 建外部表:数据还在,删表不删数据
- 04 建分区表并按课程分区写入
- 05 建分桶表:把数据按哈希切成固定份数
- 06 建视图:把复杂查询存起来复用
- 07 建物化视图:把结果算好存起来
- 08 收尾:把这套库表清掉
01建库
每套业务一个库,便于隔离和授权。
CREATE DATABASE IF NOT EXISTS school
COMMENT '校园选课演示库'
LOCATION '/user/hive/warehouse/school.db';

SHOW DATABASES LIKE 'sch*';
USE school;验证语句:SELECT 'school' AS database_name
| database_name |
|---|
| school |
SHOW DATABASES LIKE 支持通配:* 任意字符,| 表示或。ParseException … cannot recognize input near
→ 分号或引号写成了中文标点,换成英文再试。Permission denied … /user/hive/warehouse
→ 仓库目录没写权限:hdfs dfs -chmod -R 777 /user/hive/warehouse。
02建内部表并加载数据
内部表(Managed Table)由 Hive 托管数据,删表会连数据一起删。
CREATE TABLE IF NOT EXISTS student_info(
    stu_id   STRING COMMENT '学生id',
    stu_name STRING COMMENT '学生姓名',
    birthday STRING COMMENT '出生日期',
    sex      STRING COMMENT '性别'
)
ROW FORMAT DELIMITED FIELDS TERMINATED BY ','
STORED AS TEXTFILE;

LOAD DATA LOCAL INPATH '/home/hadoop/shell/data/student_info.txt' INTO TABLE student_info;| 语句片段 | 逐句解释 |
|---|---|
CREATE TABLE IF NOT EXISTS student_info( … ) | 建表:括号里是四个字段,每个字段“名字 + 类型 + 注释”,最后一个字段后面不要加逗号 |
ROW FORMAT DELIMITED FIELDS TERMINATED BY ',' | 声明数据文件用逗号分隔字段——必须和数据文件真实分隔符一致,否则查出来全是 NULL |
STORED AS TEXTFILE | 文件存成普通文本,可以直接用 hdfs dfs -cat 看到内容;正式数仓常换成 ORC |
LOAD DATA LOCAL INPATH '…' INTO TABLE … | LOCAL 表示从客户端本机读文件;INTO 是追加,换成 OVERWRITE 会先清空表 |
验证语句:SELECT stu_id, stu_name, sex FROM student_info LIMIT 5
| stu_id | stu_name | sex |
|---|---|---|
| 001 | 彭于晏 | 男 |
| 002 | 胡歌 | 男 |
| 003 | 周杰伦 | 男 |
| 004 | 刘德华 | 男 |
| 005 | 唐国强 | 男 |
Invalid path … No files matching path
→ 文件路径写错了:先用ls -l 路径确认文件真实存在。查出来字段全是 NULL
→ 文件里的分隔符和建表声明的不一致(比如文件用逗号、建表写了 \t)。Table not found: student_info
→ 不在 school 库里,先执行USE school;。
💡 加载是把文件“搬到”表目录下,不是解析后插入,所以非常快。
03建外部表:数据还在,删表不删数据
外部表适合“数据由别的系统产生、Hive 只是来查”的场景。
CREATE EXTERNAL TABLE IF NOT EXISTS ext_student(
    stu_id   STRING,
    stu_name STRING,
    birthday STRING,
    sex      STRING
)
ROW FORMAT DELIMITED FIELDS TERMINATED BY ','
LOCATION '/user/hadoop/student';        -- 指向已存在的数据目录

-- 对比一下:删外部表只删元数据,目录里的文件还在
DROP TABLE ext_student;
-- HDFS 上 /user/hadoop/student 里的文件依然存在验证语句:SELECT count(*) AS cnt FROM student_info
| cnt |
|---|
| 40 |
建外部表后查不到数据
→ LOCATION 指向的目录里得有数据文件,且文件名不能被 Hive 忽略(以 . 或 _ 开头的文件会被跳过)。DROP 之后发现数据没了
→ 说明建的是内部表——没写 EXTERNAL 关键字。
04建分区表并按课程分区写入
把大表按业务维度切开,查询时只扫相关分区。
CREATE TABLE IF NOT EXISTS score_part(
    stu_id STRING COMMENT '学生id',
    score  INT    COMMENT '成绩'
)
PARTITIONED BY (course_id STRING COMMENT '课程id')
ROW FORMAT DELIMITED FIELDS TERMINATED BY ','
STORED AS TEXTFILE;

-- 开启动态分区,让 Hive 按 SELECT 出来的课程号自动建分区
SET hive.exec.dynamic.partition=true;
SET hive.exec.dynamic.partition.mode=nonstrict;

INSERT OVERWRITE TABLE score_part PARTITION(course_id)
SELECT stu_id, score, course_id FROM score_info;

SHOW PARTITIONS score_part;| 语句片段 | 逐句解释 |
|---|---|
PARTITIONED BY (course_id STRING) | 把 course_id 声明为分区列——它不写在字段清单里,而是以目录形式存在(…/course_id=01/) |
SET hive.exec.dynamic.partition=true; | 开启动态分区,让 Hive 按 SELECT 出来的值自动建分区目录 |
SET …mode=nonstrict; | 非严格模式:允许“一个静态分区都不写、全靠动态生成”,否则必须手动指定至少一个分区值 |
INSERT OVERWRITE TABLE … PARTITION(course_id) SELECT …, course_id | SELECT 里最后几列必须和 PARTITION() 里声明的列一一对应,顺序不能乱 |
验证语句:SELECT course_id, count(*) AS cnt FROM score_part GROUP BY course_id ORDER BY course_id
| course_id | cnt |
|---|---|
| 01 | 19 |
| 02 | 19 |
| 03 | 19 |
| 04 | 12 |
| 05 | 5 |
WHERE course_id = '01'。Dynamic partition strict mode requires at least one static partition column
→ 没开非严格模式,补上SET hive.exec.dynamic.partition.mode=nonstrict;。报错说分区列已存在 / 字段数对不上
→ 分区列被重复写进了字段清单,或者 INSERT 的列顺序和分区声明不一致。SHOW PARTITIONS 一个都没有
→ 数据没插进去(源表为空),或用了 INSERT INTO 却没匹配到数据。
05建分桶表:把数据按哈希切成固定份数
分桶让抽样更快,也让大表 join 有机会变成 Map 端连接。
CREATE TABLE IF NOT EXISTS score_bucket(
    stu_id    STRING,
    course_id STRING,
    score     INT
)
CLUSTERED BY (stu_id) INTO 4 BUCKETS
ROW FORMAT DELIMITED FIELDS TERMINATED BY ','
STORED AS TEXTFILE;

-- 分桶表必须用 INSERT … SELECT 写入(不能直接 LOAD)
INSERT OVERWRITE TABLE score_bucket SELECT stu_id, course_id, score FROM score_info;

-- 抽样:取 4 个桶中的第 1 个桶
SELECT * FROM score_bucket TABLESAMPLE(BUCKET 1 OUT OF 4 ON stu_id);| 语句片段 | 逐句解释 |
|---|---|
CLUSTERED BY (stu_id) INTO 4 BUCKETS | 按 stu_id 的哈希值把数据分成 4 份,每份是一个文件;桶数一旦定下就不要再改 |
INSERT OVERWRITE TABLE score_bucket SELECT … | 分桶表只能用查询结果写入(LOAD 进去的文件不会被分桶,抽样就失去意义) |
SET hive.enforce.bucketing = true; | 强制 Reduce 数与桶数一致,保证真的按桶写文件 |
验证语句:SELECT count(*) AS total_in_4_buckets FROM score_bucket
| total_in_4_buckets |
|---|
| 74 |
hdfs dfs -ls /user/hive/warehouse/school.db/score_bucket。Expected 4 buckets but found 3 / 桶数不一致
→ 开了hive.enforce.bucketing=true再重跑 INSERT;桶数要和建表一致。LOAD DATA 到分桶表后抽样结果不对
→ 分桶表必须用 INSERT … SELECT 写入,不能直接 LOAD。
06建视图:把复杂查询存起来复用
视图不存数据,只存 SQL 逻辑,适合把多表关联封装成“一张宽表”。
CREATE VIEW IF NOT EXISTS v_score_detail AS
SELECT s.stu_id, s.stu_name, s.sex,
       c.course_name, t.tea_name, sc.score
FROM score_info sc
JOIN student_info s ON sc.stu_id = s.stu_id
JOIN course_info  c ON sc.course_id = c.course_id
JOIN teacher_info t ON c.tea_id = t.tea_id;

-- 像查普通表一样查视图
SELECT stu_name, course_name, tea_name, score
FROM v_score_detail
WHERE score >= 95
ORDER BY score DESC;验证语句:SELECT stu_name, course_name, tea_name, score FROM v_score_detail WHERE score >= 95 ORDER BY score DESC
| stu_name | course_name | tea_name | score |
|---|---|---|---|
| 胡歌 | 体育 | 李体音 | 100 |
| 胡歌 | 体育 | 李体音 | 100 |
| 唐国强 | 英语 | 刘丽英 | 99 |
| 唐国强 | 英语 | 刘丽英 | 99 |
Table not found: score_info
→ 视图依赖的四张表必须先存在,建视图不会帮你建表。查询视图报权限/表不存在
→ 视图里引用的表被删了或改名了,视图不会自动跟着更新。
💡 查看视图列表用 SHOW VIEWS;,看定义用 SHOW CREATE TABLE v_score_detail;。
07建物化视图:把结果算好存起来
复杂聚合查询重复执行很贵,物化视图把结果落盘,还能被优化器自动重写复用。
CREATE MATERIALIZED VIEW IF NOT EXISTS mv_course_avg
AS SELECT course_id, count(*) AS cnt, round(avg(score), 2) AS avg_score
FROM score_info GROUP BY course_id;

SELECT * FROM mv_course_avg ORDER BY avg_score DESC;

-- 数据变了要刷新(支持增量重建时会自动走增量)
ALTER MATERIALIZED VIEW mv_course_avg REBUILD;验证语句:SELECT course_id, cnt, avg_score FROM mv_course_avg ORDER BY avg_score DESC
| course_id | cnt | avg_score |
|---|---|---|
| 05 | 5 | 74.6 |
| 03 | 19 | 69.42 |
| 01 | 19 | 67.16 |
| 04 | 12 | 63.42 |
| 02 | 19 | 59.63 |
Materialized view requires … / 语法报错
→ 物化视图是 Hive 3.0+ 特性,确认客户端与服务端版本;老版本只能用普通视图 + 定时任务。物化视图里的数据和底表对不上
→ 底表更新后要执行ALTER MATERIALIZED VIEW … REBUILD;才会同步。
08收尾:把这套库表清掉
练习删除语法,也观察内部表与外部表的差别。
DROP VIEW IF EXISTS v_score_detail;
DROP MATERIALIZED VIEW IF EXISTS mv_course_avg;
DROP TABLE IF EXISTS score_part;
DROP TABLE IF EXISTS score_bucket;
DROP TABLE IF EXISTS student_info;
DROP DATABASE IF EXISTS school CASCADE; -- CASCADE 连库里的表一起删验证语句:SELECT count(*) AS students FROM student_info
| students |
|---|
| 40 |
DROP DATABASE school 在库非空时会报错,必须加 CASCADE。Database school is not empty
→ 库里有表,加CASCADE(连表一起删,生产环境慎用)。删完发现 HDFS 上文件还在
→ 删的是外部表或直接删了目录——外部表本来就只删元数据。