单元6 Hive函数应用
八类内置函数 + 窗口函数 + 自己写 UDF/UDAF/UDTF
本单元学习目标 摘自课件“学习目标/Target”页
- 掌握常用内置函数的使用方法,能够根据数据处理需求选择不同类型的内置函数。
- 熟悉窗口函数的语法结构,能够根据数据处理需求选择不同类型的窗口函数。
- 了解自定义函数的开发流程,能够通过Java应用程序开发UDF、UDTF和UDAF,并完成函数注册与调用。
单元概述
函数作为逻辑封装与复用的重要载体,在简化复杂计算、提升分析效率方面具有不可替代的作用。作为数据仓库工具,Hive内置的函数体系是海量数据处理场景下标准化工具链的关键组成部分。通过将常见的数据操作抽象为函数接口,Hive有效降低了分布式数据处理的技术门槛,使分析人员能够专注于业务逻辑而非底层实现。同时,Hive还支持用户编写自定义函数,以满足多样化的业务需求。本单元将系统介绍Hive中的函数。
知识地图
本单元知识地图
学完本单元,你应该能回答
- 窗口函数与 GROUP BY 聚合的本质区别?
- UDF、UDAF、UDTF 分别解决什么形态的计算?
- 自定义函数如何打包、上传、注册到 Hive?
- 爆炸函数 explode 为什么常和 lateral view 搭配?
知识链位置
核心知识 点击标题右侧勾选框可标记“已掌握”,进度会保存在本机浏览器
6.1 使用常用内置函数
使用常用内置函数(任务导学)
在日常数据处理场景中,Hive的内置函数是基础且常用的功能。它们覆盖了数据汇总、数学计算、字符串操作、日期处理多个方面,为用户提供了开箱即用的解决方案。熟练掌握这些内置函数,能够有效简化数据转换与分析流程,显著提升工作效率。本任务将系统介绍 Hive中的内置函数。
📄 展开课件原文(第 6–6 页,共 1 页)
聚合函数
掌握常用内置函数的使用方法,能够灵活运用Hive提供的聚合函数。
在数据分析过程中,从海量数据中提炼宏观指标是核心需求之一。面对庞大的原始记录,逐条查看往往难以支撑有效决策。聚合函数作为数据汇总的核心手段,能够将多行输入归并为单个输出值,使分散的数据通过统计规则(如计数、求和等)被提炼为具有业务意义的结果,从而完成从微观记录到宏观指标的转化。
关于Hive中常用内置聚合函数的介绍如表。
| 聚合函数 | 语法及描述 |
|---|---|
| count() | count(*):统计总行数 count(col):统计字段col非NULL的行数 count(DISTINCT col):统计字段col去重后非NULL的行数 |
| sum() | sum(col):计算数值型字段col的总和 sum(DISTINCT col):计算数值型字段col去重后的总和 |
| avg() | avg(col):计算数值型字段col的平均值 avg(DISTINCT col):计算数值型字段col去重后的平均值 |
| 聚合函数 | 语法及描述 |
|---|---|
| min() | min(col):统计字段col的最小值 |
| max() | max(col):统计字段col的最大值 |
| collect_set() | collect_set(col):将字段col的值去重后,以集合的形式返回 |
| collect_list() | collect_list(col):将字段col的值按集合的形式返回 |
| var_pop() | var_pop(col):计算数值型字段col的方差 |
| var_samp() | var_samp(col):计算数值型字段col的无偏样本方差 |
| 聚合函数 | 语法及描述 |
|---|---|
| stddev_pop() | stddev_pop(col):计算数值型字段col的标准差 |
| stddev_samp() | stddev_samp(col):计算数值型字段col的无偏样本标准差 |
| covar_pop() | covar_pop(col1,col2):计算两个数值类型字段col1和col2的总体协方差 |
| covar_samp() | covar_samp(col1,col2):计算两个数值类型字段col1和col2的样本协方差 |
| corr() | corr(col1,col2):计算两个数值类型字段col1和col2的皮尔逊相关系数 |
接下来,演示Hive中常用内置聚合函的表中部分内置聚合函数的使用,具体内容如下。
▸ 课件步骤 01
在Hive中执行HiveQL脚本文件chapter6.hql,导入本单元相关操作所需的数据,具体HiveQL语句如下。
beeline -u 'jdbc:hive2://node02:10001' -n root \-f /export/data/chapter6/chapter6.hql
执行上述命令之前,需要提前将HiveQL脚本文件chapter6.hql上传到虚拟机Node02的/export/data/chapter6目录(需提前创建)中。
▸ 课件步骤 02
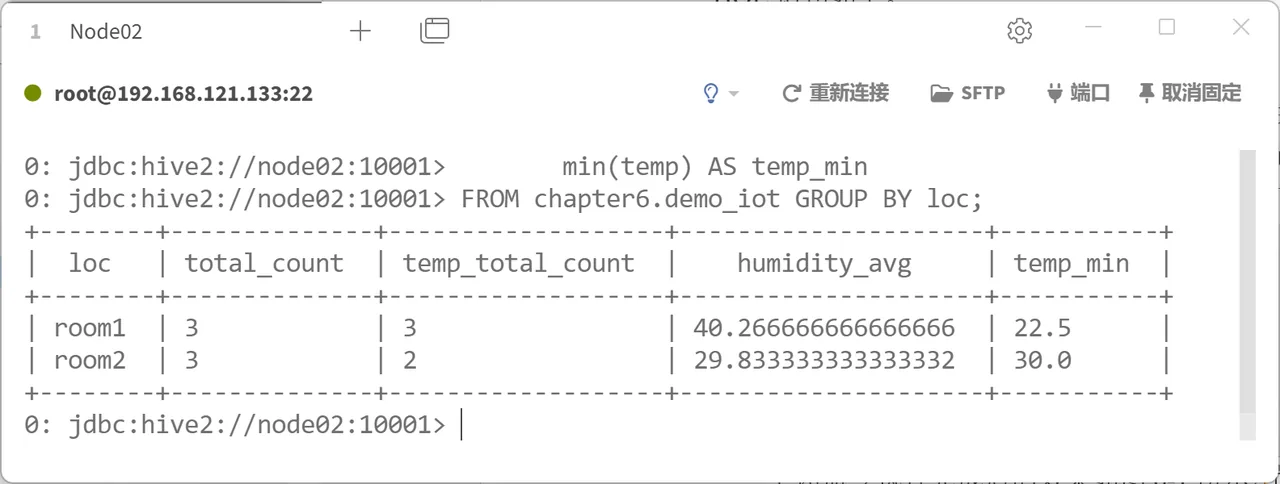
查询数据库chapter6中表demo_iot的数据,分别使用count()、avg()和min()函数统计每个房间的总记录数、每个房间中温度值的记录数、每个房间的平均相对湿度和每个房间的最低温度,具体HiveQL语句如下。
SELECT loc,
count(*) AS total_count,
count(temp) AS temp_total_count,
avg(humidity) AS humidity_avg,
min(temp) AS temp_min
FROM chapter6.demo_iot GROUP BY loc;
▸ 课件步骤 02
上述语句执行完成后的效果如图。
▸ 课件步骤 03
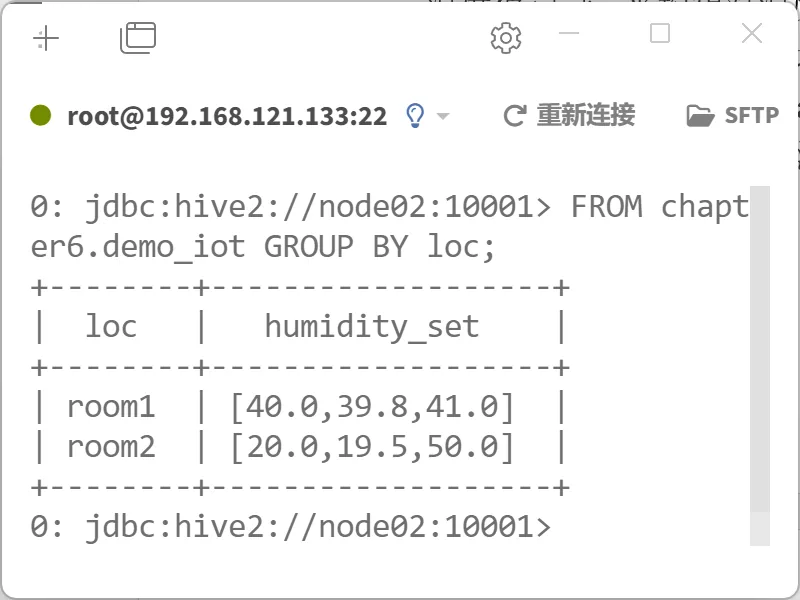
查询数据库chapter6中表demo_iot的数据,使用collect_set()函数获取每个房间中所有相对湿度的记录,具体HiveQL语句如下。
SELECT loc,collect_set(humidity) AS humidity_set▸ 课件步骤 03
聚合函数:指标计算的基础。
SELECT course_id,
       count(*) AS 记录数, count(DISTINCT stu_id) AS 人数,
       sum(score) AS 总分, round(avg(score),2) AS 平均分,
       max(score) AS 最高, min(score) AS 最低,
       collect_list(stu_id) AS 学生列表,          -- 多行 → 数组
       collect_set(course_id) AS 课程去重集合      -- 多行 → 去重数组
FROM score_info GROUP BY course_id;
💡 collect_list/set 属于聚合函数但返回复杂类型,常配合 explode 使用。
📄 展开课件原文(第 7–17 页,共 11 页)
数学函数
掌握常用内置函数的使用方法,能够灵活运用Hive提供的数学函数。
在数据分析过程中,数值是最基础且最常见的数据类型,广泛应用于财务报表、业务指标等场景。数学函数作为直接处理数值的核心函数,可以执行诸如四舍五入、取绝对值等运 算,从而满足多样化的数值处理需求。数学函数在执行时会逐行计算,并为每一行返回一个 结果值。
关于Hive中常用内置聚合函数的介绍如表。
| 聚合函数 | 语法及描述 |
|---|---|
| round() | round(a):对数值a进行四舍五入,返回整数。 round(a,d):对数值a进行四舍五入,保留d(整数类型)位小数,返回浮点数 |
| floor() | floor(a):返回小于或等于数值a的最大整数 |
| ceil() | ceil(a):返回大于或等于数值a的最小整数 |
| rand() | rand():返回0到1之间的随机浮点数,每次调用都会产生不同的结果 rand(seed):返回0到1之间的随机浮点数,并指定种子seed。当种子固定时,每次调用的结果相同。seed为整数类型 |
| 聚合函数 | 语法及描述 |
|---|---|
| abs() | abs(a):返回数值a的绝对值 |
| greatest() | greatest(a,a,a,…):返回列表中的最大值。若任意一个值为NULL,则返回NULL。a可以是任意原生数据类型。若值之间的数据类型不兼容,则返回NULL |
| least() | least(a,a,a,…):返回列表中的最小值。若任意一个值为NULL,则返回NULL |
| bin() | bin(a):返回数字a的二进制格式字符串 |
| hex() | hex(a):返回a的十六进制字符串。若a为数值类型,则结果为对应数值的十六进制格式字符串;若a为字符串类型,则会将其中每个字符转换为对应的十六进制编码,并将这些编码依次拼接为一个完整的字符串 |
接下来,演示Hive中常用内置数学函数表中部分内置数学函数的使用,具体内容如下。
▸ 课件步骤 01
查询数据库chapter6中表demo_iot的数据,统计每个房间的平均相对湿度,并使用round()函数对结果进行四舍五入,保留一位小数,具体HiveQL语句如下。
SELECT loc,round(avg(humidity),1) AS humidity_avg
FROM chapter6.demo_iot GROUP BY loc;
▸ 课件步骤 02
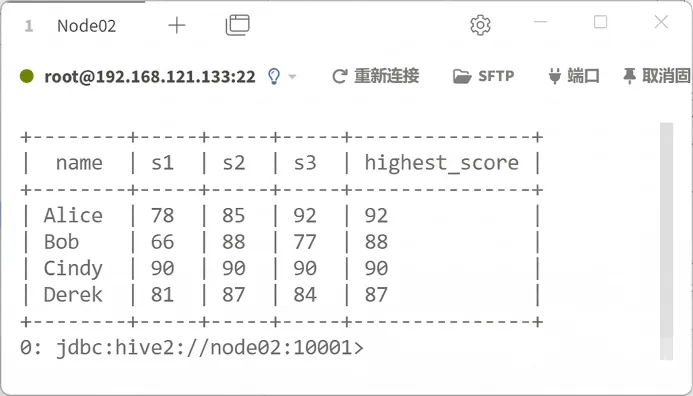
查询数据库chapter6中表demo_student_scores的数据,使用greatest()函数比较每个学生的三次测试成绩,并返回最高分,具体HiveQL语句如下。
SELECT name,s1,s2,s3,greatest(s1,s2,s3) AS highest_score
FROM chapter6.demo_student_scores;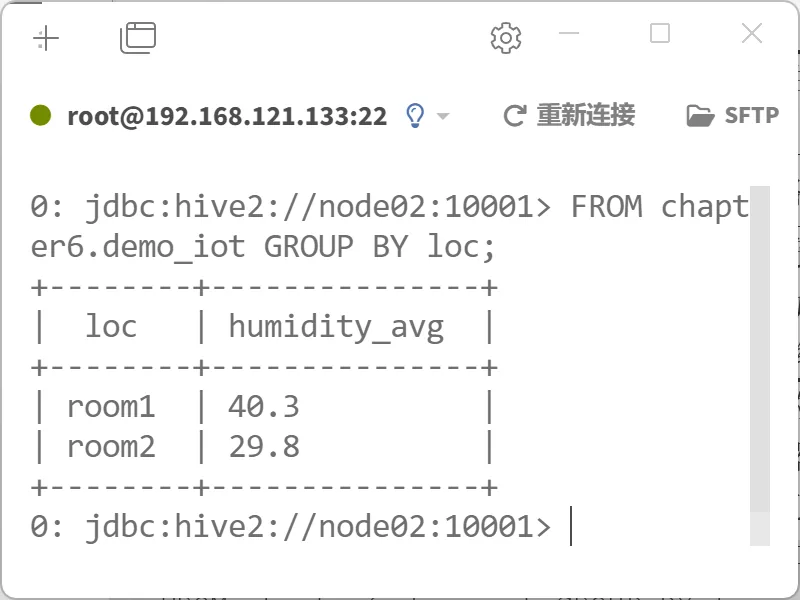
📄 展开课件原文(第 18–24 页,共 7 页)
集合函数
掌握常用内置函数的使用方法,能够灵活运用Hive提供的集合函数。
在数据复杂度不断提升的背景下,复杂数据类型在实际业务场景中愈发常见,由此催生了集合函数的应用需求。Hive中的集合函数主要针对复杂数据类型ARRAY和MAP,旨在便捷地查询和操作集合内部的元素。这类函数以集合类型的数据为输入,返回有关集合的某种统计或变换结果。它们在执行时逐行计算,并为每一行返回相应的结果。
关于Hive中常用内置集合函数的介绍如表。
| 集合函数 | 语法及描述 |
|---|---|
| size() | size(collection):返回ARRAY或MAP集合中元素的数量 |
| map_keys() | map_keys(map):返回MAP集合中所有键组成的数组 |
| map_values() | map_values(map):返回MAP集合中所有值组成的数组 |
| array_contains() | array_contains(array,value):判断ARRAY集合中是否包含给定的值value。若包含,则返回TRUE;否则返回FALSE |
| sort_array() | sort_array(array):返回ARRAY集合中元素按升序排序的结果 |
| 集合函数 | 语法及描述 |
|---|---|
| array_min() | array_min(array):返回ARRAY集合中的最小值 |
| array_max() | array_max(array):返回ARRAY集合中的最大值 |
| array_distinct() | array_distinct(array):返回ARRAY集合中元素去重后的结果 |
| array_join() | array_join(array,delimiter,replaceNull):将ARRAY集合中的元素根据分隔符delimiter拼接成字符串,并将NULL元素替换为replaceNull |
| array_except() | array_except(array1,array2):返回ARRAY集合中有但另一个ARRAY集合中没有的元素 |
| 集合函数 | 语法及描述 |
|---|---|
| array_intersect() | array_intersect(array1,array2):返回两个ARRAY集合的交集,并去除重复元素 |
| array_union() | array_union(array1,array2):返回两个ARRAY集合的并集,并去除重复元素 |
| array_remove() | array_remove(array,element):返回ARRAY集合中所有不等于element的元素 |
接下来,演示Hive中常用内置集合函数表中部分内置集合函数的使用,具体内容如下。
▸ 课件步骤 01
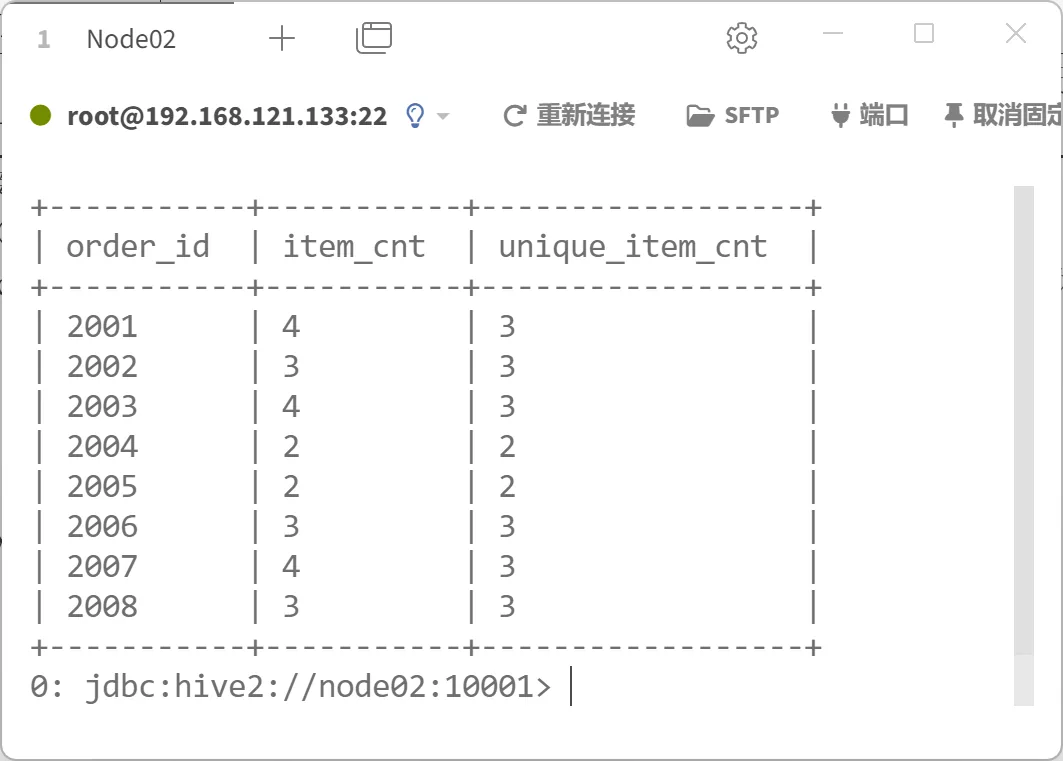
查询数据库chapter6中表demo_shop_orders的数据,使用size()和array_distinct()函数分别统计每个订单的商品总件数以及去重后的商品件数,具体HiveQL语句如下。
SELECT order_id,
size(items) AS item_cnt,
size(array_distinct(items)) AS unique_item_cnt
FROM chapter6.demo_shop_orders;
▸ 课件步骤 01
上述语句执行完成后的效果如图。
▸ 课件步骤 02
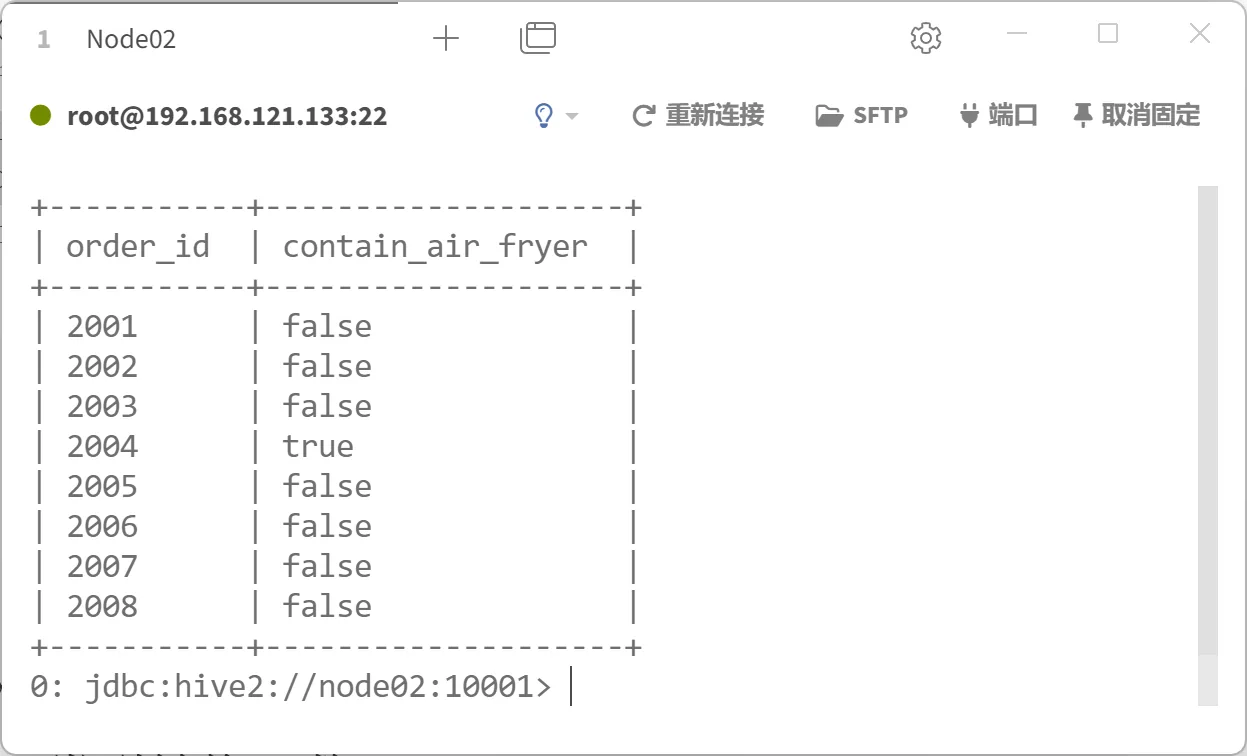
查询数据库chapter6中表demo_shop_orders的数据,使用array_contains()函数判断哪些订单包含商品空气炸锅,具体HiveQL语句如下。
SELECT order_id,array_contains(items,'空气炸锅') AS contain_air_fryer▸ 课件步骤 02
▸ 课件步骤 03
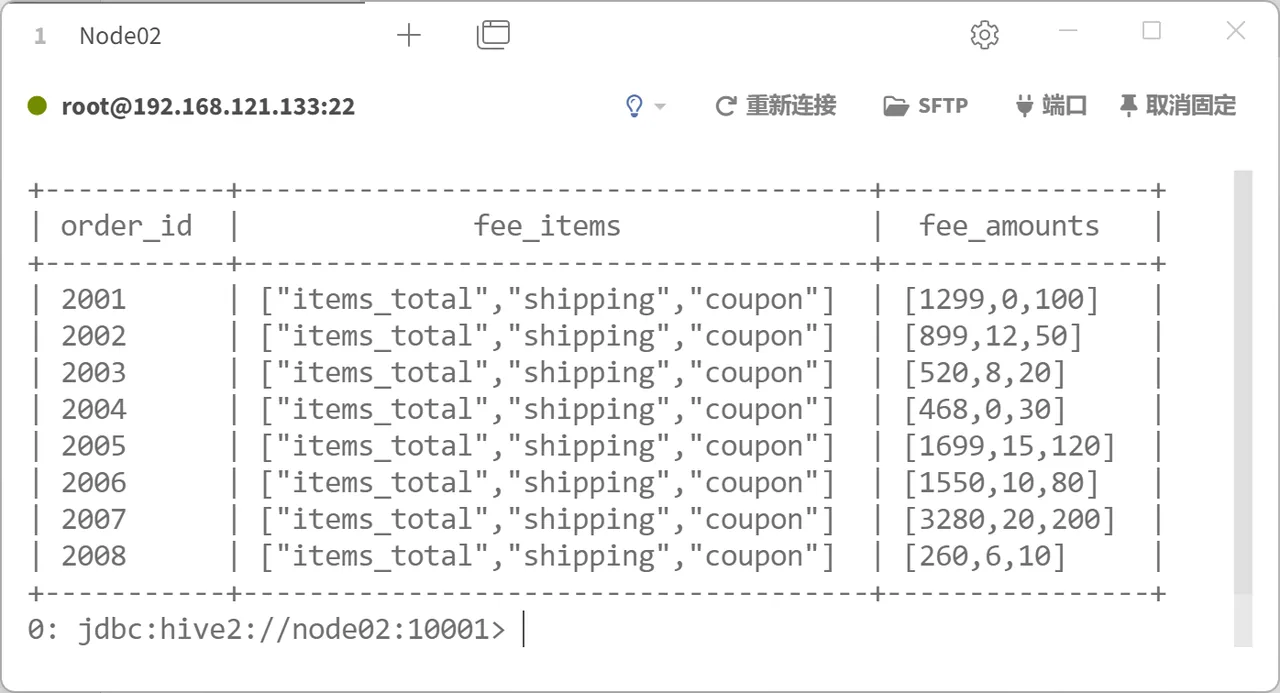
(3) 查询数据库chapter6中表demo_shop_orders的数据,使用map_keys()和map_values()函数获取每个订单的费用构成明细,具体HiveQL语句如下。
SELECT order_id,map_keys(fees) AS fee_items,map_values(fees) AS fee_amounts▸ 课件步骤 03
▸ 课件步骤 04
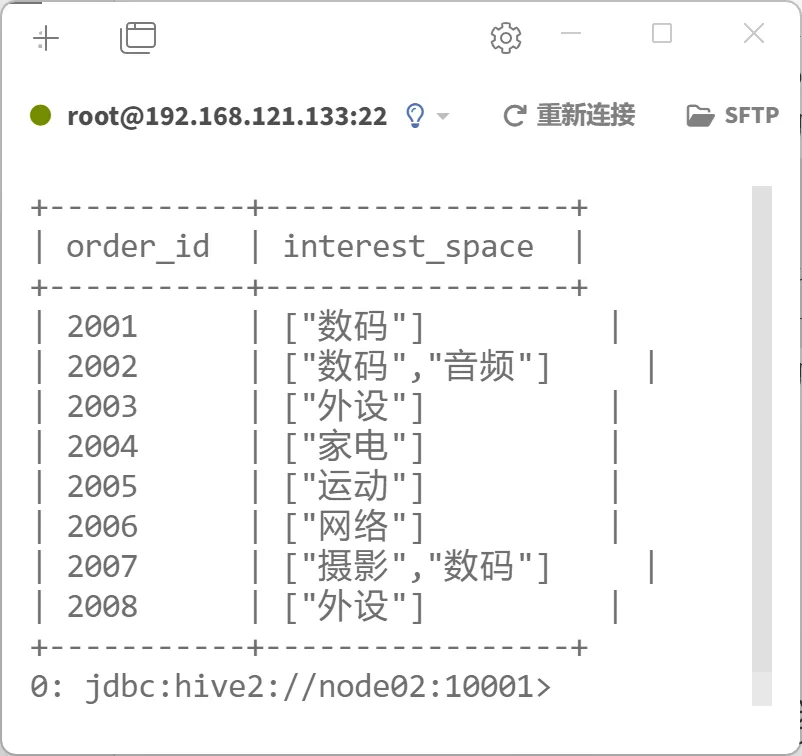
查询数据库chapter6中表demo_shop_orders的数据,使用array_intersect()函数检查下单时推荐给用户的品类中有哪些被用户实际购买,具体HiveQL语句如下。
SELECT
order_id,
array_intersect(categories, rec_categories) AS interest_space
▸ 课件步骤 04
📄 展开课件原文(第 25–38 页,共 14 页)
类型转换函数
掌握常用内置函数的使用方法,能够灵活运用Hive提供的类型转换函数。
在数据处理流程中,数据类型的一致性是确保分析结果准确性的前提。然而,不同数据源对同类数据的类型定义往往存在差异。为解决类型不兼容的问题,类型转换函数成为不可或缺的函数。
类型转换函数的作用是将数据从一种类型转换为另一种类型,从而消除类型不匹配带来的障碍,使不同类型的数据能够在同一计算环境下协同运算。无论是字符串、数值还是日期等常见类型,这类函数都能帮助我们在多种类型之间灵活切换,保证数据处理的连贯性和可操作性。
关于Hive中常用内置类型转换函数的介绍如表。
| 类型转换函数 | 语法及描述 |
|---|---|
| binary() | binary(value):将值value转换为BINARY类型 |
| cast() | cast(value as type):将值value转换为给定的type类型。若转换失败,则返回NULL |
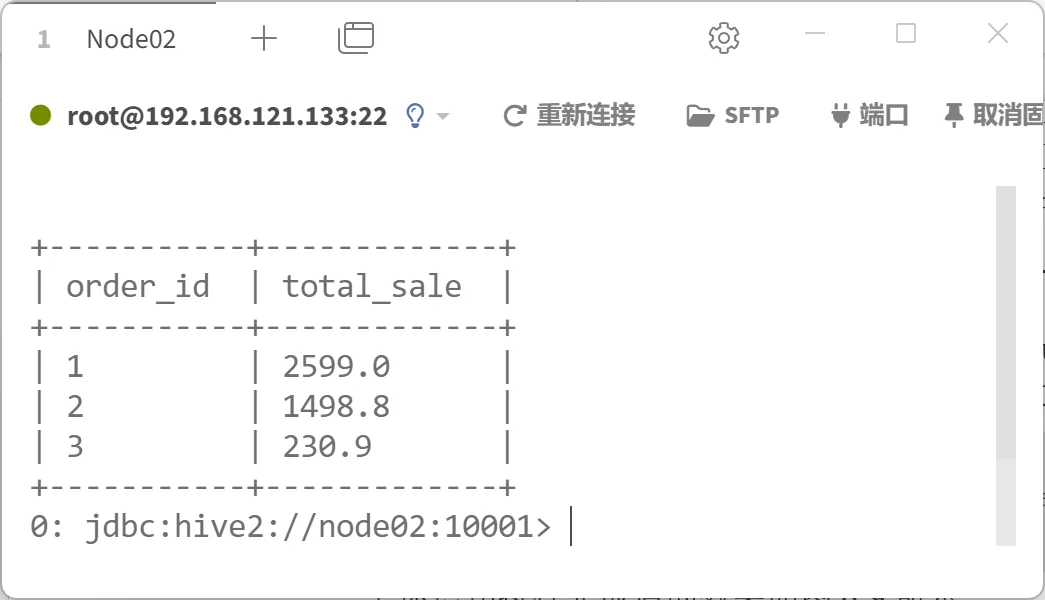
接下来,演示Hive中常用内置类型转换函数表中部分内置类型转换函数的使用。查询数据库chapter6中表demo_cast_orders的数据,使用cast()函数将qty和unit_price字段的值由字符串类型分别转换为INT和DECIMAL类型,并将二者相乘以计算每个订单的金额,具体HiveQL语句如下。
SELECT order_id,(cast(qty as INT) * cast(unit_price as DECIMAL(10,1))) AS total_saleFROM chapter6.demo_cast_orders;上述语句执行完成后的效果如图。
📄 展开课件原文(第 39–44 页,共 6 页)
日期函数
掌握常用内置函数的使用方法,能够灵活运用Hive提供的日期函数。
在日志分析、用户行为跟踪、趋势预测等场景中,日期与时间数据无处不在,对其进行处理是数据分析的核心任务之一。时间序列数据往往涉及复杂的计算逻辑,例如计算两个日期之间的间隔天数、从时间戳中提取特定字段,或按周期进行汇总统计。日期函数的引入,使这些复杂操作大大简化。
日期函数专门用于处理日期和时间数据,提供丰富的计算与格式化能力。借助这些函数,用户能够高效完成时间窗口聚合、日期格式转换等操作,让复杂的时间序列处理变得直观而高效。
关于Hive中常用内置日期函数的介绍如表。
| 日期函数 | 语法及描述 |
|---|---|
| unix_timestamp() | unix_timestamp(date_time):返回将时间戳或日期转换为Unix时间戳的结果,精度为秒 |
| to_date() | to_date(date_time):返回时间戳或日期的日期部分 |
| year() | year(date_time):返回时间戳或日期的年份部分 |
| quarter() | quarter(date_time):返回时间戳或日期对应的季度 |
| month() | month(date_time):返回时间戳或日期的月份部分 |
| 日期函数 | 语法及描述 |
|---|---|
| day() | day(date_time):返回时间戳或日期的日部分 |
| hour() | hour(time):返回时间戳的小时部分 |
| minute() | minute(time):返回时间戳的分钟部分 |
| second() | second(time):返回时间戳的秒部分 |
| weekofyear() | weekofyear(date_time):返回时间戳或日期对应的周 |
| 日期函数 | 语法及描述 |
|---|---|
| datediff() | datediff(end_date_time,start_date_time):返回两个时间戳或日期之间相差的天数。start_date_time表示开始时间戳或日期;end_date_time表示结束时间戳或日期 |
| date_add() | date_add(date_time,num):返回将时间戳或日期增加指定天数的结果。num用于指定增加的天数 |
| date_sub() | date_sub(date_time,num):返回将时间戳或日期减少指定天数的结果 |
| current_date() | current_date():返回查询执行开始时的当前日期 |
| current_timestamp() | current_timestamp():返回查询执行开始时的当前时间戳 |
| 日期函数 | 语法及描述 |
|---|---|
| add_months() | add_months(date_time,num,format):返回将时间戳或日期增加指定月份的结果,并按照指定格式format输出,默认格式为yyyy-MM-dd,表示年-月-日 |
| last_day() | last_day(date_time):返回时间戳或日期所在月份最后一天的日期 |
| months_between() | months_between(end_date_time,start_date_time):返回两个时间戳或日期之间相差的月份 |
| date_format() | date_format(date_time,format)):返回按指定格式将时间戳或日期格式化为字符串的结果 |
接下来,演示Hive中常用内置日期函数表中部分内置日期函数的使用,具体内容如下。
▸ 课件步骤 01
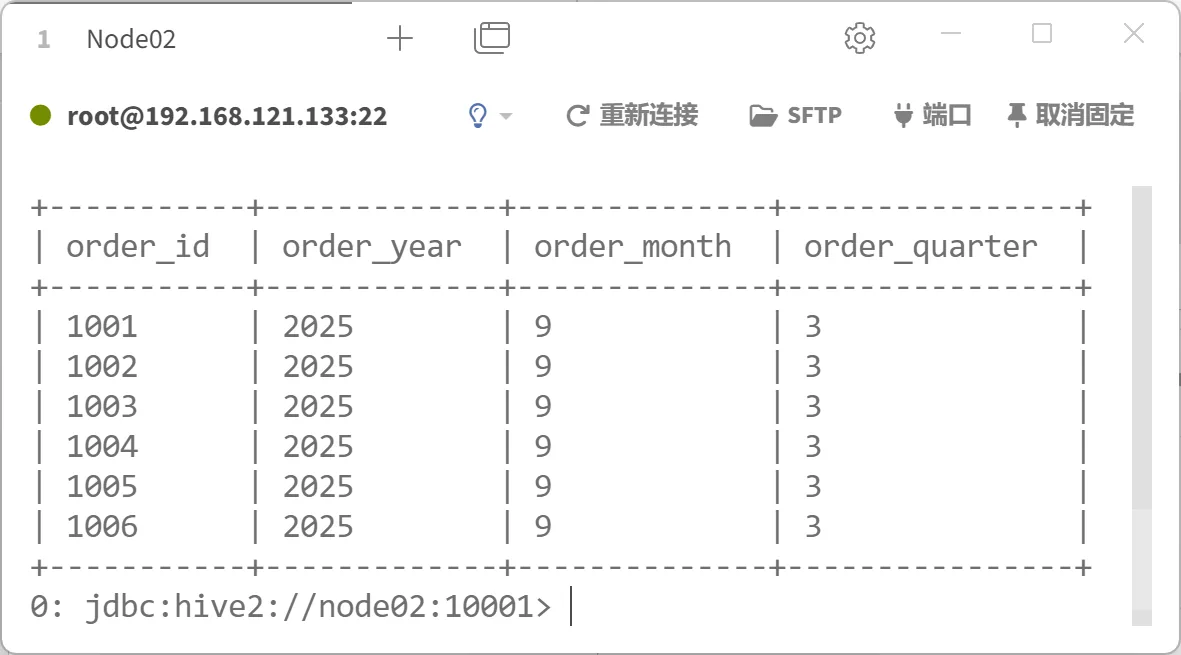
查询数据库chapter6中表demo_orders_time的数据,使用year()、month()和quarter()函数从每个订单的下单时间中获取年份、月份及对应的季度,具体HiveQL语句如下。
SELECT order_id,
year(order_time_str) AS order_year,
month(order_time_str) AS order_month,
quarter(order_time_str) AS order_quarter
FROM chapter6.demo_orders_time;▸ 课件步骤 01
上述语句执行完成后的效果如图。
▸ 课件步骤 02
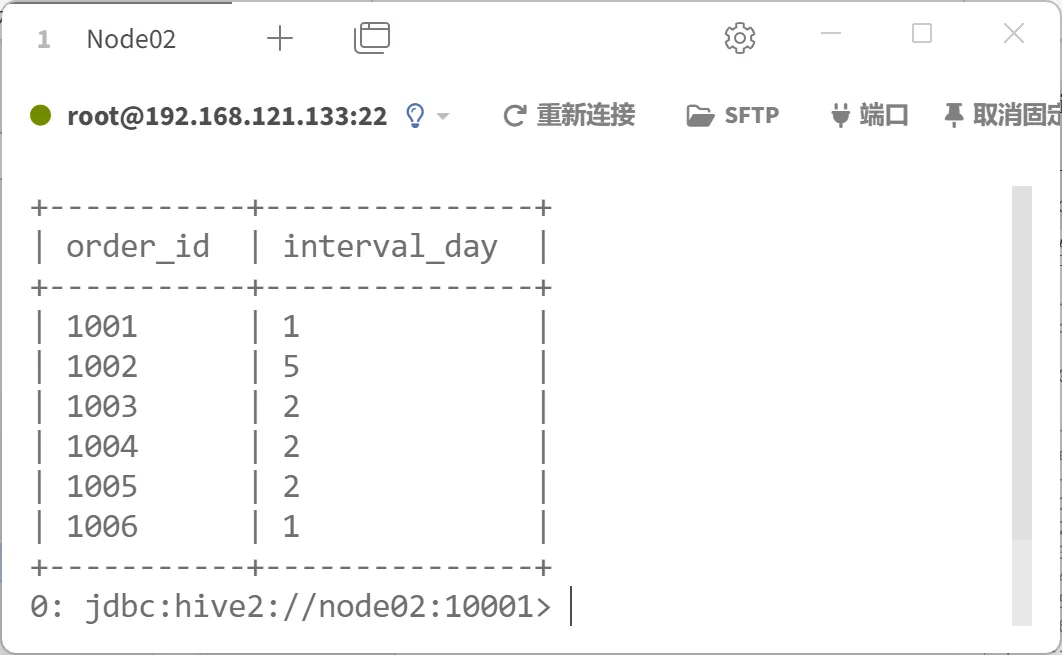
查询数据库chapter6中表demo_orders_time的数据,使用datediff()函数计算每个订单从下单到到货之间相隔的天数,具体HiveQL语句如下。
SELECT order_id,datediff(delivery_time_ts,order_time_str) AS interval_day▸ 课件步骤 02
▸ 课件步骤 03
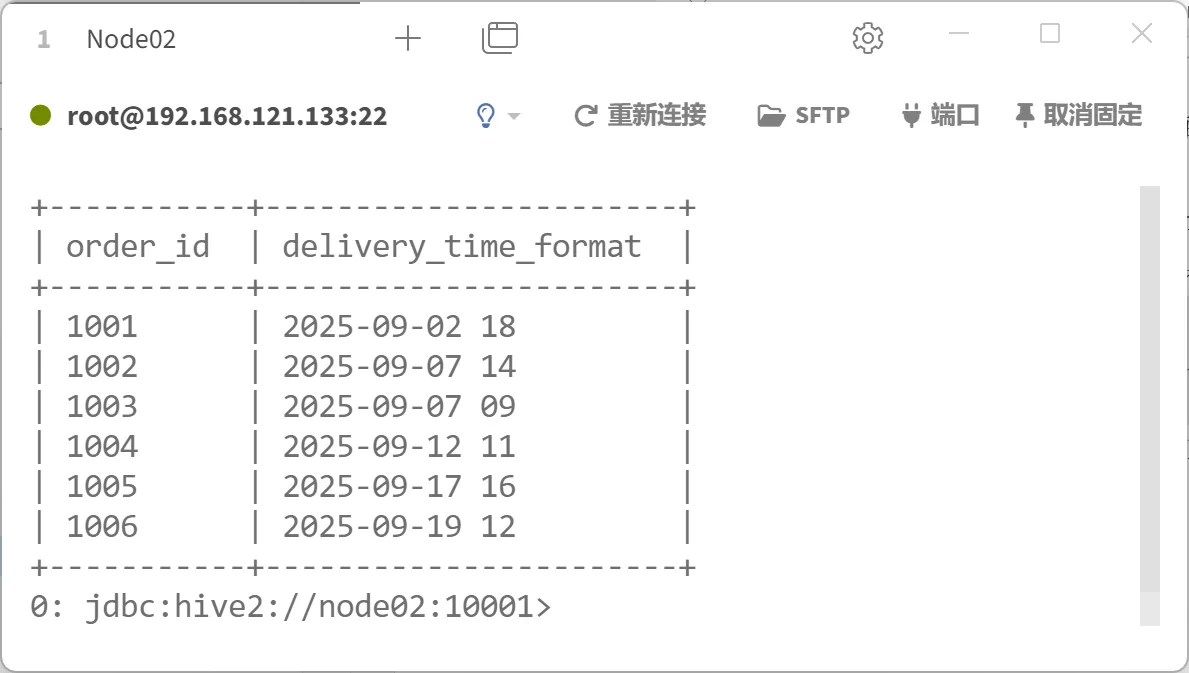
查询数据库chapter6中表demo_orders_time的数据,使用date_format ()函数将到货时间格式化为仅显示年月日和小时,具体HiveQL语句如下。
date_format(delivery_time_ts,'yyyy-MM-dd HH') AS delivery_time_format▸ 课件步骤 03
日期函数:格式化、取年月、算差值。
SELECT current_date()                          AS 今天,
       year(birthday)                           AS 出生年,
       month(birthday)                          AS 出生月,
       datediff(current_date(), birthday)       AS 天数差,
       date_add(birthday, 7)                    AS 加7天,
       date_format(birthday, 'yyyy/MM/dd')      AS 格式化
FROM student_info LIMIT 3;
💡 Hive 的日期格式串遵循 Java 的 SimpleDateFormat,与 MySQL 的 %Y-%m-%d 不同。
📄 展开课件原文(第 45–58 页,共 14 页)
条件函数
掌握常用内置函数的使用方法,能够灵活运用Hive提供的条件函数。
在数据清洗与转换过程中,经常需要根据不同条件采取差异化的处理策略。例如,在填补缺失值时需要判断字段是否为空,在数据标准化时需要针对不同范围应用不同规则。这类场景都离不开条件判断逻辑。条件函数的出现,使得在查询中实现基于条件的动态处理成为可能。通过嵌入条件函数,用户能够完成类似“如果...那么...”的灵活控制,大幅提升数据处理流程的智能性与可定制性。
条件函数是一类根据给定条件的真假返回不同结果的函数,类似于编程语言中的条件语句。但在HiveQL语句中,它们通过声明式语法简化了复杂逻辑的实现,从而显著提升了数据转换的效率与可读性。
关于Hive中常用内置条件函数的介绍如表。
| 条件函数 | 语法及描述 |
|---|---|
| if() | if(a,valueTrue,valueFalse):若布尔表达式a为TRUE,返回valueTrue;若布尔表达式a为FALSE或NULL,返回valueFalse |
| isnull() | isnull(a):若a为NULL,则返回TRUE;否则返回FALSE |
| isnotnull() | isnotnull(a):若a不为NULL,则返回TRUE;否则返回FALSE |
| nvl() | nvl(a,value):若a为NULL,则返回value;否则返回a |
| nullif() | nullif(a,b):若a=b,则返回NULL;否则返回a |
| CASE子句 | CASE a WHEN b THEN c [WHEN d THEN e] … [ELSE f] END:当a=b时,返回c;当a=d时,返回e;否则返回f CASE WHEN a THEN b [WHEN c THEN d] … [ELSE e] END:当布尔表达式a为TRUE时,返回b;当布尔表达式c为TRUE时,返回d;否则返回e |
接下来,演示Hive中常用内置条件函数表中部分内置条件函数的使用,具体内容如下。
▸ 课件步骤 01
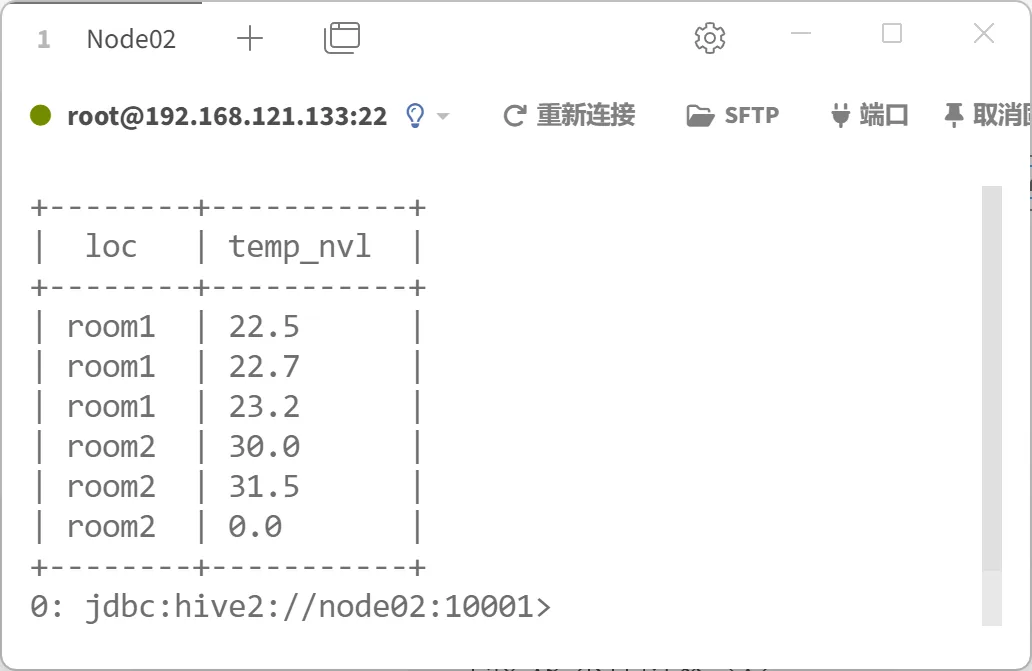
查询数据库chapter6中表demo_iot的数据,使用nvl()函数获取每条记录的温度,若温度为NULL,则替换为0,具体HiveQL语句如下。
SELECT loc,nvl(temp,0) AS temp_nvl
FROM chapter6.demo_iot;
上述语句执行完成后的效果如图。
▸ 课件步骤 02
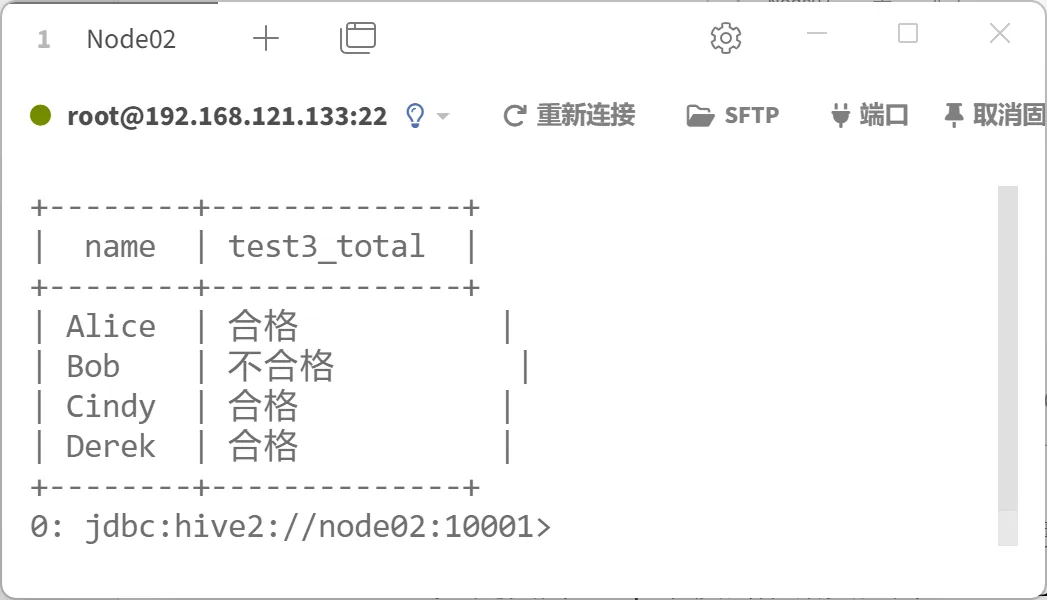
查询数据库chapter6中表demo_student_scores的数据,使用if()函数判断每个学生三次测试成绩的总和是否大于或等于240;若是,则返回合格,否则返回不合格,具体HiveQL语句如下。
SELECT name,if(s1+s2+s3 >= 240,'合格','不合格') AS test3_total
FROM chapter6.demo_student_scores;
▸ 课件步骤 03
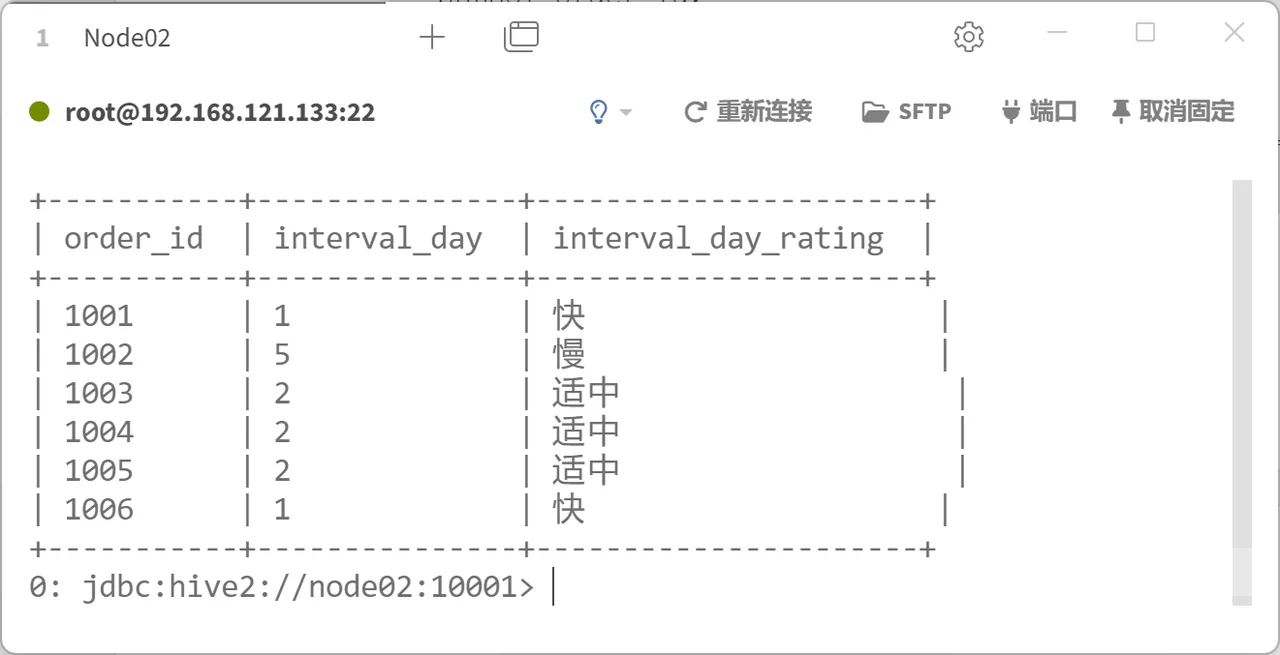
查询数据库chapter6中表demo_orders_time的数据,计算每个订单从下单到到货之间的天数,并使用CASE子句按天数范围进行评级:当小于或等于1天时,返回快;当大于1天且小于等于3天时,返回适中;当超过3天时,返回慢,具体HiveQL语句如下。
点击查看
▸ 课件步骤 03
条件函数:把数值翻译成业务含义。
SELECT stu_id, score,
       IF(score >= 60, '及格', '不及格')                     AS 是否及格,
       CASE WHEN score >= 90 THEN 'A'
            WHEN score >= 80 THEN 'B'
            WHEN score >= 60 THEN 'C'
            ELSE 'D' END                                   AS 等级,
       COALESCE(NULL, NULL, '默认值')                        AS 空值兜底,
       NVL(NULL, 0)                                        AS 空值补0
FROM score_info WHERE course_id = '01' LIMIT 5;
💡 COALESCE 取第一个非空值(可多个参数),NVL 只接受两个参数。
📄 展开课件原文(第 59–67 页,共 9 页)
字符串函数
掌握常用内置函数的使用方法,能够灵活运用Hive提供的字符串函数。
在实际业务数据中,大量信息以文本形式存在,如日志记录、用户评论、产品描述等。如何高效地清洗、解析与格式化这些字符串,往往直接决定数据分析的成败。字符串函数为文本处理提供了丰富的能力,使各类字符串操作变得简洁高效。借助这些函数,用户不仅可以轻松提取所需的文本片段、调整大小写格式,还能通过模式匹配从非结构化文本中提取结构化信息,在日志解析和文本分析等场景中发挥关键作用。
关于Hive中常用内置字符串函数的介绍如表。
| 字符串函数 | 语法及描述 |
|---|---|
| base64() | base64(bin):将二进制数据bin转换为Base64字符串 |
| decode() | decode(bin,charset):根据指定的字符集charset,将二进制数据bin解码为字符串。常见字符集包括UTF-8、ISO-8859-1等。charset为字符串类型 |
| encode() | encode(str,charset):根据指定的字符集charset,将字符串str编码为二进制数据 |
| length() | length(str):返回字符串str的长度 |
| concat() | concat(str,str,str,…):将多个字符串str按顺序拼接成新的字符串 |
| 字符串函数 | 语法及描述 |
|---|---|
| concat_ws() | concat_ws(delimiter,str,str,str,…):将多个字符串str通过指定分隔符delimiter按顺序拼接成新的字符串。delimiter为字符串类型 concat_ws(delimiter,array):将ARRAY集合中的元素通过指定分隔符delimiter按顺序拼接成字符串 |
| format_number() | format_number(number,d):将数字number通过四舍五入的方式保留指定位数d的小数,并格式化为千分位分隔符形式的字符串。d为整数类型 |
| get_json_object() | get_json_object(json_string,path):根据指定的JSON路径path从JSON字符串json_string中提取JSON对象。若输入的JSON字符串无效,则返回NULL。JSON路径只能包含[0-9a-z_]字符,不能包含大写字母或特殊字符 |
| 字符串函数 | 语法及描述 |
|---|---|
| instr() | instr(str,substr):返回字符串substr在字符串str中第一次出现的位置,计数从1开始。若任意一个字符串为NULL,则返回NULL;若字符串substr不在字符串str中,则返回0 |
| lower() | lower(str):将字符串str的所有字母转换为小写 |
| upper() | upper(str) :将字符串str的所有字母转换为大写 |
| initcap() | initcap(str) :将字符串str中每个单词(通常按空格拆词)的首字母转换为大写、其余字母转换为小写 |
| lpad() | lpad(str,len,pad):从字符串str的左侧不断填充字符串pad,直到其长度达到指定的len |
| 字符串函数 | 语法及描述 |
|---|---|
| rpad() | rpad(str,len,pad):从字符串str的右侧不断填充字符串pad,直到其长度达到指定的len |
| ltrim() | ltrim(str):去掉字符串str左侧的空格 |
| rtrim() | rtrim(str) :去掉字符串str右侧的空格 |
| trim() | trim(str) :去掉字符串str两侧的空格 |
| parse_url() | parse_url(str,part[,key]):解析URL字符串str,并返回URL的特定部分。part为字符串类型,用于指定返回的部分,可选值包括HOST、PATH、QUERY、REF、PROTOCOL、AUTHORITY、FILE和USERINFO,分别表示URL的主机名、路径、查询字符串、片段、协议、权限、路径的最后一段(常被视为文件名)和用户信息。key(可选)为字符串类型,用于从URL的查询字符串中获取指定键对应的值 |
| 字符串函数 | 语法及描述 |
|---|---|
| regexp_extract() | regexp_extract(str,pattern,idx):使用正则表达式pattern从字符串str中提取匹配的子字符串。idx用于指定要返回的正则表达式分组序号,0表表示返回整个匹配结果,1表示返回第一个分组,以此类推 |
| regexp_replace() | regexp_replace(str,pattern,replace):使用正则表达式pattern替换字符串str中所有匹配的字符串replace |
| replace() | replace(str,old_str,new_str):将字符串str中所有匹配的子字符串old_str替换为字符串new_str |
| 字符串函数 | 语法及描述 |
|---|---|
| repeat() | repeat(str,n):将字符串str重复n次并进行拼接 |
| reverse() | reverse(str):将字符串str的字符顺序倒置 |
| split() | split(str, delimiter):将字符串str通过指定分隔符delimiter分隔为ARRAY集合 |
| str_to_map() | str_to_map(str[,delimiter1,delimiter2]):将字符串str通过指定分隔符分隔为MAP集合,其中delimiter1(可选)用于指定元素之间的分隔符,默认为逗号;delimiter2(可选)用于指定键和值之间的分隔符,默认为冒号 |
接下来,演示Hive中常用内置字符串函数表中部分内置字符串函数的使用,具体内容如下。
▸ 课件步骤 01
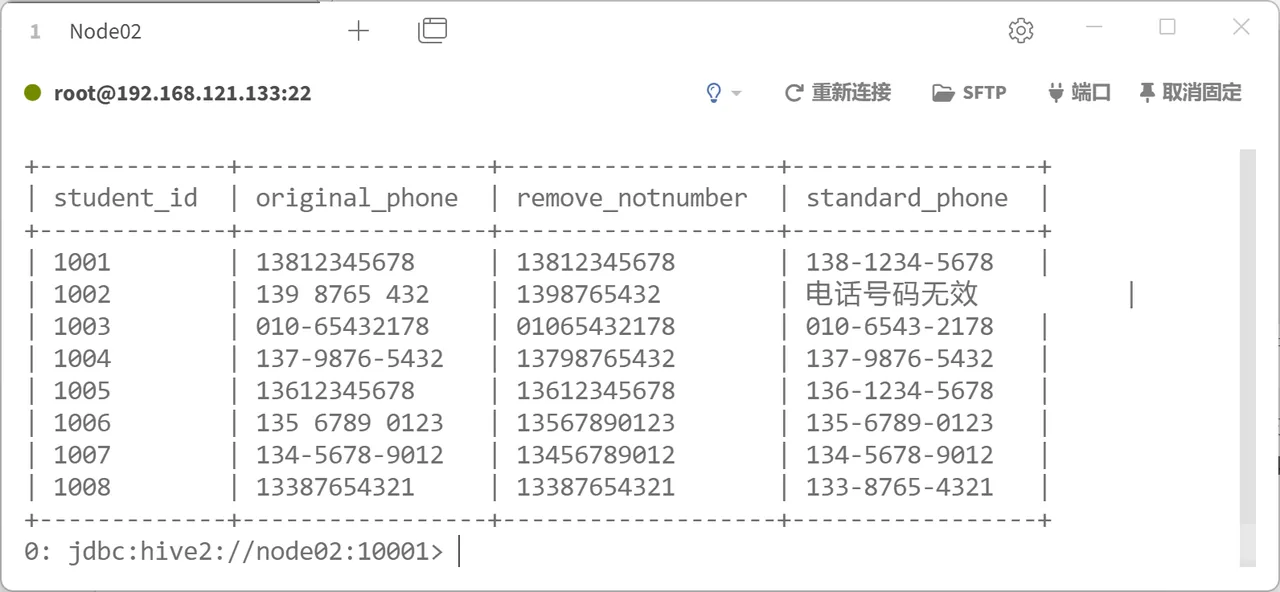
查询数据库chapter6中表demo_student_info的数据,使用length()、concat()、substr()和regexp_replace()函数将联系电话格式化为xxx-xxxx-xxxx的形式,具体HiveQL语句如下。
点击查看
▸ 课件步骤 01
上述语句执行完成后的效果如图。
▸ 课件步骤 02
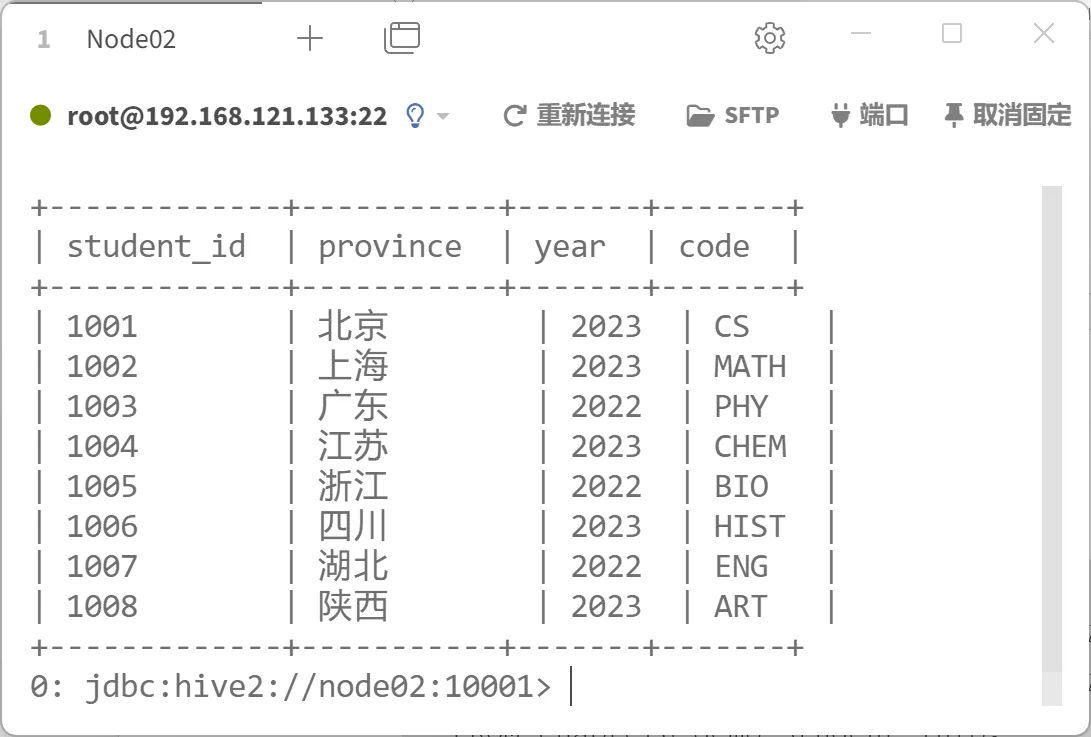
查询数据库chapter6中表demo_student_info的数据,使用regexp_extract()和split()函数从学生地址和入学信息中提取行政区、入学年份和专业代码,具体HiveQL语句如下。
SELECT student_id,regexp_extract(address,
'^(.+?)(?:省|市|自治区|特别行政区)',
1) AS province,
split(enrollment_info, '-')[0] AS year,
split(enrollment_info, '-')[1] AS code
FROM chapter6.demo_student_info;
▸ 课件步骤 02
▸ 课件步骤 03
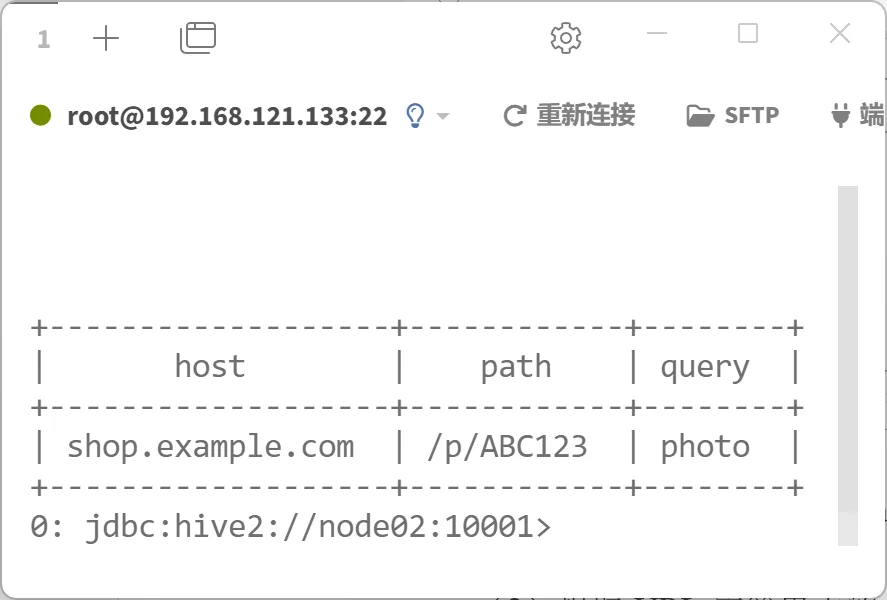
使用parse_url()函数提取URL字符串中的主机名、路径和查询字符串中键为kw的值,具体HiveQL语句如下。
SELECT
parse_url(
'https://shop.example.com/p/ABC123?ref=ad01&kw=photo',
'HOST') AS host,
'PATH') AS path,
'QUERY','kw') AS query;▸ 课件步骤 03
字符串清洗四件套:拼接、截取、替换、去空格。
SELECT concat(stu_name, '-', sex)          AS 拼接,
       substr(stu_name, 1, 1)             AS 首字,
       regexp_replace(birthday, '-', '/') AS 替换,
       trim('  abc  ')                    AS 去空格,
       length(stu_name)                   AS 长度
FROM student_info LIMIT 3;
💡 regexp_replace 用 Java 正则;split 返回数组,取第 1 个用 split(s,',')[0]。
📄 展开课件原文(第 68–82 页,共 15 页)
表生成函数
掌握常用内置函数的使用方法,能够灵活运用Hive提供的表生成函数。
在处理复杂数据类型时,常常需要将一行记录中的嵌套数据拆解成多行,以便进行更灵活的分析。这类将行内数据展开的需求由表生成函数来实现。表生成函数能够将单列数据扩展为多行输出,使原本嵌套在一行中的多值结构被拆解为多条独立记录。借助这一特性,可以对ARRAY集合中的每个元素单独处理,或将JSON对象的各字段拆分为独立行,从而显著增强Hive处理复杂数据的能力。
关于Hive中常用内置表生成函数的介绍如表。
| 表生成函数 | 语法及描述 |
|---|---|
| explode() | explode(array):将ARRAY集合中的每个元素拆分为多行,输出在单个字段中。可以通过AS子句为该字段指定别名,若未指定,则默认字段名为col explode(map):将MAP集合中的每个键值对拆分为一行,键和值分别输出在两个字段中。可以通过AS子句为这两个字段指定别名,若未指定,则默认字段名为key和value |
| posexplode() | posexplode(array):将ARRAY集合中的每个元素和元素的索引位置拆分为一行,元素和索引位置输出在两个字段中。可以通过AS子句为这两个字段指定别名,若未指定,则默认字段名为pos和val |
| 表生成函数 | 语法及描述 |
|---|---|
| json_tuple() | json_tuple(json_str,key,key,…):用于从JSON字符串json_str中一次性读取多个顶层键key的值,将每个键对应的值输出到不同字段。可以通过AS子句为这些字段指定别名 |
| parse_url_tuple() | parse_url_tuple(url_str,part,part,…):用于从URL字符串url_str中一次性读取URL的多个部分,将每个部分的值输出到不同字段。可以通过AS子句为这些字段指定别名。part的可选值与字符串函数parse_url()中的part一致 |
接下来,演示Hive中常用内置表生成函数表中部分内置表生成函数的使用,具体内容如下。
▸ 课件步骤 01
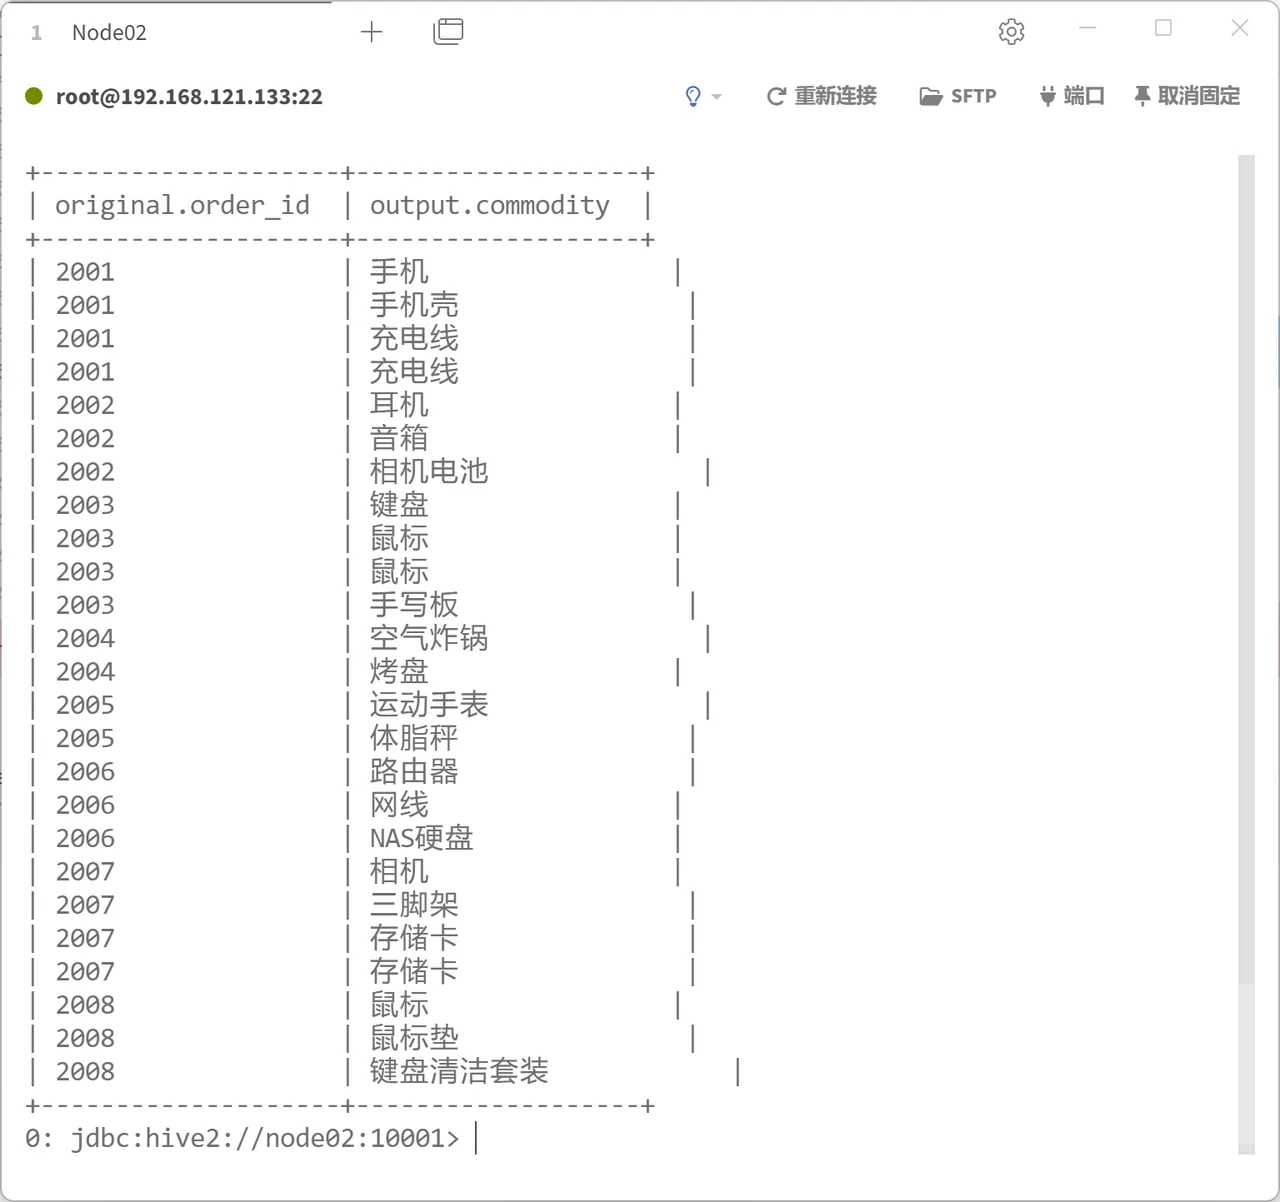
查询数据库chapter6中表demo_shop_orders的数据,使用explode()函数获取每个订单包含的商品,具体HiveQL语句如下。
SELECT original.order_id,output.commodityFROM chapter6.demo_shop_orders original
LATERAL VIEW explode(items) output AS commodity;▸ 课件步骤 01
上述语句执行完成后的效果如图。
▸ 课件步骤 02
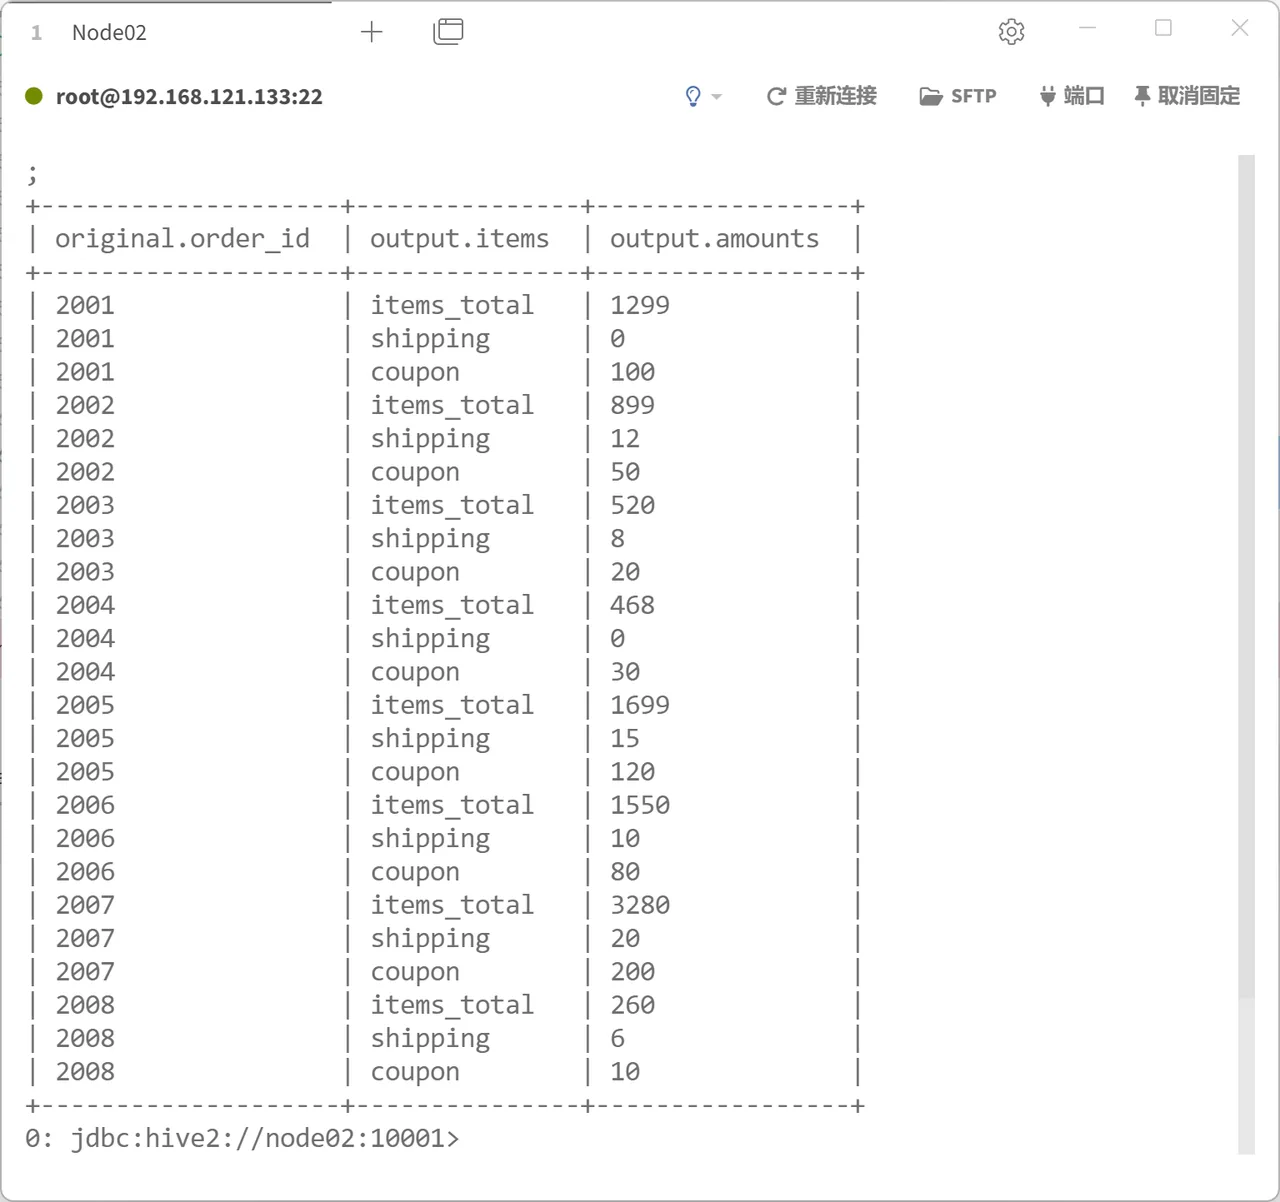
查询数据库chapter6中表demo_shop_orders的数据,使用explode()函数获取每个订单的费用构成明细,具体HiveQL语句如下。
SELECT original.order_id,output.items,output.amountsLATERAL VIEW explode(fees) output AS items,amounts;▸ 课件步骤 02
任务:使用窗口函数
6.2
📄 展开课件原文(第 83–92 页,共 10 页)
使用窗口函数
熟悉窗口函数的语法结构,能够根据数据处理需求选择不同类型的窗口函数。
窗口函数(Window Function)也称开窗函数,它是数据库用于在一组相关的行上进行计算的特殊函数。不同于常规的聚合函数只能对表或每组数据中的所有行执行运算,并输出单行,窗口函数可以扫描多行并计算每行的输出值,不会减少查询结果的行数。
简单来说,窗口函数允许我们在不丢失明细行的情况下,针对定义的窗口计算聚合或排名等结果,每一行都会返回一个针对其所属窗口的计算结果。这使得我们能够实现更复杂的计算和分析,在报表和数据分析场景中非常有用。
在Hive中,窗口函数通过SELECT语句中的OVER子句定义,其基本语法结构如下。
function OVER (
[PARTITION BY partition_col_list]
[ORDER BY order_col_list [ASC|DESC]]
[window_expression]
)
接下来,针对上述语法中的参数进行介绍。
function参数用于定义每个窗口内处理数据的函数,支持以下三种函数类型。
1. function参数
窗口聚合函数
A
窗口排序函数
B
窗口分析函数
C
窗口聚合函数用于对窗口内的数据进行汇总,支持内置聚合函数和自定义聚合函数。
窗口排序函数用于对窗口内的数据进行编号。Hive中常用窗口排序函数的介绍如表。
| 窗口排序函数 | 语法及描述 |
|---|---|
| row_number() | row_number():为每行分配一个从1开始递增的唯一序列号 |
| rank() | rank():为每行分配一个从1开始递增的序列号。若排序字段值相同,则并列使用同一序列号,且后续序列号将跳号。例如,两条并列最高的记录序列号均为1,下一条记录的序列号为3 |
| dense_rank() | dense_rank():类似rank()函数,但序列号不会跳号。例如,两条并列最高的记录序列号均为1,下一条记录的序列号为2 |
窗口分析函数用于在窗口内按相对位置取值。Hive中常用窗口分析函数的介绍如表。
| 窗口分析函数 | 语法及描述 |
|---|---|
| lead() | lead(col[,n,default]):返回当前行向后第n行中字段col的值。若超出窗口边界,则返回default。因此,在窗口内的最后一行,不论向后多少行,结果都会超出窗口边界并返回default。n和default为可选,默认值分别为1和NULL |
| lag() | lag(col[,n,default]):返回当前行向前第n行中字段col的值。若超出窗口边界,则返回default。因此,在窗口内的第一行,不论向前多少行,结果都会超出窗口边界并返回default |
| 窗口分析函数 | 语法及描述 |
|---|---|
| first_value() | first_value(col):返回第一行中指定字段col的值 |
| last_value() | last_value(col):返回最后一行中指定字段col的值 |
PARTITION BY子句为可选,用于将查询结果按指定窗口字段划分到不同窗口。partition_col_list参数用于指定具体的窗口字段,多个窗口字段之间使用逗号分隔。若未指定PARTITION BY子句,则默认将全部数据视为一个窗口。
2. PARTITION BY 子句
ORDER BY子句为可选,用于将每个窗口内的数据按指定排序字段进行排序。order_col_list参数用于指定具体的排序字段,多个排序字段之间使用逗号分隔。ASC为默认,表示升序排序,DESC表示降序排序。若未指定ORDER BY子句,则窗口内的数据不进行排序。
3. ORDER BY 子句
window_expression参数为可选,用于定义窗口表达式,以限制每个窗口中参与计算的数据范围(闭区间),具体语法格式如下。
4. window_expression参数
ROWS BETWEEN start AND end表示基于行定义窗口表达式
参数start和end分别用于指定数据范围的下界和上界,支持以下几种格式。
UNBOUNDED PRECEDING:
n PRECEDING:
CURRENT ROW:
表示从当前行开始或结束,可用于上/下界。
表示从第一行开始,仅可用于下界。
表示从当前行向前第n行开始或结束,可用于上/下界。
n FOLLOWING:表示从当前行向后第n行开始或结束,可用于上/下界。
UNBOUNDED FOLLOWING:表示从最后一行结束,仅可用于上界。
下面,通过示例代码介绍通过ROWS BETWEEN子句定义窗口表达式的含义,具体代码如下。
ROWS BETWEEN 6 PRECEDING AND CURRENT ROW接下来,演示窗口函数的使用,具体内容如下。
▸ 课件步骤 01
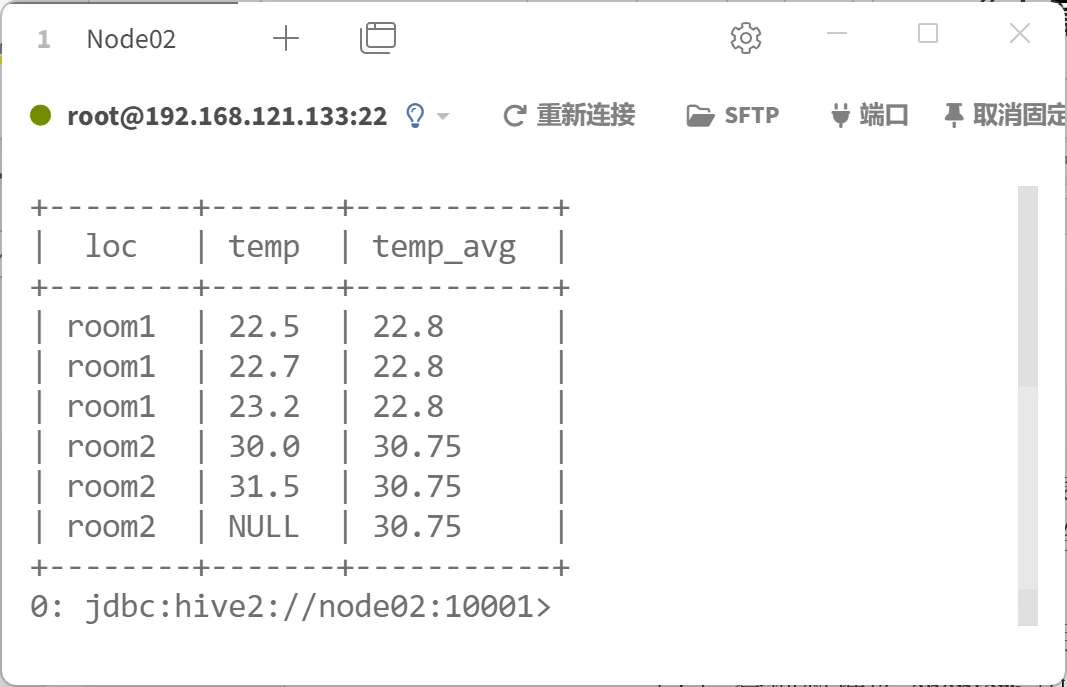
查询数据库chapter6中表demo_iot的数据,使用avg()函数统计每个房间的平均温度,具体HiveQL语句如下。
SELECT loc,temp,avg(temp) OVER (PARTITION BY loc) AS temp_avg
FROM chapter6.demo_iot;
▸ 课件步骤 01
上述语句执行完成后的效果如图。
▸ 课件步骤 02
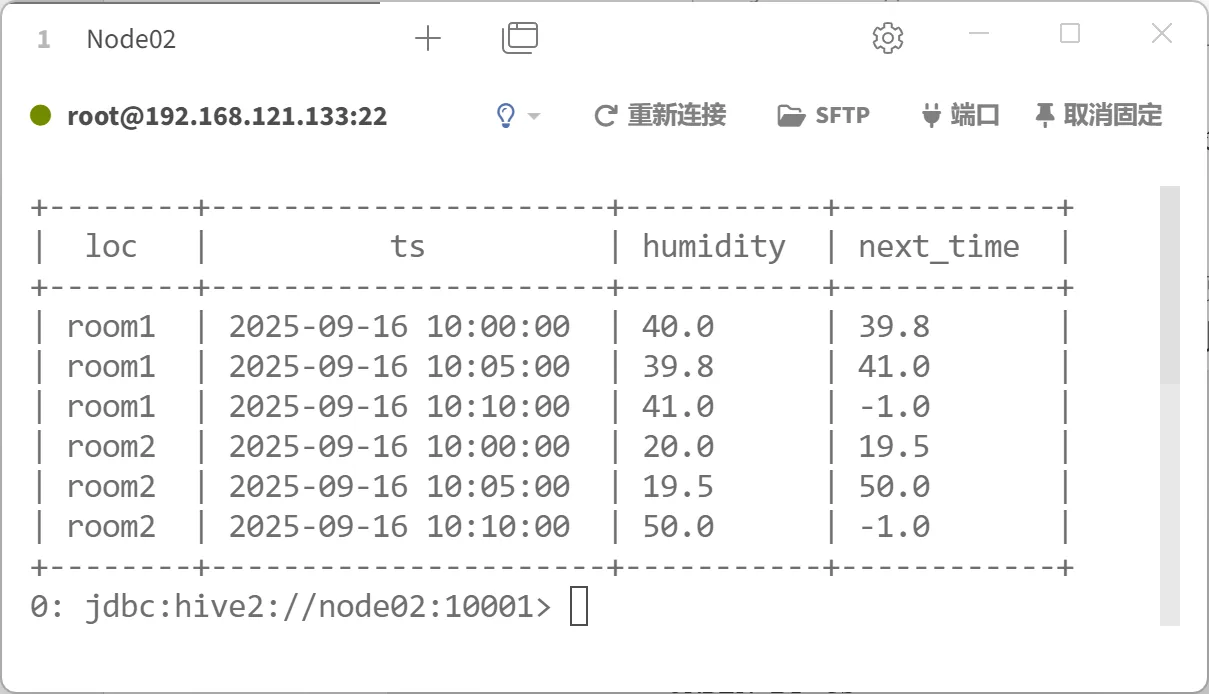
查询数据库chapter6中表demo_iot的数据,使用lead()函数获取每个房间内每条相对湿度记录下一时间点的相对湿度,以便对比相邻时刻的变化趋势,具体HiveQL语句如下。
点击查看
▸ 课件步骤 02
▸ 课件步骤 03
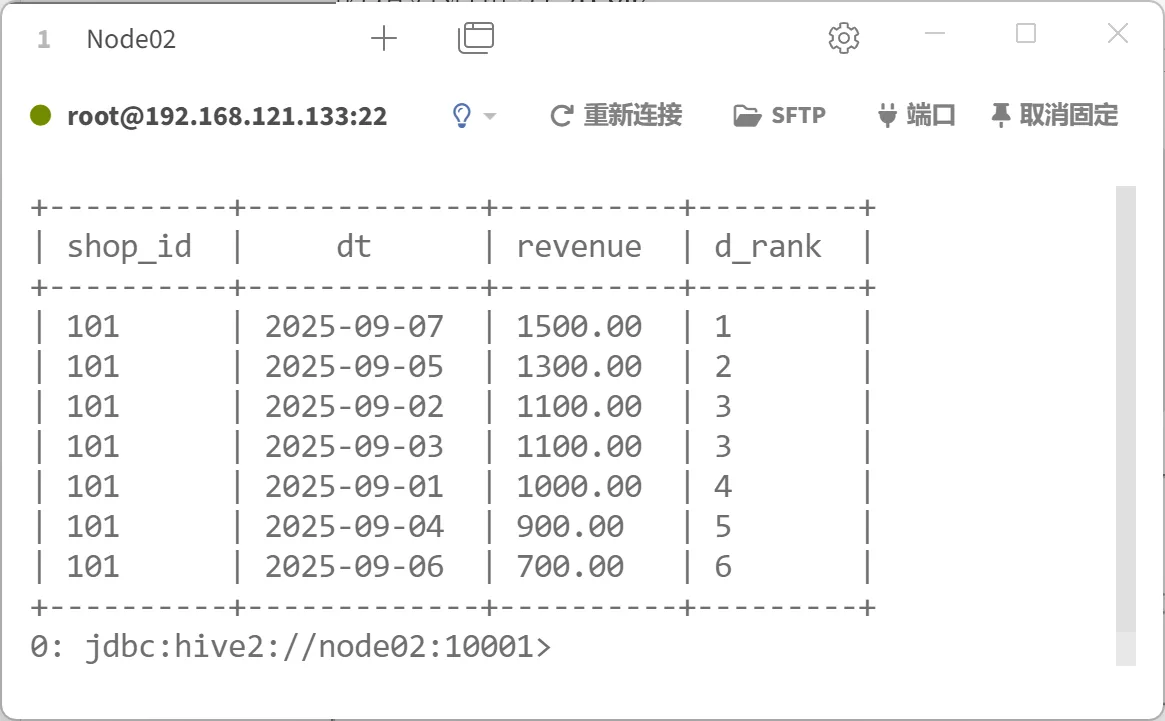
查询数据库chapter6中表demo_sales_daily的数据,针对ID为101的门店,使用dense_rank()函数统计不同日期的营收排名,具体HiveQL语句如下。
SELECT
shop_id,dt,revenue,
dense_rank() OVER (PARTITION BY shop_id ORDER BY revenue DESC) AS d_rankFROM chapter6.demo_sales_daily
WHERE shop_id = 101;▸ 课件步骤 03
▸ 课件步骤 04
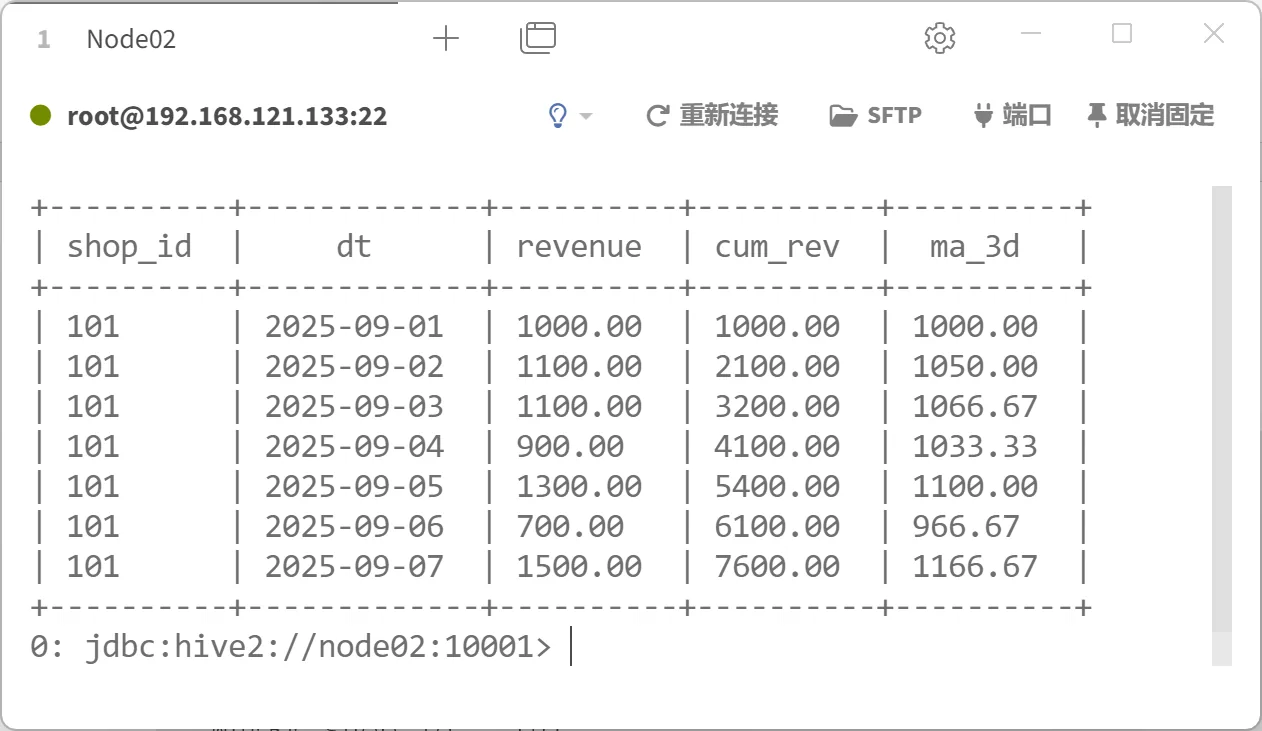
查询数据库chapter6中表demo_sales_daily的数据,针对ID为101的门店,使用窗口表达式分别计算按日期的累计营收,以及近三天(含当日)的平均营收,具体HiveQL语句如下。
▸ 课件步骤 04
通过RANGE BETWEEN子句定义窗口表达式
RANGE BETWEEN子句基于排序字段的值定义窗口表达式,适用于日期、数值等连续型数据。参数start和end依然用于指定数据范围的下界和上界,但在RANGE BETWEEN子句中的含义有所不同,具体介绍如下。
表示从第一行的排序字段值开始,仅可用于下界。
表示从当前行的排序字段值减去n的值开始或结束。
表示从当前行的排序字段值开始或结束。
表示从当前行的排序字段值加上n的值开始或结束。
表示从最后一行的排序字段值结束,仅可用于上界。
下面,通过示例代码介绍通过RANGE BETWEEN子句定义窗口表达式的含义,具体代码如下。
RANGE BETWEEN 6 PRECEDING AND CURRENT ROW上述代码定义的窗口表达式表示从当前行的排序字段值减去6的值开始,到当前行的排序字段值结束。凡是排序字段值在这一范围内的行均纳入计算范围。
任务:开发自定义函数
6.3
📄 展开课件原文(第 93–119 页,共 27 页)
6.3 开发自定义函数
开发自定义函数(任务导学)
Hive虽然内置了大量函数,但在一些特定业务场景中仍可能无法完全满足需求。此时,自定义函数为用户提供了扩展Hive功能的途径。通过实现自定义函数,可以将业务逻辑封装为Hive可调用的组件,在查询中灵活实现个性化的数据处理。Hive支持三类自定义函数,分别是UDF(User-Defined Function,用户定义函数)、UDTF(User-Defined Table-Generating Function,用户定义表生成函数)和UDAF(User-Defined Aggregate Function,用户定义聚合函数)。本任务将围绕这三类函数的概念与实现方式进行介绍。
📄 展开课件原文(第 120–120 页,共 1 页)
准备开发环境
了解自定义函数的开发流程,能够完成开发环境的准备。
在实现Hive自定义函数之前,需要先完成基础开发环境的准备。由于自定义函数通常采用Java语言实现,所以接下来将重点介绍Java开发环境的准备,主要包含以下几个方面。
安装项目管理工具Maven。本教材使用的版本为3.9.9。
安装Java集成开发工具IntelliJ IDEA。本教材使用的版本为2024.1.2。
安装JDK。本教材使用的版本与部署Hive时保持一致,均为JDK 17。
在IntelliJ IDEA中基于Maven创建Java项目,并添加Hive依赖。
关于IntelliJ IDEA、JDK和Maven的安装,读者可参考本书配套资源中的补充文档,这里不再赘述。接下来,我们重点介绍如何在IntelliJ IDEA中创建Java项目,并添加Hive依赖,具体操作步骤如下。
▸ 课件步骤 01
打开IntelliJ IDEA,进入Welcome to IntelliJ IDEA界面,如图。
单击“New Project”按钮
▸ 课件步骤 02
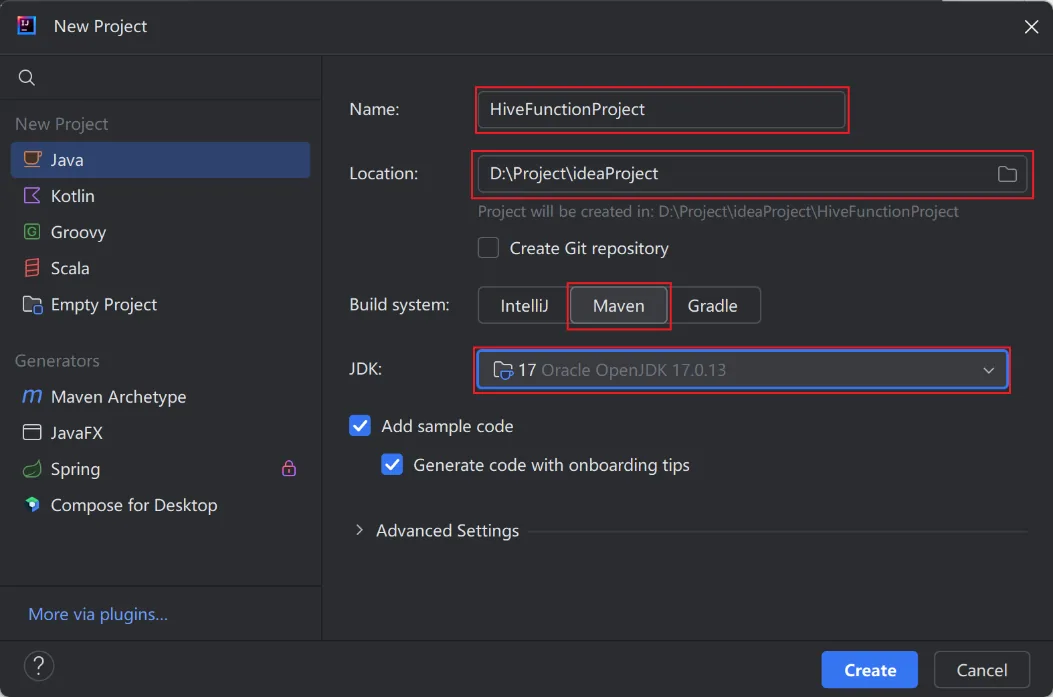
打开“New Project”对话框,在该对话框中配置项目的基本信息,具体内容如下。
在“Build system”区域选择“Maven”选项。
在“Name”输入框中指定项目名称为HiveFunctionProject。
在“Location”输入框中指定项目的存储路径为D:\Project\ideaProject。
在“JDK”下拉框中选择本地安装的JDK 17。
▸ 课件步骤 02
“New Project”对话框配置完成的效果如图。
单击“create”按钮
▸ 课件步骤 03
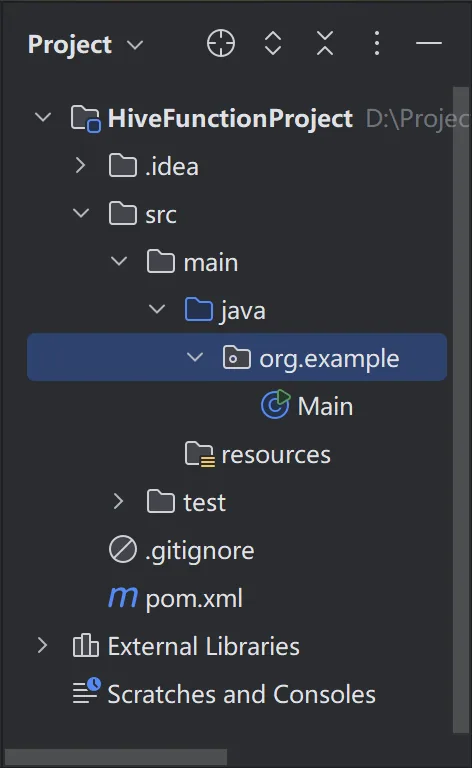
创建项目HiveFunctionProject。项目HiveFunctionProject创建完成的效果如图。
▸ 课件步骤 04
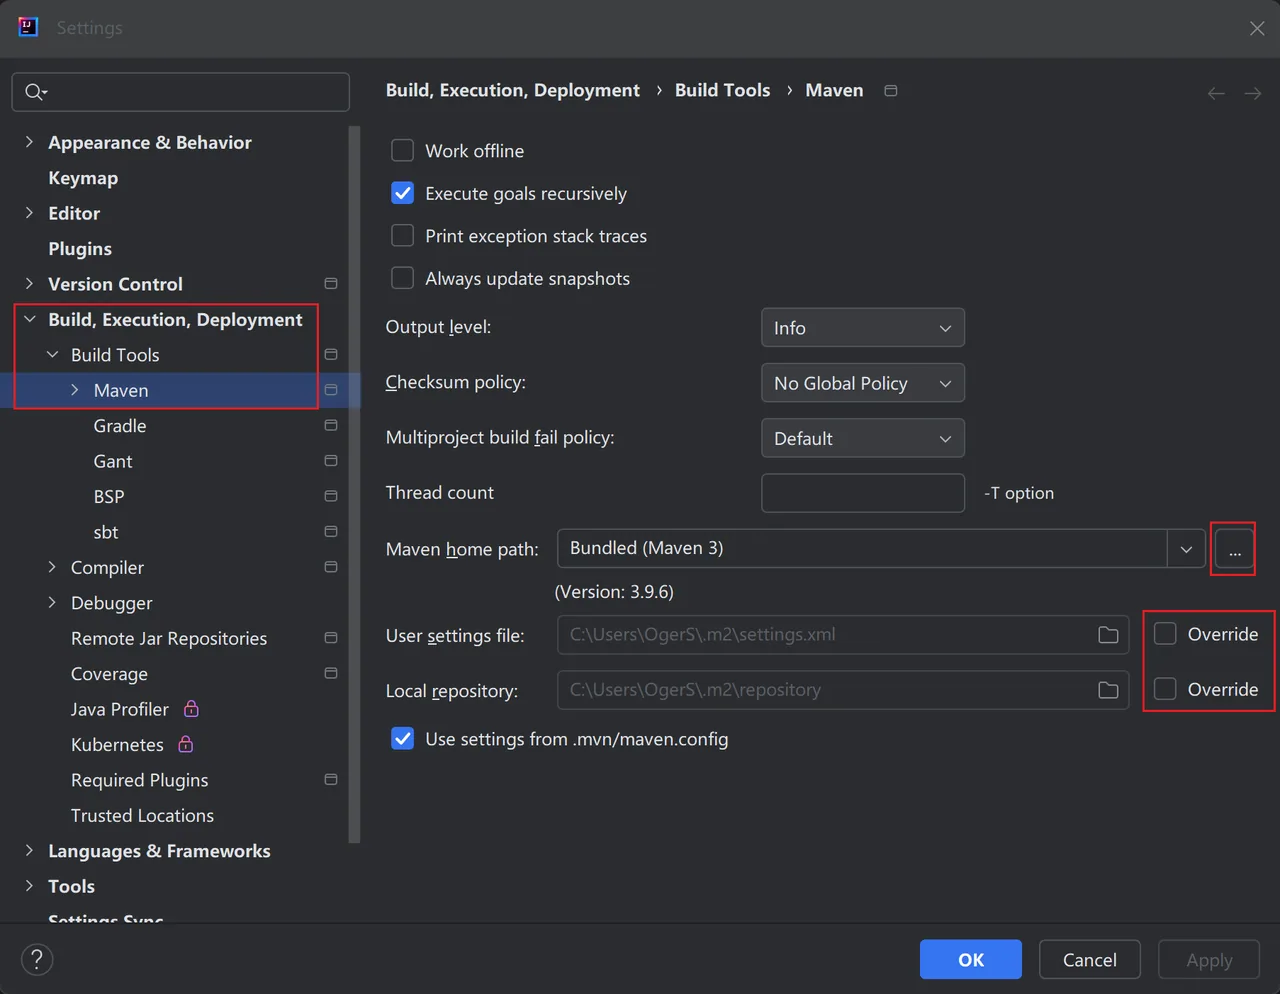
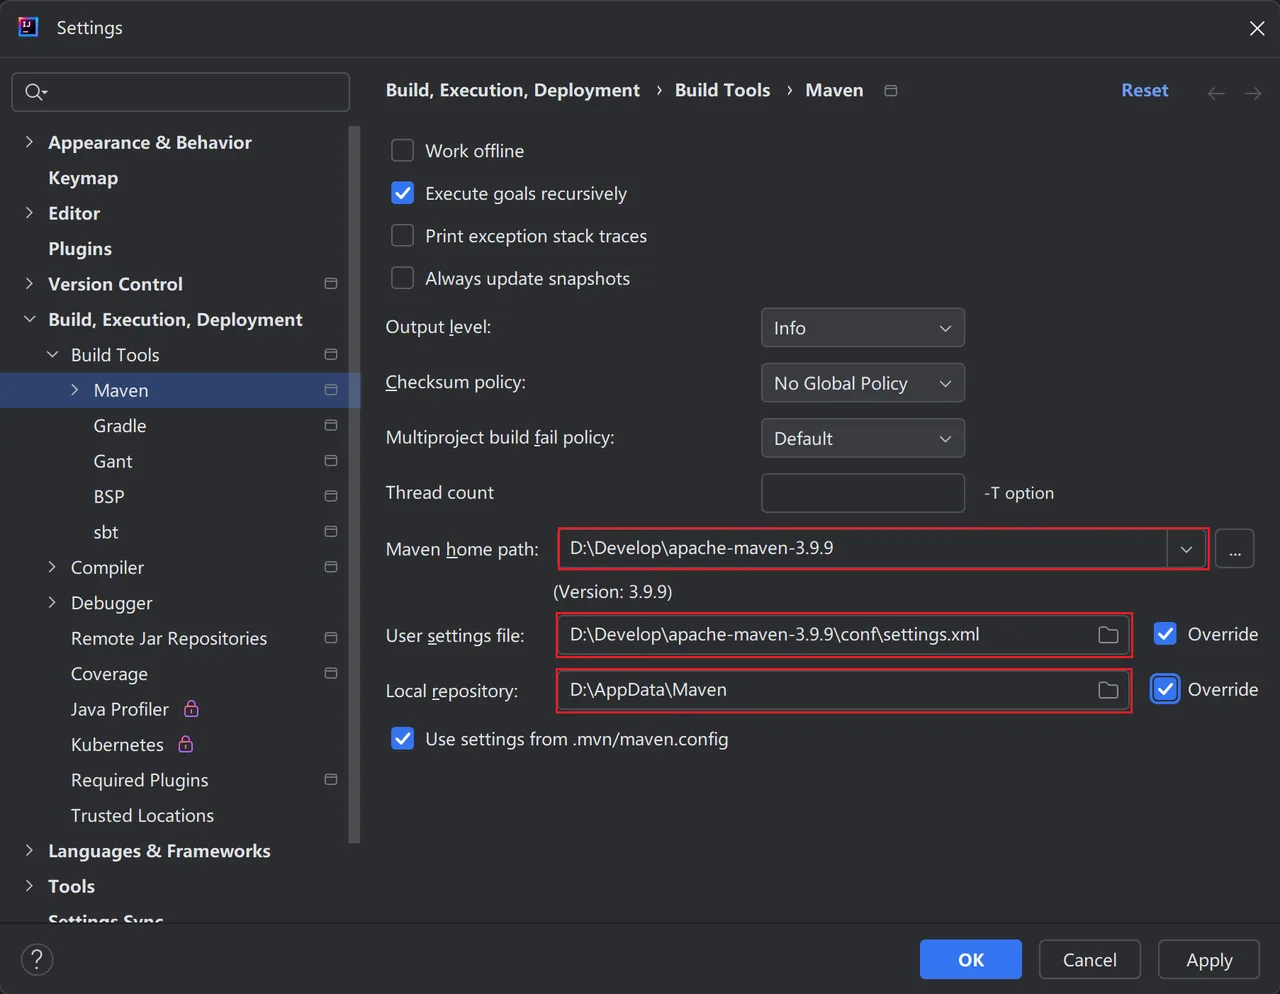
在IntelliJ IDEA的工具栏中依次单击“File”→“Settings”选项打开“Settings”对话框,在该对话框的左侧依次单击“Build,Execution,Deployment”→“Build Tools”→“Maven”选项配置项目HiveFunctionProject使用的Maven,如图。
▸ 课件步骤 05
首先,单击“Maven home path”下拉框后方的按钮,在弹出的“Select Maven Home Directory”对话框选择Maven的安装目录。
然后,在“User settings file”输入框的后方勾选“Override”复选框,并在该输入框内指定Maven配置文件settings.xml。
最后,在“Local repository”输入框后方勾选“Override”复选框,并在该输入框内指定Maven本地仓库的路径,该路径与Maven配置文件settings.xml中指定本地仓库的路径一致。
▸ 课件步骤 05
“Settings”对话框配置完成的效果如图。
▸ 课件步骤 06
在项目HiveFunctionProject中双击pom.xml文件,在该文件的<project>标签中添加Hive依赖,具体内容如下。
<dependencies>
<dependency>
<groupId>org.apache.hive</groupId>
<artifactId>hive-exec</artifactId>
<version>4.1.0</version>
</dependency>
</dependencies>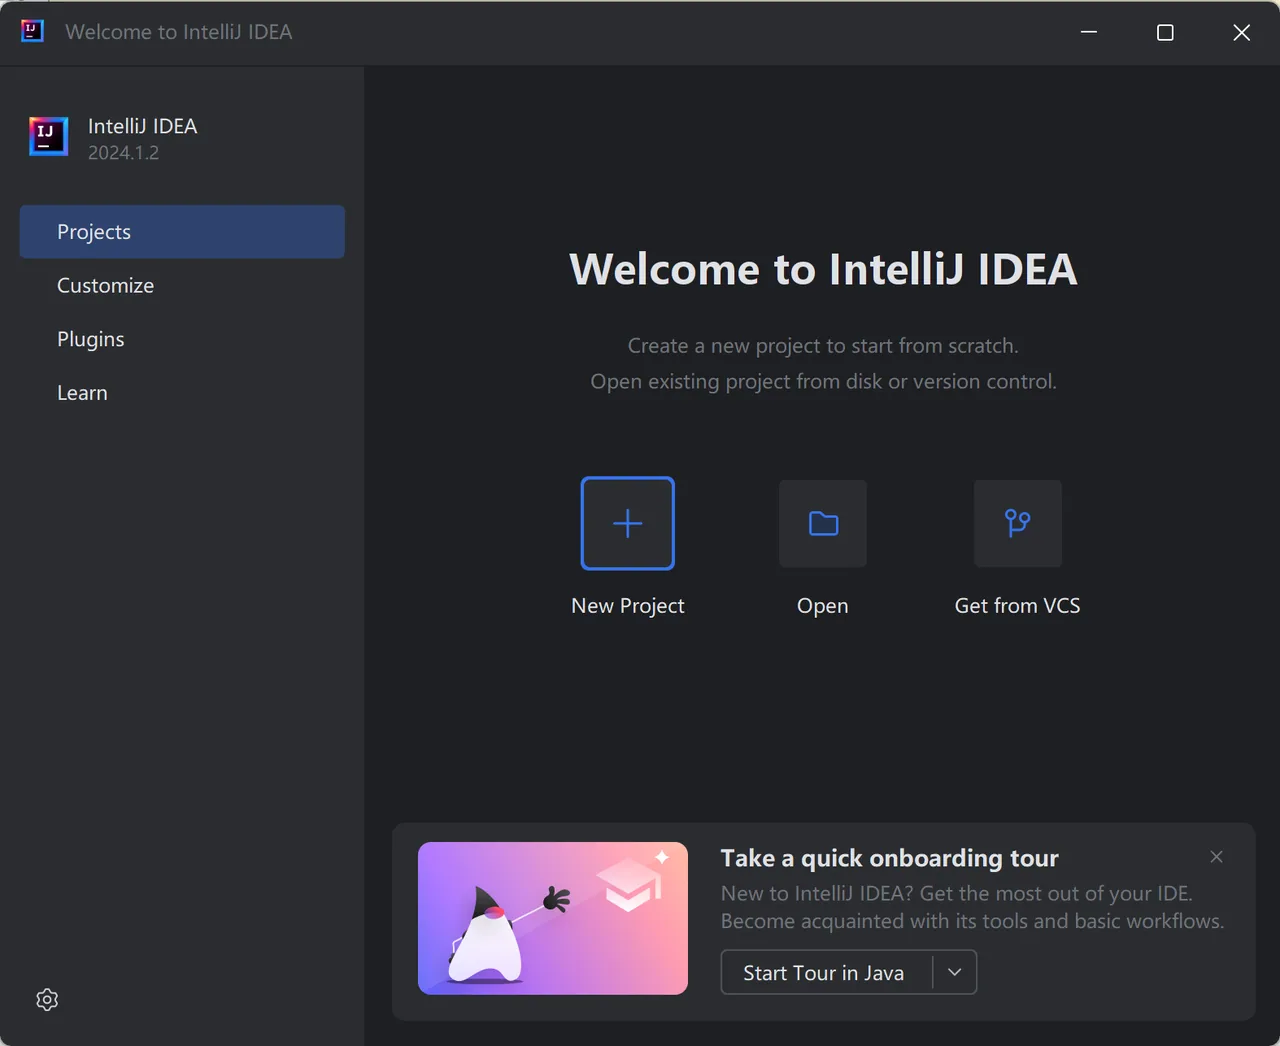
📷 展开本知识点其余 1 张课件截图
📄 展开课件原文(第 121–131 页,共 11 页)
开发UDF
了解自定义函数的开发流程,能够通过Java应用程序开发UDF。
UDF是最基础的自定义函数类型,用于解决简单的数据转换与计算需求。当内置函数无法满足某些特定的单行处理逻辑时,用户可以编写UDF以实现“一行输入、一行输出”的自定义处理。通过UDF,用户能够对输入的每条记录应用自定义的转换或计算逻辑,然后返回一个结果,从而满足个性化的数据处理需求。
在使用Java实现UDF时,需要创建一个类并继承Hive提供的GenericUDF基类,同时重写initialize()、evaluate()和getDisplayString()方法,关于这三个方法的介绍如下。
initialize()
A
evaluate()
B
getDisplayString()
C
initialize()方法用于校验UDF输入参数的合法性,并声明UDF输出值的数据类型,具体签名如下。
1. initialize()方法
public ObjectInspector initialize(ObjectInspector[] objectInspectors)是一个ObjectInspector数组
Hive中各数据类型与ObjectInspector实例的对应关系如表。
| 数据类型 | ObjectInspector实例 |
|---|---|
| TINYINT | PrimitiveObjectInspectorFactory.writableByteObjectInspector |
| SMALLINT | PrimitiveObjectInspectorFactory.writableShortObjectInspector |
| INT/INTEGER | PrimitiveObjectInspectorFactory.writableIntObjectInspector |
| BIGINT | PrimitiveObjectInspectorFactory.writableLongObjectInspector |
| FLOAT | PrimitiveObjectInspectorFactory.writableFloatObjectInspector |
| 数据类型 | ObjectInspector实例 |
|---|---|
| DOUBLE | PrimitiveObjectInspectorFactory.writableDoubleObjectInspector |
| DECIMAL | PrimitiveObjectInspectorFactory.getPrimitiveWritableObjectInspector(new DecimalTypeInfo(int precision,int scale)) |
| STRING | PrimitiveObjectInspectorFactory.writableStringObjectInspector |
| VARCHAR | PrimitiveObjectInspectorFactory.getPrimitiveWritableObjectInspector(new VarcharTypeInfo(int length)) |
| CHAR | PrimitiveObjectInspectorFactory.getPrimitiveWritableObjectInspector(new CharTypeInfo(int length)) |
| 数据类型 | ObjectInspector实例 |
|---|---|
| TIMESTAMP | PrimitiveObjectInspectorFactory.writableTimestampObjectInspector |
| DATE | PrimitiveObjectInspectorFactory.writableDateObjectInspector |
| INTERVAL | PrimitiveObjectInspectorFactory.writableHiveIntervalDayTimeObjectInspector 或者 PrimitiveObjectInspectorFactory.writableHiveIntervalYearMonthObjectInspector |
| BOOLEAN | PrimitiveObjectInspectorFactory.writableBooleanObjectInspector |
| BINARY | PrimitiveObjectInspectorFactory.writableBinaryObjectInspector |
| 数据类型 | ObjectInspector实例 |
|---|---|
| ARRAY | ObjectInspectorFactory.getStandardListObjectInspector(ObjectInspector listElementObjectInspector) |
| MAP | ObjectInspectorFactory.getStandardMapObjectInspector(ObjectInspector keyObjectInspector,ObjectInspector valueObjectInspector) |
| STRUCT | ObjectInspectorFactory.getStandardStructObjectInspector(List<String> structFieldNames,List<ObjectInspector> structFieldObjectInspectors) |
evaluate()方法用于对输入数据执行具体的处理逻辑,具体签名如下。
2.evaluate()方法
public Object evaluate(DeferredObject[] deferredObjects)是一个DeferredObject数组
getDisplayString()方法用于返回UDF调用的可读展示形式,主要用于执行计划、日志与错误信息的输出,在实际的数据查询过程中并不会被执行。
getDisplayString()方法的签名如下。
3.getDisplayString()方法
public String getDisplayString(String[] strings)是一个字符串数组,其中每个元素对应一个输入参数的名称
接下来,演示如何实现一个UDF用于处理字符串类型的手机号,其处理逻辑如下。
对手机号进行标准化,将其统一为11位数字格式。
校验手机号的有效性。
若手机号有效,则进行脱敏处理,仅保留前三位和后四位,其余部分以*替代。
若手机号无效,则直接返回无效手机号。
根据上述处理逻辑实现UDF。在项目HiveFunctionProject的src/main/java目录中创建包cn.itcast.udf,并在其中新建类PhoneStandardizerMasker,具体代码如文件。
点击查看
📄 展开课件原文(第 132–143 页,共 12 页)
开发UDAF
了解自定义函数的开发流程,能够通过Java应用程序开发UDAF。
在某些高度定制的统计分析场景中,Hive内置的聚合函数可能无法满足需求。此时可以通过编写UDAF以实现“多行输入,一行输出”的自定义处理。通过UDAF,用户能够自行定义复杂的聚合计算逻辑,提高数据汇总分析的灵活性和针对性。
在使用Java实现UDAF时,通常需要创建两个类,其中一个类实现Hive提供的GenericUDAFResolver2接口,另外一个类继承Hive提供的GenericUDAFEvaluator基类,具体介绍如下。
2.GenericUDAFEvaluator基类
GenericUDAFResolver2接口
GenericUDAFResolver2接口的核心作用是校验UDAF输入参数的合法性,并获取与查询语句相关的信息,为后续的聚合计算提供必要的元数据支持。实现GenericUDAFResolver2接口的类需要重写两个重载的getEvaluator()方法,其签名如下。
1. GenericUDAFResolver2接口
public GenericUDAFEvaluator getEvaluator(
GenericUDAFParameterInfo genericUDAFParameterInfo)
public GenericUDAFEvaluator getEvaluator(TypeInfo[] typeInfos)
是一个GenericUDAFParameterInfo对象,封装了查询语句完整的信息
是一个TypeInfo数组
GenericUDAFEvaluator基类用于定义UDAF的聚合计算逻辑。继承GenericUDAFEvaluator基类的子类需要重写七个方法,分别是init()、getNewAggregationBuffer()、reset()、iterate()、terminatePartial()、merge()和terminate(),具体介绍如下。
(1) init()方法
init()方法的核心作用是根据Hive分阶段聚合的不同执行模型,完成相应的数据通道初始化。其主要工作包括定义输入与输出值的数据类型描述器,以及创建用于存储中间结果的容器。通过这种方式,init()方法能够动态适配各个聚合阶段的需求,为其他方法提供统一的数据交互标准,从而实现分阶段聚合的无缝衔接。
在Hive的分布式环境中,聚合计算通常会被拆分为多个阶段,以提升并行度和计算效率。init()方法会根据不同的聚合阶段进行初始化,其常见取值如下。
PARTIAL1:
PARTIAL2:
用于从原始输入数据生成部分聚合结果。init()方法初始化输入为原始字段类型,输出为部分聚合结果的数据结构。
合并来自不同并行任务的部分聚合结果。init()方法初始化输入与输出均为部分聚合结果的数据结构。
FINAL:
COMPLETE:
用于接收PARTIAL2的输出并计算最终聚合结果。init()方法初始化输入为部分聚合结果,输出为最终聚合结果的数据类型。
用于从原始输入直接生成最终聚合结果。init()方法初始化输入为原始字段类型,输出为最终聚合结果的数据类型。
init()方法的签名如下。
public ObjectInspector init(Mode m, ObjectInspector[] parameters)是一个Mode枚举,用于指示当前初始化所处的聚合阶段
是一个ObjectInspector数组
getNewAggregationBuffer()方法用于创建聚合过程中存储中间结果的容器,即AggregationBuffer实例。该实例在整个聚合逻辑中承担关键作用,用于保存计算过程中的中间状态,是实现自定义聚合逻辑的核心数据结构。getNewAggregationBuffer()方法的签名如下。
public AggregationBuffer getNewAggregationBuffer()(2) getNewAggregationBuffer()方法
该方法的返回值为非null的AggregationBuffer实例。
reset()方法是实现分组聚合逻辑的关键环节,其核心作用是状态重置,确保不同分组的中间计算结果相互隔离,避免前一分组的计算残留会直接影响后一分组结果。reset()方法的签名如下。
public void reset(AggregationBuffer aggregationBuffer)(3) reset()方法
是一个AggregationBuffer实例,保存了计算过程中的中间状态
iterate()方法用于接收并处理一行输入数据,根据聚合逻辑对其进行计算,并将计算结果更新至中间状态。iterate()方法的签名如下。
public void iterate(AggregationBuffer aggregationBuffer, Object[] objects)(4) iterate()方法
是一个Object数组,其中每个元素对应一个输入参数的值
terminatePartial()方法的核心作用是生成部分聚合结果,该方法的签名如下。
public Object terminatePartial(AggregationBuffer aggregationBuffer)(5) terminatePartial()方法
该方法返回值为一个Object对象,用于封装输出的部分聚合结果。
merge()方法作为分布式聚合的核心合并器,负责合并多个任务产生的中间结果,确保分布式环境下聚合计算的正确性与完整性。merge()方法的签名如下。public void merge(AggregationBuffer aggregationBuffer, Object o)(6) merge()方法
是一个Object对象,封装了待合并的部分聚合结果
terminate()方法是UDAF中负责输出最终聚合计算结果的核心方法,该方法的签名如下。
public Object terminate(AggregationBuffer aggregationBuffer)(7) terminate()方法
该方法返回值为一个Object对象,用于封装输出的最终聚合结果。
接下来,演示如何实现一个UDAF用于处理数值类型的数据,聚合逻辑为同时计算累加值和平均值,并将两项指标封装在同一返回值中,具体实现过程如下。
▸ 课件步骤 01
在项目HiveFunctionProject的src/main/java目录中创建包cn.itcast.udaf,并在其中新建一个实现GenericUDAFResolver2接口的类SumAvgFormat,具体代码如文件。
点击查看
▸ 课件步骤 02
在项目HiveFunctionProject的包cn.itcast.udaf中新建一个继承GenericUDAFEvaluator基类的类SumAvgEvaluator,具体代码如文件。
📄 展开课件原文(第 144–160 页,共 17 页)
开发UDTF
了解自定义函数的开发流程,能够通过Java应用程序开发UDTF。
当Hive内置表生成函数无法满足需求时,可以通过编写UDTF实现更复杂的“一行输入,多行输出”逻辑。UDTF允许用户自定义拆解规则,将一行数据分解为多条记录逐行输出,从而实现高度定制化的展开操作,满足明细化处理的特殊需求。
在使用Java实现UDTF时,需要创建一个类并继承Hive提供的GenericUDTF基类,同时重写initialize()、process()和close()方法,关于这三个方法的介绍如下。
initialize()
A
process()
B
close()
C
initialize()方法用于校验UDTF输入参数的合法性,并声明UDTF输出结果的结构,包括字段名、数据类型等,该方法的签名如下。
1. initialize()方法
public StructObjectInspector initialize(ObjectInspector[] argOIs)是一个ObjectInspector数组
process()方法用于对输入数据执行具体的处理逻辑,具体签名如下。
2. process()方法
public void process(Object[] objects)是一个Object数组
close()方法在所有输入数据处理完成后执行,用于释放资源,例如在process()方法中打开的IO流、网络连接等。close()方法的签名如下。
3. close()方法
public void close()需要说明的是,如果在处理过程中没有涉及资源占用,则该方法可以留空。
接下来,演示如何实现一个UDTF用于处理字符串类型的数据,处理逻辑为按照指定分隔符对输入字符串进行拆分,并将拆分结果逐行输出为多行记录。在项目HiveFunctionProject的src/main/java目录中创建包cn.itcast.udtf,并在其中新建类SplitToRows。
点击查看
📄 展开课件原文(第 161–167 页,共 7 页)
注册自定义函数
了解自定义函数的开发流程,能够完成函数注册与调用。
通过前面内容讲解,我们学习了如何在IntelliJ IDEA中通过编写Java应用程序实现不同类型的自定义函数。不过,若要将Java应用程序中的处理逻辑作为Hive的函数使用,还需要将其注册为Hive可调用的函数。
在Hive中注册自定义函数时,需要先将相应的Java应用程序封装为JAR文件,并在Hive中将函数名与自定义函数的实现类进行绑定。Hive支持将自定义函数注册为临时函数或永久函数,具体说明如下。
永久
函数
临时
临时函数是在Hive会话中动态注册的函数,仅对当前会话有效,会话结束后自动失效,无须手动删除。在Hive中注册临时函数时,需要先通过ADD JAR语句将存储自定义函数的JAR文件加载到当前会话中,然后使用CREATE TEMPORARY FUNCTION语句将函数名与自定义函数的实现类进行绑定,关于这两个语句的语法格式如下。
1. 临时函数
ADD JAR path;
CREATE TEMPORARY FUNCTION function_name AS class_name;
用于指定JAR文件的路径
用于指定自定义函数在Hive中的名称
用于指定自定义函数的全限定类名
永久函数是注册后持久化到Hive元数据中的函数,对所有Hive会话可见,除非手动删除,否则会一直存在。注册永久函数的语法格式如下。
2. 永久函数
CREATE FUNCTION [db_name.]function_name AS class_name[USING JAR path [,JAR path]];用于注册永久函数
用于将自定义函数注册到指定数据库中
用于指定包含自定义函数的JAR文件路径
用于指定具体路径
需要注意的是,path和class_name参数是字符串字面量,需要使用单引号包裹。
接下来,将演示如何将实现的UDF、UDAF和UDTF注册为Hive的函数,具体操作步骤如下。
▸ 课件步骤 01
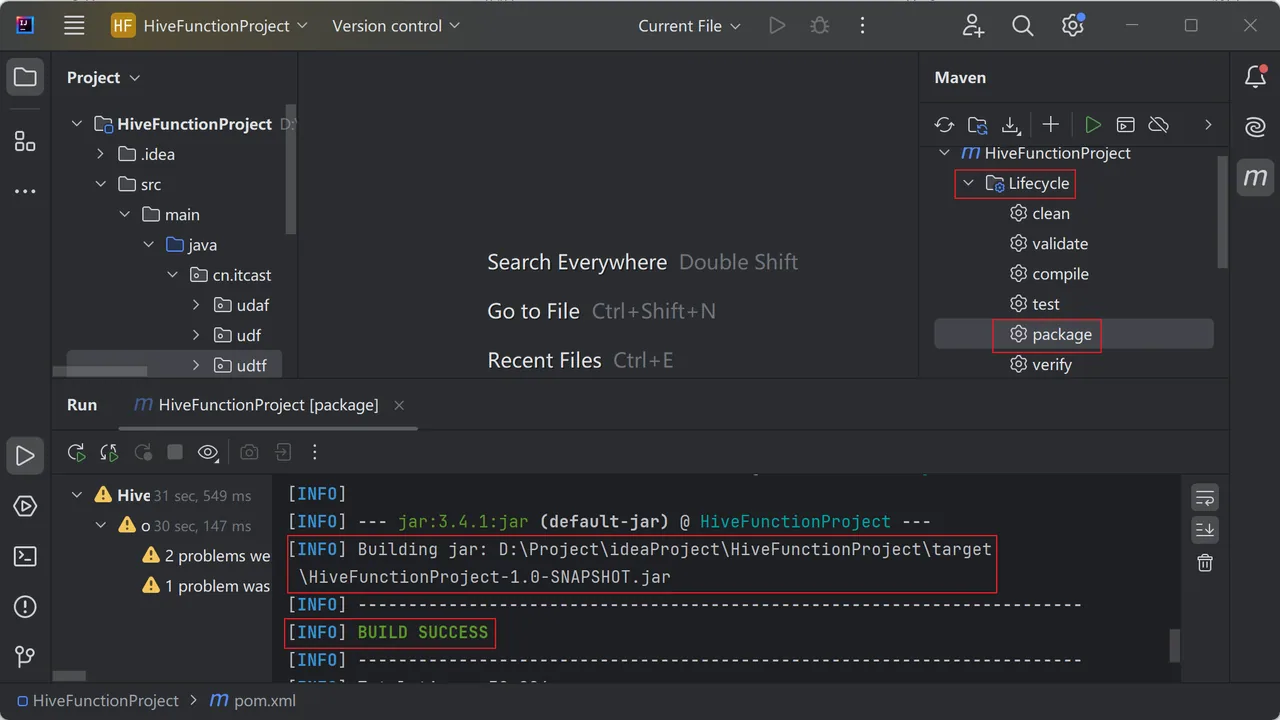
在项目HiveFunctionProject的右侧单击Maven选项卡展开Maven工具窗口。在该窗口种双击Lifecycle折叠框中的package选项,将项目HiveFunctionProject封装为JAR文件。当控制台输出BUILD SUCCESS信息时,说明封装成功,如图。
▸ 课件步骤 02
将JAR文件HiveFunction.jar上传到虚拟机Node02的/export/data/chapter6目录(需提前创建)中。
▸ 课件步骤 03
在HDFS中创建/hive/data/chapter6目录,用于存储JAR文件HiveFunction.jar,在虚拟机Node02执行如下命令。
hdfs dfs -mkdir -p /hive/data/chapter6▸ 课件步骤 04
将JAR文件HiveFunction.jar上传至HDFS的/hive/data/chapter6目录中,在虚拟机Node02执行如下命令。
▸ 课件步骤 05
将UDF以永久函数的方式注册到数据库chapter6中,具体HiveQL语句如下。
CREATE FUNCTION chapter6.standardize_mask_phoneAS 'cn.itcast.udf.PhoneStandardizerMasker'
USING JAR 'hdfs:///hive/data/chapter6/HiveFunction.jar';hdfs dfs -put /export/data/chapter6/HiveFunction.jar /hive/data/chapter6▸ 课件步骤 05
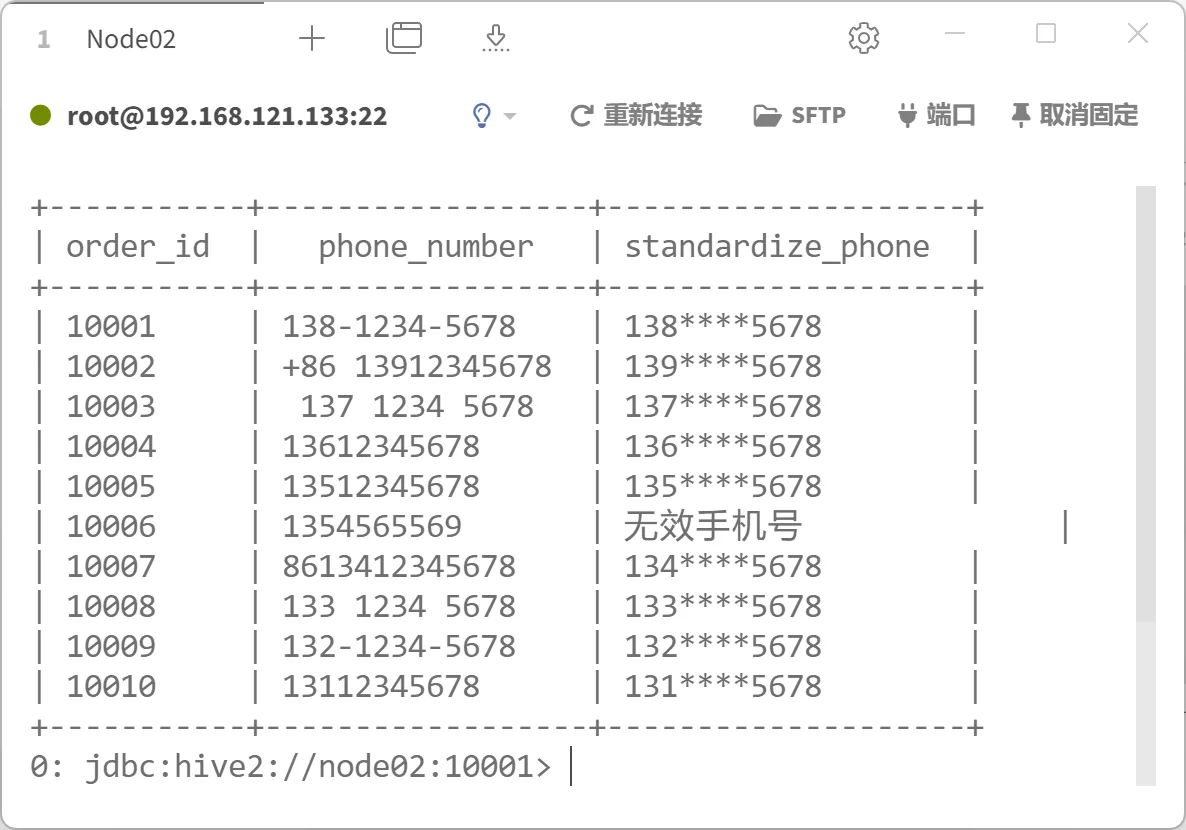
使用函数standardize_mask_phone()对数据库chapter6中表demo_ecommerce_orders的字段phone_number进行处理,验证UDF是否注册成功,具体HiveQL语句如下。
SELECT order_id,phone_number,
chapter6.standardize_mask_phone(phone_number) AS standardize_phone
FROM chapter6.demo_ecommerce_orders;▸ 课件步骤 05
上述语句执行完成后的效果如图。
▸ 课件步骤 06
将UDAF以临时函数的方式注册到当前会话中,具体HiveQL语句如下。
ADD JAR /export/data/chapter6/HiveFunction.jar;
CREATE TEMPORARY FUNCTION sum_avg_format AS 'cn.itcast.udaf.SumAvgFormat';
上述语句指定UDAF在Hive中的名称为sum_avg_format。需要注意的是,注册UDAF时,指定的实现类是实现接口GenericUDAFResolver2的类。
▸ 课件步骤 06
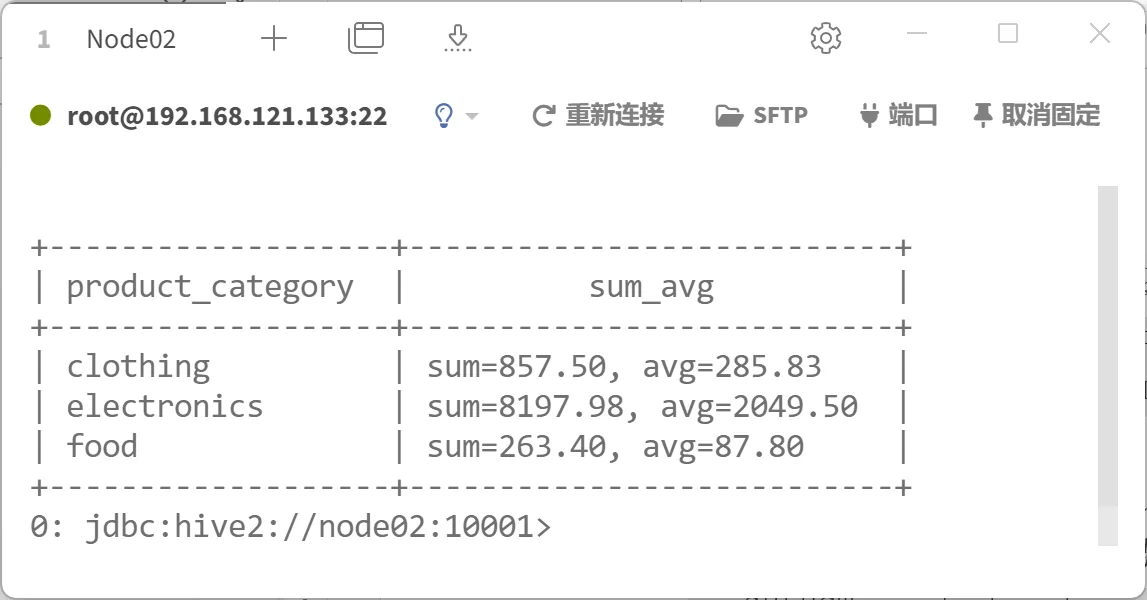
使用函数sum_avg_format()对数据库chapter6中表demo_ecommerce_orders的字段order_amount进行处理,验证UDAF是否注册成功,具体HiveQL语句如下。
SELECT product_category,sum_avg_format(order_amount) AS sum_avgFROM chapter6.demo_ecommerce_orders
GROUP BY product_category;▸ 课件步骤 06
上述语句,用于统计各商品类别的总订单金额与平均订单金额。上述语句执行完成后的效果如图。
▸ 课件步骤 07
将UDTF以永久函数的方式注册到数据库chapter6中,具体HiveQL语句如下。
CREATE FUNCTION chapter6.split_to_rowsAS 'cn.itcast.udtf.SplitToRows'
上述语句指定UDTF在Hive中的名称为split_to_rows。
▸ 课件步骤 07
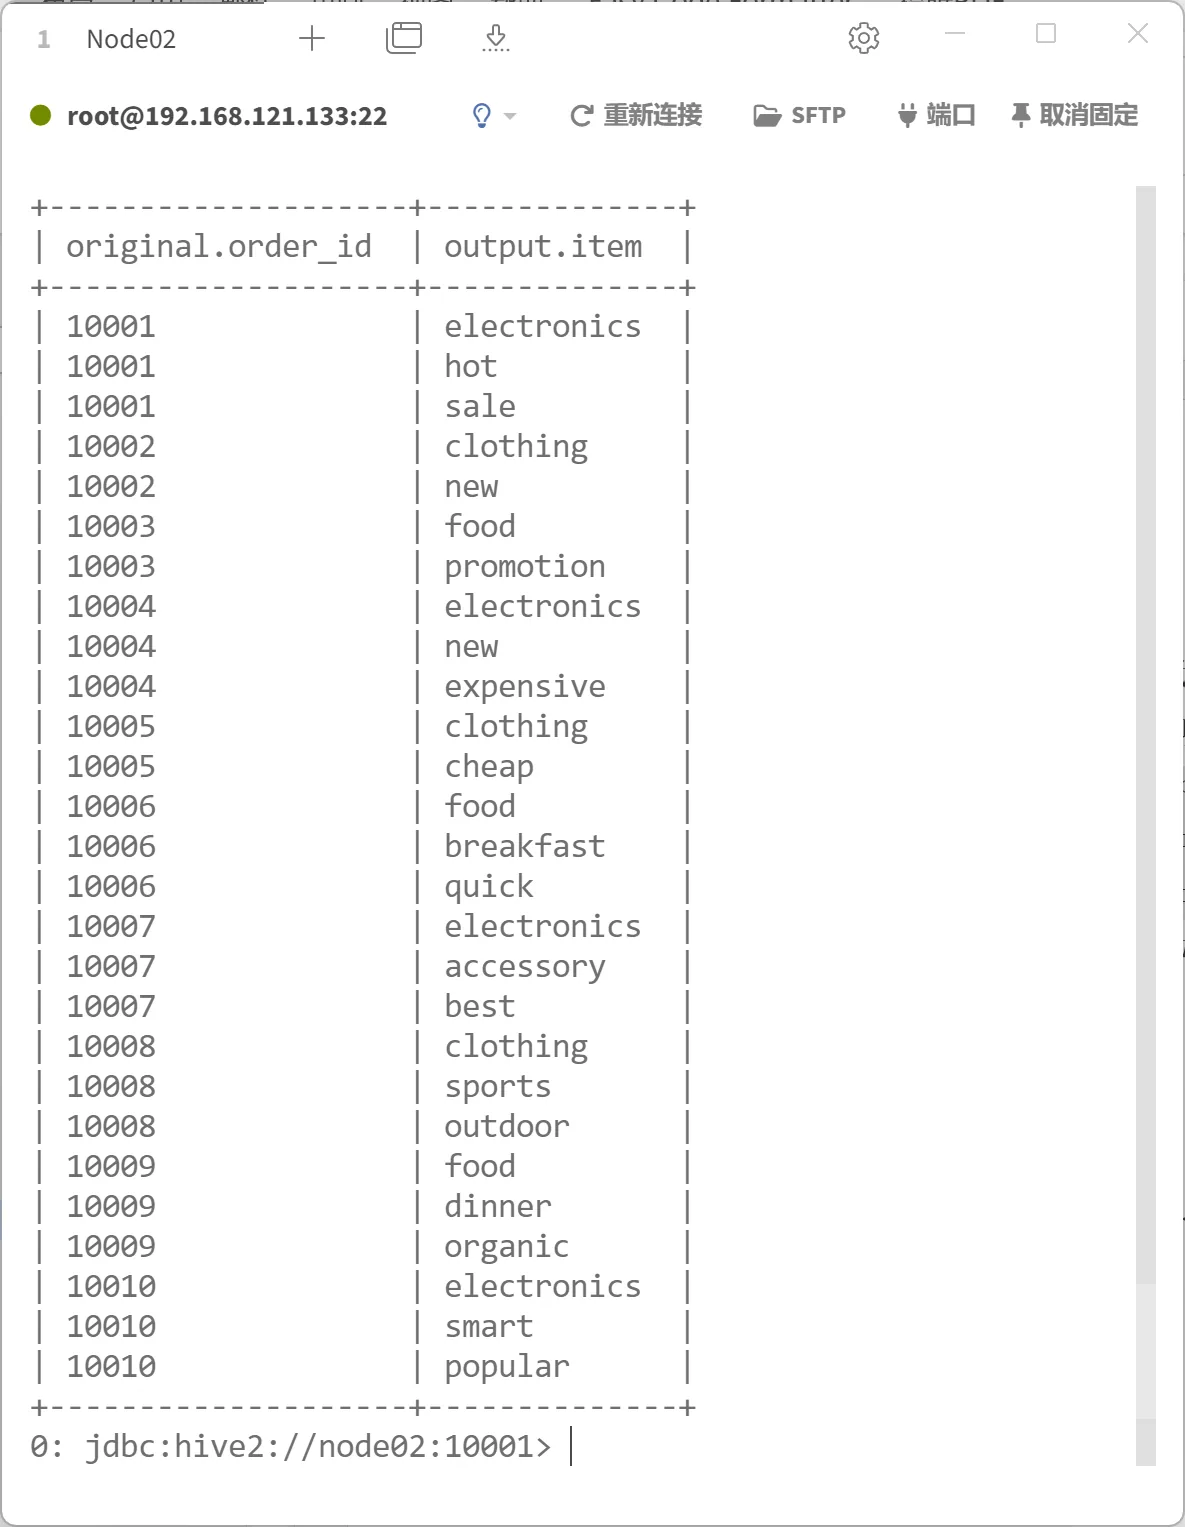
使用函数split_to_rows ()对数据库chapter6中表demo_ecommerce_orders的字段tags进行处理,验证UDTF是否注册成功,具体HiveQL语句如下。
SELECT original.order_id,output.itemFROM chapter6.demo_ecommerce_orders original
LATERAL VIEW chapter6.split_to_rows(tags) output;▸ 课件步骤 07
删除自定义函数与查看函数
在Hive中,当注册的自定义函数不再需要使用时,应对其进行删除。临时函数会在当前会话结束时自动删除;而永久函数会一直保存在元数据中,需要用户手动删除。Hive提供了DROP TEMPORARY FUNCTION和DROP FUNCTION语句,分别用于在不关闭当前会话的情况下删除临时函数,以及删除永久函数,具体语法格式如下。
DROP TEMPORARY FUNCTION [IF EXISTS] function_name;
DROP FUNCTION [IF EXISTS] [db_name.]function_name;
删除临时函数
删除永久函数
此外,Hive提供了SHOW FUNCTIONS语句,用于查看Hive中的所有函数,包括内置函数、永久函数和当前会话中注册的临时函数,具体语法格式如下。
SHOW FUNCTIONS [LIKE pattern];用于按照SQL通配符模式匹配函数名称
用于指定匹配模式,用单引号包裹
AI助学
学完本单元后,读者已经初步掌握了Hive中函数的基本使用方法。然而,在实际处理数据时,仍可能难以判断应使用哪类函数、多个函数如何组合,以及在内置函数无法满足需求时如何开发自定义函数。此时,可借助AI分析数据处理需求,梳理函数选用思路,并检查函数表达式或自定义函数设计中可能存在的问题。
AI
助
学
单元总结
本单元主要讲解了Hive函数。首先,介绍了内置函数,包括聚合函数、数学函数、集合函数、条件函数等。然后,介绍了窗口函数。最后,讲解了自定义函数的实现,包括UDF、UDAF和UDTF的创建,以及自定义函数的注册。通过本单元的学习,读者能够熟练运用Hive提供的各类内置函数进行数据处理,并能够根据业务需求编写和注册自定义函数,以扩展Hive的数据处理能力。
单
元
总
结
📄 展开课件原文(第 168–188 页,共 21 页)
🧪 动手做一遍 把函数用到真实数据上
预计用时约 35 分钟 · 每一步都给出可执行语句与预期结果,建议边看边在 Beeline / DataGrip 里敲一遍
本实例步骤
- 01 先看有哪些函数可用
- 02 聚合函数:把明细变成指标
- 03 字符串函数:拼接与截取
- 04 日期函数:从生日算年龄
- 05 条件函数:成绩分档
- 06 集合函数与表生成函数:把一行拆成多行
- 07 窗口函数:排名、占比、累计
- 08 写一个自己的 UDF(完整流程)
01先看有哪些函数可用
不记得函数名时,用 DESC FUNCTION 就地查文档。
SHOW FUNCTIONS;                       -- 列出全部内置函数
DESC FUNCTION upper;                  -- 看用法
DESC FUNCTION EXTENDED upper; -- 看详细说明与示例| tab_name |
|---|
| abs |
| array_contains |
| avg |
| ceil |
| collect_list |
| concat |
| …(共数百个内置函数) |
💡 SHOW FUNCTIONS 'a.*' 可以按正则过滤函数名,比翻文档快。
02聚合函数:把明细变成指标
count / sum / avg / max / min / 去重计数,数仓指标的基础。
SELECT count(*)                        AS 成绩记录数,
       count(DISTINCT stu_id)           AS 参加考试人数,
       sum(score)                       AS 总分,
       round(avg(score), 2)             AS 平均分,
       max(score)                       AS 最高分,
       min(score)                       AS 最低分
FROM score_info;验证语句:SELECT count(*) AS c1, count(DISTINCT stu_id) AS c2, sum(score) AS c3, round(avg(score),2) AS c4, max(score) AS c5, min(score) AS c6 FROM score_info
| c1 | c2 | c3 | c4 | c5 | c6 |
|---|---|---|---|---|---|
| 74 | 19 | 4862 | 65.7 | 100 | 32 |
count(*) 数行,count(列) 不数 NULL,count(DISTINCT 列) 去重后计数——三个别混用。03字符串函数:拼接与截取
把姓名、课程拼成一句可读的标签。
SELECT concat(stu_name, '(', sex, ')')      AS 标签,
       substr(stu_name, 1, 1)               AS 姓氏,
       upper('hive')                        AS 转大写,
       length(stu_name)                     AS 姓名长度
FROM student_info LIMIT 5;验证语句:SELECT (stu_name || '(' || sex || ')') AS label, substr(stu_name,1,1) AS surname, upper('hive') AS up, length(stu_name) AS len FROM student_info LIMIT 5
| label | surname | up | len |
|---|---|---|---|
| 彭于晏(男) | 彭 | HIVE | 3 |
| 胡歌(男) | 胡 | HIVE | 2 |
| 周杰伦(男) | 周 | HIVE | 3 |
| 刘德华(男) | 刘 | HIVE | 3 |
| 唐国强(男) | 唐 | HIVE | 3 |
|| 代替 Hive 的 concat(),语义一致。substr 下标从 1 开始。04日期函数:从生日算年龄
Hive 的日期函数和 MySQL 不同,要单独记。
SELECT stu_name, birthday,
       year(current_date()) - year(birthday)   AS 周岁近似,
       datediff(current_date(), birthday)      AS 出生天数,
       date_add(birthday, 30)                  AS 生日后30天,
       date_format(birthday, 'yyyy年MM月')      AS 格式化
FROM student_info LIMIT 5;| stu_name | birthday | 周岁近似 | 出生天数 |
|---|---|---|---|
| 彭于晏 | 1995-05-16 | 30 | 约 11000 |
| 胡歌 | 1994-03-20 | 31 | 约 11500 |
| 周杰伦 | 1995-04-30 | 30 | 约 11100 |
date_format 的格式串用 Java 风格(yyyy-MM-dd)。05条件函数:成绩分档
用 CASE WHEN / IF 做业务分档,报表里天天用。
SELECT stu_id, course_id, score,
       CASE WHEN score >= 90 THEN '优秀'
            WHEN score >= 80 THEN '良好'
            WHEN score >= 60 THEN '及格'
            ELSE '不及格' END              AS 等级,
       IF(score >= 60, '通过', '未通过')    AS 结果
FROM score_info
WHERE course_id = '01'
ORDER BY score DESC
LIMIT 8;验证语句:SELECT stu_id, course_id, score, CASE WHEN score >= 90 THEN '优秀' WHEN score >= 80 THEN '良好' WHEN score >= 60 THEN '及格' ELSE '不及格' END AS level FROM score_info WHERE course_id = '01' ORDER BY score DESC LIMIT 8
| stu_id | course_id | score | level |
|---|---|---|---|
| 001 | 01 | 94 | 优秀 |
| 015 | 01 | 90 | 优秀 |
| 020 | 01 | 89 | 良好 |
| 004 | 01 | 85 | 良好 |
| 010 | 01 | 84 | 良好 |
| 014 | 01 | 81 | 良好 |
| 009 | 01 | 75 | 及格 |
| 002 | 01 | 74 | 及格 |
💡 CASE WHEN 从上往下匹配,条件顺序会影响结果;百分比分档时把大区间写前面。
06集合函数与表生成函数:把一行拆成多行
处理“一个用户多个标签”这类多值字段。
-- 每个学生所有成绩打包成一个数组
SELECT stu_id, collect_list(score) AS 成绩列表, size(collect_list(score)) AS 门数
FROM score_info GROUP BY stu_id LIMIT 3;

-- explode 把数组拆成多行,配合 lateral view 使用
SELECT stu_id, s
FROM (SELECT stu_id, collect_list(score) AS scores FROM score_info GROUP BY stu_id) t
LATERAL VIEW explode(scores) tmp AS s
LIMIT 6;| stu_id | s |
|---|---|
| 001 | 94 |
| 001 | 63 |
| 001 | 79 |
| 002 | 74 |
| 002 | 84 |
| 002 | 87 |
explode 是 UDTF(一行进、多行进),不能和其它列直接并列写在 SELECT 里,要搭配 LATERAL VIEW。07窗口函数:排名、占比、累计
不改行数的前提下做组内计算,是数仓面试与实战的高频点。
SELECT course_id, stu_id, score,
       row_number() OVER (PARTITION BY course_id ORDER BY score DESC) AS 行号,
       rank()       OVER (PARTITION BY course_id ORDER BY score DESC) AS 并列跳号,
       dense_rank() OVER (PARTITION BY course_id ORDER BY score DESC) AS 并列不跳号,
       round(score / sum(score) OVER (PARTITION BY course_id) * 100, 2) AS 占本课总分比
FROM score_info
WHERE course_id = '01'
ORDER BY score DESC
LIMIT 6;验证语句:SELECT course_id, stu_id, score, row_number() OVER (PARTITION BY course_id ORDER BY score DESC) AS rn, rank() OVER (PARTITION BY course_id ORDER BY score DESC) AS rk, dense_rank() OVER (PARTITION BY course_id ORDER BY score DESC) AS dr FROM score_info WHERE course_id = '01' ORDER BY score DESC LIMIT 6
| course_id | stu_id | score | rn | rk | dr |
|---|---|---|---|---|---|
| 01 | 001 | 94 | 1 | 1 | 1 |
| 01 | 015 | 90 | 2 | 2 | 2 |
| 01 | 020 | 89 | 3 | 3 | 3 |
| 01 | 004 | 85 | 4 | 4 | 4 |
| 01 | 010 | 84 | 5 | 5 | 5 |
| 01 | 014 | 81 | 6 | 6 | 6 |
FROM … WHERE … GROUP BY … HAVING 之后、ORDER BY 之前执行,所以 WHERE 里不能直接用窗口函数别名,要套一层子查询。08写一个自己的 UDF(完整流程)
内置函数不够用时自己写:Java 代码 → 打包 → 上传 → 注册 → 调用。
// 1) Java 代码:把字符串转成小写再拼后缀(maven 依赖 hive-exec 4.1.0)
package com.demo.udf;

import org.apache.hadoop.hive.ql.exec.UDF;
import org.apache.hadoop.io.Text;

public class MyLowerUDF extends UDF {
    public Text evaluate(Text input) {
        if (input == null) return null;
        return new Text(input.toString().toLowerCase() + "_hive");
    }
}

// 2) 打包并上传到 HDFS
//    mvn package  →  target/myudf-1.0.jar
//    hdfs dfs -put myudf-1.0.jar /user/hadoop/jars/

// 3) 在 Hive 里注册(临时函数,只在当前会话有效)
ADD JAR /user/hadoop/jars/myudf-1.0.jar;
CREATE TEMPORARY FUNCTION my_lower AS 'com.demo.udf.MyLowerUDF';

// 4) 使用
SELECT my_lower('HIVE') AS r;          -- 结果:hive_hive
SELECT my_lower(stu_name) FROM student_info LIMIT 3;| r |
|---|
| hive_hive |
CREATE FUNCTION … USING JAR 并写进元数据。