单元4 Hive数据操作
把数据搬进 Hive、搬出 Hive,并理解 Hive 事务的边界
本单元学习目标 摘自课件“学习目标/Target”页
- 掌握向表加载文件的操作,能够熟练运用LOAD DATA语句将文件中的数据加载到表中。
- 掌握插入数据的操作,能够熟练运用INSERT语句向表中插入数据。
- 熟悉将查询结果写入文件的操作,能够使用INSERT语句将表的查询结果导出到指定文件中。
- 了解事务操作,能够在Hive中启用事务支持,并实现事务表的数据更新与删除。
- 了解导入与导出数据,能够完成表级别的数据迁移与复制操作。
单元概述
Hive数据操作是数据仓库建设中承接表结构定义与数据分析应用的重要环节。在完成数据库、表、分区等对象的定义后,还需要将数据加载到表中,并根据业务需求完成数据插入、更新、删除等操作。为此,Hive提供了数据操作语言(Data Manipulation Language,简称DML),用于对表中的数据进行管理。本单元将详细讲解Hive中常用的数据操作方法。
知识地图
本单元知识地图
学完本单元,你应该能回答
- LOAD DATA 的 LOCAL 与 OVERWRITE 组合会产生哪四种行为?
- INSERT INTO 与 INSERT OVERWRITE 的差别?
- Hive 事务要满足哪些前提条件才能启用?
- 怎样把查询结果导出成文件或导入到 MySQL?
知识链位置
← 前置知识
单元3 Hive数据定义表结构是数据操作的容器后续延伸 →
单元5 Hive数据查询数据就位,开始分析核心知识 点击标题右侧勾选框可标记“已掌握”,进度会保存在本机浏览器
向表加载文件
掌握向表加载文件的操作,能够熟练运用LOAD DATA语句将文件中的数据加载到表中。
Hive是一种面向大规模数据处理的数据仓库工具,在实际应用中通常需要一次性将海量数据加载到表中。这些数据通常来自外部文件,常见存储位置包括HDFS、本地文件系统等。虽然用户可以直接将文件放入表的数据存储目录,由Hive按表的解析规则读取,但官方更推荐使用LOAD DATA语句将文件加载到表中,以确保操作过程的规范性。
LOAD DATA语句的本质是将文件复制或移动到表的数据存储目录中,并不会对文件内容进行转换,也不会触发执行引擎。从Hive 3.0开始,在某些特殊场景下,该语句可能被内部转换为插入数据的执行逻辑,从而通过执行引擎完成加载。例如,向分桶表加载数据,或向分区表加载数据但未显式指定分区信息。
LOAD DATA [LOCAL] INPATH filepath
[OVERWRITE]
INTO TABLE [db_name.]table_name
[PARTITION (col=value[,col=value,...])]
[INPUTFORMAT inputformat SERDE serde];
LOAD DATA语句的语法格式如下。
语法格式
接下来,针对上述语法格式的进行介绍。
LOCAL关键字为可选,用于指定文件是否位于本地文件系统,具体说明如下。
1. LOCAL关键字
当指定LOCAL关键字时,Hive会从HiveServer2所在服务器的本地文件系统中,将指定文件复制到表的数据存储目录。
当未指定LOCAL关键字时,如果filepath参数是带scheme的完整URL,那么Hive会从对应的文件系统中将指定文件移动到表的数据存储目录,否则Hive会根据Hadoop配置文件core-site.xml中的参数fs.defaultFS推断文件系统,并将文件移动到表的数据存储目录。
需要注意的是,在未指定LOCAL关键字的情况下,filepath参数所指向的文件必须与表的数据存储目录位于同一文件系统中。
filepath参数既可以指定单个文件路径,也可以指定目录路径。当指定为目录路径时,Hive会复制或移动该目录下的所有文件,包含子目录中的文件(Hive 3.0引入的新特性)。
2. filepath参数
filepath参数指定的路径支持以下三种形式,具体介绍如下。
相对路径是指相对于当前位置的路径,在指定LOCAL关键字时,当前位置为本地文件系统中HiveServer2的工作路径,即启动HiveServer2时所处的路径,否则当前位置通常为相应文件系统的/user/<username>/路径,其中username取决于Hive的操作用户。
绝对路径是指从根目录开始的完整路径。例如/export/data/project/data.txt就是一个绝对路径。
带scheme的完整URL是指包含协议、主机、端口和路径所组成的统一资源定位符,通过协议可以推断出文件系统的类型。
OVERWRITE关键字为可选,用于指定加载数据的模式为覆盖。当指定OVERWRITE关键字时,Hive会清空表中的原有数据,再将指定文件的数据加载到表中;当未指定OVERWRITE关键字时,表示以追加模式加载数据,Hive直接将指定文件的数据追加到表中,而不会清空表中的原有数据。
3. OVERWRITE关键字
4. db_name参数
db_name参数为可选,用于指定数据库的名称,表示向该数据库中的表加载数据。若未指定,则向当前使用数据库中的表加载数据。
table_name参数用于指定表的名称。
5. table_name 参数
6. PARTITION 子句
PARTITION子句为可选,用于向分区表的指定分区加载数据。col参数用于指定分区字段,分区字段的数量与顺序必须与创建分区表时定义的分区字段一致。value用于指定分区字段对应的取值。
在Hive 3.0之前,向分区表加载数据时,必须通过PARTITION子句显式指定分区信息,这种方式称为静态分区。从Hive 3.0开始,如果未指定PARTITION子句,Hive会尝试自动推断,将文件的最后N列数据作为分区字段的值,其中N等于分区字段的数量,这种方式称为动态分区。若文件的内容不符合预期,则会报错。
INPUTFORMAT子句和SERDE子句为可选,在Hive 3.0中新增,用于指定读取文件的规则,其中inputformat参数用于指定读取文件所使用的类,默认为TextInputFormat,适用于文本文件类型;serde参数用于指定序列化和反序列化的类型,默认为原生SerDe。
7. INPUTFORMAT子句和SERDE子句
接下来,演示如何将文件加载到Hive表和分区中,具体内容如下。
▸ 课件步骤 01
在Hive中创建数据库chapter4,具体HiveQL语句如下。
CREATE DATABASE IF NOT EXISTS chapter4;▸ 课件步骤 02
在chapter4数据库中创建表orders_np,具体HiveQL语句如下。
点击查看
▸ 课件步骤 03
在chapter4数据库中创建分区表orders,具体HiveQL语句如下。
▸ 课件步骤 04
在虚拟机Node02中创建/export/data/chapter4目录,用于存放向表orders_np和分区表orders加载数据时所需的文件,在虚拟机Node02中执行如下命令。
mkdir /export/data/chapter4▸ 课件步骤 05
将文件orders_np.json、orders_2025_08.csv和orders_2025_09.csv上传到虚拟机Node02的/export/data/chapter4目录,关于这三个文件的介绍如下。
①文件orders_np.json用于向表orders_np加载数据,其内容如文件。
▸ 课件步骤 05
②文件orders_2025_08.csv用于通过静态分区的方式向分区表orders加载数据,其内容如文件。
▸ 课件步骤 05
③文件orders_2025_09.csv用于通过动态分区的方式向分区表orders加载数据,其内容如文件。
▸ 课件步骤 06
为了演示如何通过HDFS中的文件向分区表orders加载数据,这里将文件orders_2025_08.csv和orders_2025_09.csv上传到HDFS的/hive/data/chapter4目录中,操作步骤如下。
①在HDFS创建/hive/data/chapter4目录,在虚拟机Node02中执行如下命令。
hdfs dfs -mkdir -p /hive/data/chapter4▸ 课件步骤 06
②将文件orders_2025_08.csv和orders_2025_09.csv上传到HDFS的/hive/data/chapter4目录中,在虚拟机Node02的/export/data/chapter4目录中执行如下命令。
hdfs dfs -put orders_2025_08.csv orders_2025_09.csv /hive/data/chapter4▸ 课件步骤 07
通过本地文件系统中的文件orders_np.json向表orders_np加载数据,具体HiveQL语句如下。
LOAD DATA LOCAL INPATH '/export/data/chapter4/orders_np.json'OVERWRITE INTO TABLE chapter4.orders_np;▸ 课件步骤 07
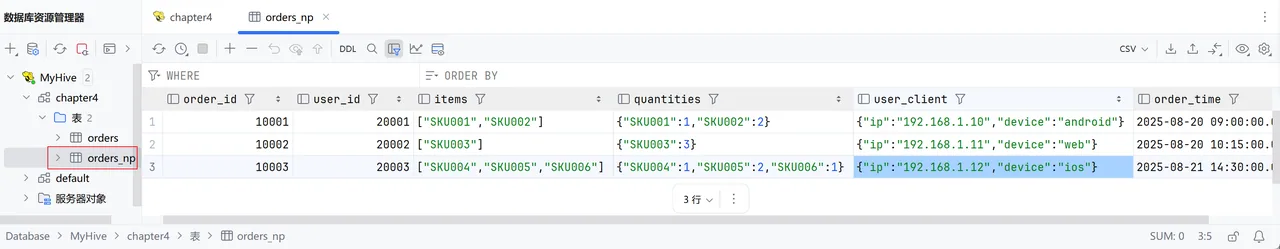
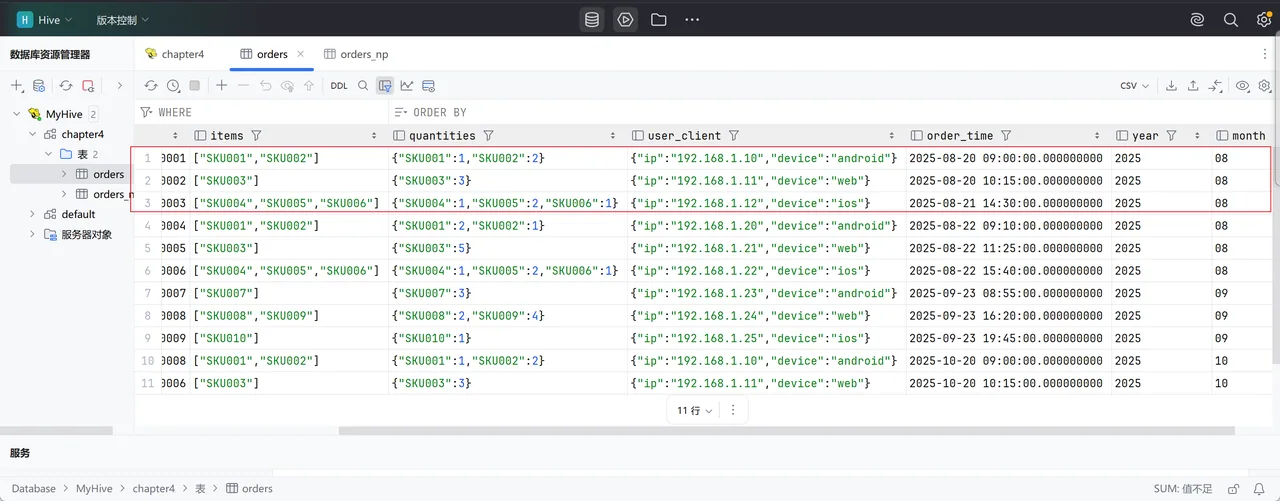
上述命令执行完成后,在DataGrip的“数据库资源管理器”区域,双击chapter4数据库中的表orders_np,查看该表中的数据,如图。
▸ 课件步骤 08
通过HDFS中的文件orders_2025_08.csv向分区表orders加载数据,并分别指定分区字段year和month的值为2025和08,具体HiveQL语句如下。
LOAD DATA INPATH '/hive/data/chapter4/orders_2025_08.csv'OVERWRITE INTO TABLE chapter4.orders
PARTITION (year='2025',month='08');▸ 课件步骤 08
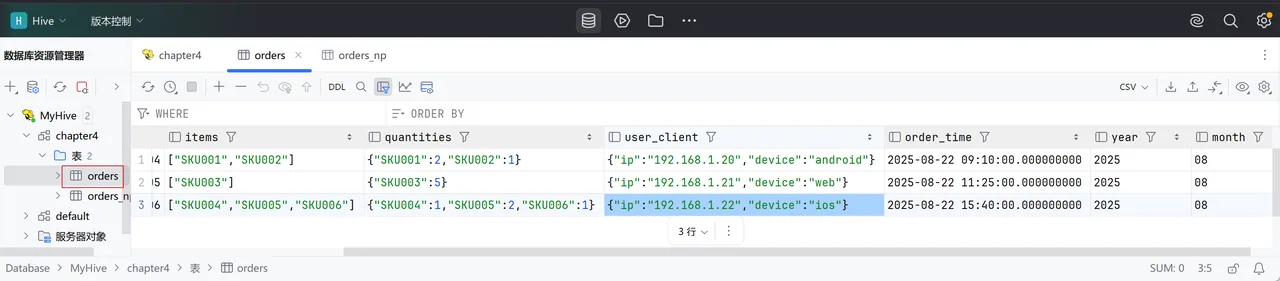
上述命令执行完成后,在DataGrip的“数据库资源管理器”区域,双击chapter4数据库中的分区表orders,查看该分区表中的数据,如图。
▸ 课件步骤 09
通过HDFS中的文件orders_2025_09.csv向分区表orders加载数据,具体HiveQL语句如下。
LOAD DATA INPATH '/hive/data/chapter4/orders_2025_09.csv'INTO TABLE chapter4.orders;▸ 课件步骤 09
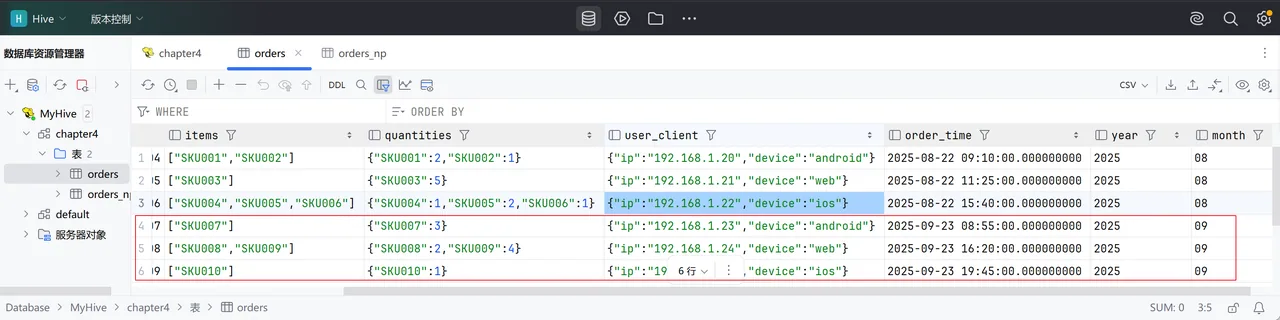
上述命令执行完成后,会触发Tez执行分布式计算,将数据加载到分区表orders中。执行完成后,在DataGrip的“数据库资源管理器”区域,双击chapter4数据库中的分区表orders,查看该分区表中的数据,如图。
任务:向表插入数据
4.2
四种加载组合一次说清:LOCAL / 非 LOCAL × INTO / OVERWRITE。
-- ① 本地文件 + 追加(最常用)
LOAD DATA LOCAL INPATH '/home/hadoop/data/student_info.txt' INTO TABLE student_info;
-- ② 本地文件 + 覆盖
LOAD DATA LOCAL INPATH '/home/hadoop/data/student_info.txt' OVERWRITE INTO TABLE student_info;
-- ③ HDFS 文件 + 追加(文件会被移动到表目录)
LOAD DATA INPATH '/user/hadoop/data/student_info.txt' INTO TABLE student_info;
-- ④ HDFS 文件 + 覆盖
LOAD DATA INPATH '/user/hadoop/data/student_info.txt' OVERWRITE INTO TABLE student_info;

SELECT count(*) FROM student_info;
💡 LOCAL 从客户端本机读文件(复制),不带 LOCAL 从 HDFS 读(移动,原文件会消失)。
📄 展开课件原文(第 6–34 页,共 29 页)
向表插入数据
掌握插入数据的操作,能够熟练运用INSERT语句向表中插入数据。
在实际应用中,除了将已有文件加载到表中,还常常需要将少量数据直接写入表,或将查询结果批量写入目标表。为此,Hive提供了INSERT语句,用于向表中插入数据。与LOAD DATA语句不同,INSERT语句会触发底层执行引擎,并在HDFS中生成新的数据文件。Hive支持两种向表插入数据的方式,分别是将值插入表和将查询结果插入表,具体介绍如下。
将值插入表
A
将查询结
果插入表
B
将值插入表是指通过为表中每个字段指定取值来插入单行或多行数据。如果某个字段无须赋值,不能省略该字段的取值,而必须使用字面量null代替。由于这种方式插入数据的效率较低,并且容易在HDFS中产生小文件,所以并不是大数据场景下向表插入数据的常用手段,而更多用于测试或小规模的数据补录。
1. 将值插入表
将值插入表的语法格式如下。
INSERT INTO TABLE [db_name.]table_name[PARTITION (col[=partvalue][,col[=partvalue],...])]VALUES (value[,value,...])[,(value[,value,...]),...]上述语法格式的介绍如下。
PARTITION子句
PARTITION子句为可选,用于通过显式指定分区信息,将数据插入到分区表的特定分区中,即静态分区。col参数用于指定分区字段,分区字段的数量与顺序必须与创建分区表时定义的分区字段一致。partvalue参数为可选,用于指定分区字段对应的取值。若未指定分区字段对应的取值,则实现动态分区。例如,PARTITION (year='2025',month='08')表示静态分区,PARTITION (year,month)表示动态分区。
从Hive 3.0开始,可以直接省略PARTITION子句以实现动态分区
VALUES子句
VALUES子句用于指定每个字段的取值,每组字段取值由小括号包裹,表示一行数据。value参数用于指定字段的取值,可以是字面量、表达式或函数的返回值。每行数据中值的数量和顺序必须与建表时定义的字段一致。
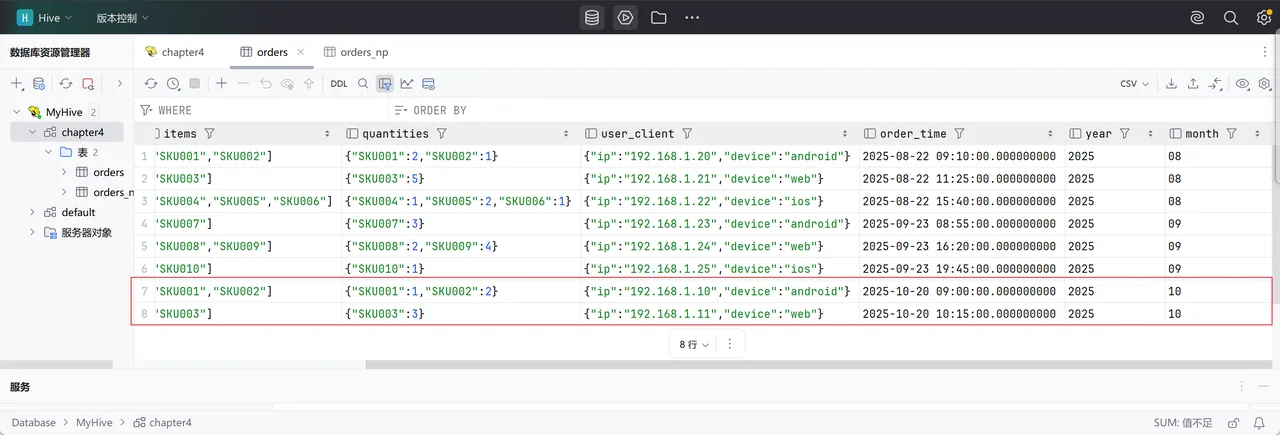
接下来,演示如何使用将值插入表的方式向chapter4数据库的分区表orders插入数据,具体HiveQL语句如下。
点击查看
上述命令执行完成后,在DataGrip的“数据库资源管理器”区域,双击chapter4数据库中的分区表orders,查看该分区表中的数据,如图。
将查询结果插入表是指通过SELECT语句将指定表的查询结果插入到目标表中。由于这种方式能够一次性批量插入数据,因此是大数据场景下向表插入数据的常用手段。关于将查询结果插入表的语法格式如下。
INSERT OVERWRITE TABLE [db_name.]table_name[PARTITION (col=value[,col=value,...])]
[IF NOT EXISTS]] select_statement;
select_statement;2.将查询结果插入表
覆盖插入:先删除目标表的原有数据,再插入新数据
追加插入:向目标表追加数据,不会删除表的原有数据
结果中的最后N个字段会依次作为分区字段的取值,其中N等于分区字段的数量。
接下来,演示如何使用将查询结果插入表的方式向chapter4数据库的分区表orders插入数据,具体HiveQL语句如下。
多重插入
多重插入是指在一次查询中,将同一张表的结果集根据不同条件分别插入到多个目标表中。其核心目标是一次扫描,多个插入,从而减少对表的重复扫描,提升整体执行效率。关于多重插入的语法格式如下。
FROM [db_name.]table_name
INSERT OVERWRITE TABLE …[INSERT INTO TABLE …]
…;现在希望通过多重插入,将chapter4数据库中分区表orders中的字段user_id和quantities插入分区表orders_user_quantities,并将分区表orders中的字段user_id和user_client插入分区表orders_user_client,具体HiveQL语句如下。
FROM chapter4.ordersINSERT INTO TABLE chapter4.orders_user_quantities
SELECT user_id,quantities,year,month
INSERT INTO TABLE chapter4.orders_user_client
SELECT user_id,user_client,year,month任务:将查询结果写入文件
4.3
三种插入方式,按数据量选。
-- ① VALUES:少量数据
INSERT INTO student_info VALUES ('021','新同学','2000-01-01','男');
-- ② INSERT … SELECT:批量加工(ETL 主力)
INSERT OVERWRITE TABLE stu_male SELECT * FROM student_info WHERE sex = '男';
-- ③ 多表插入:一次扫描写多张表(省一次全表扫描)
FROM student_info
INSERT OVERWRITE TABLE stu_male SELECT * WHERE sex = '男'
INSERT OVERWRITE TABLE stu_female SELECT * WHERE sex = '女';
💡 多表插入(Multi-Table Insert)是 Hive 特有的效率技巧:只扫一遍源表就能写多个目标。
📄 展开课件原文(第 35–48 页,共 14 页)
将查询结果写入文件
熟悉将查询结果写入文件的操作,能够使用INSERT语句将表的查询结果导出到指定文件中。
在Hive中,查询结果通常会被插入到表中,以便后续分析与处理。但为了便于外部系统使用,Hive还提供了一种更灵活的方式,将查询结果直接写入文件并存放在文件系统中。
INSERT OVERWRITE [LOCAL] DIRECTORY directory
[ROW FORMAT row_format] [STORED AS file_format]
select_statement
关于Hive中将查询结果写入文件的语法格式如下。
语法格式
用于指定查询结果的写入位置是否为本地文件系统
用于指定文件的存放路径,若路径不存在则自动创建
用于指定查询结果的序列化格式,默认为原生SerDe
用于指定文件的存储格式,默认为TEXTFILE
用于指定查询语句
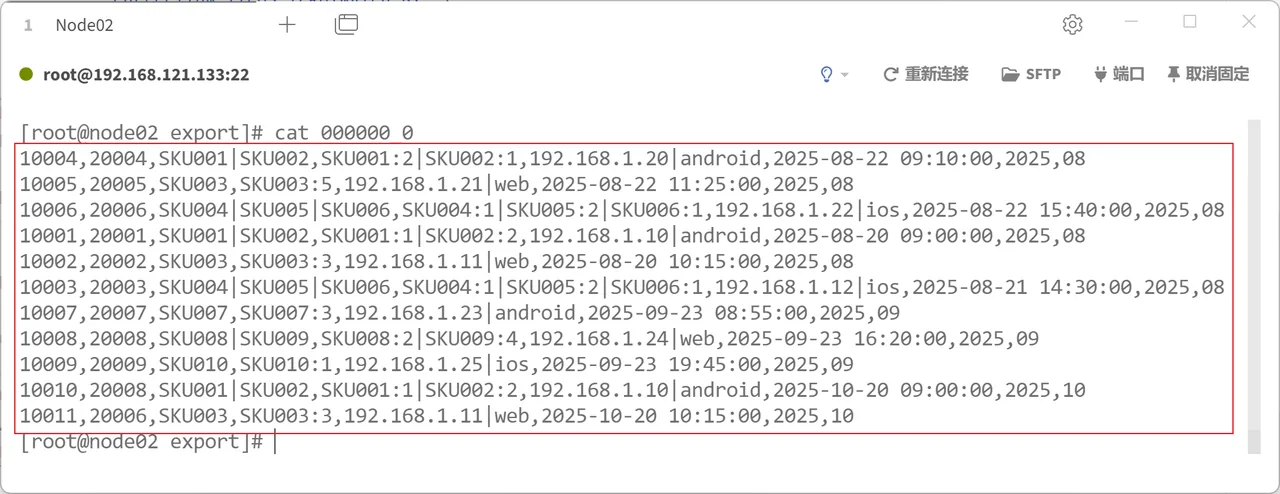
接下来,演示如何将chapter4数据库中分区表orders的全部数据写入到本地文件系统,具体HiveQL语句如下。
INSERT OVERWRITE LOCAL DIRECTORY '/export/data/chapter4/export'ROW FORMAT DELIMITED
FIELDS TERMINATED BY ','
COLLECTION ITEMS TERMINATED BY '|'
MAP KEYS TERMINATED BY ':'SELECT * FROM chapter4.orders;上述命令执行完成后,在虚拟机Node02的/export/data/chapter4/export路径下会生成一个名为000000_0的文件,通过cat命令查看该文件的内容,如图。
多路径写入
多路径写入是指在一次查询中,将同一张表的结果集根据不同条件分别写入到多个路径的文件中。其核心目标是一次扫描,多路径写入,从而减少对表的重复扫描,提升整体执行效率。关于多路径写入的语法格式如下。
FROM [db_name.]table_name
INSERT OVERWRITE [LOCAL] DIRECTORY …
[INSERT OVERWRITE [LOCAL] DIRECTORY …]
…;
多重导出
例如,将chapter4数据库中分区表orders的year=2025/month=08和year=2025/month=09两个分区,分别导出到本地文件系统的/export/data/chapter4/export/2025-08和/export/data/chapter4/export/2025-09路径下,具体HiveQL语句如下。
点击查看
任务:执行Hive事务操作
4.4
📄 展开课件原文(第 49–56 页,共 8 页)
4.4 执行Hive事务操作
执行Hive事务操作(任务导学)
Hive的数据操作语言除了包含包含加载文件、插入数据和写入查询结果之外,还支持更新和删除操作。不过,这些操作仅适用于已启用事务支持的表。因此,在讲解这些操作之前,需要先介绍Hive事务的概念。本任务将以事务为切入点,逐步展开对Hive中更新和删除操作的讲解。
📄 展开课件原文(第 57–57 页,共 1 页)
认识事务
了解事务,能够描述事务的ACID特性。
在传统的关系型数据库管理系统(RDBMS)中,事务(Transaction)是保证数据一致性和可靠性的重要机制。事务具有典型的ACID特性,即原子性(Atomicity)、一致性(Consistency)、隔离性(Isolation)、持久性(Durability),具体介绍如下。
每个事务作为一个整体,要么全部执行成功,要么全部失败,不会出现部分成功的情况。
原子性
事务执行前后,数据始终保持一致的约束状态。
一致性
多个事务同时执行时,彼此之间不会相互干扰。
隔离性
一旦事务提交,其修改结果会被永久保存,不会因系统故障而丢失。
持久性
事务
📄 展开课件原文(第 58–60 页,共 3 页)
了解Hive中的事务
了解Hive中的事务,能够描述基础文件和增量文件。
Hive最初的设计目标是面向大规模数据的批处理分析,而非高频事务处理。因此在早期版本中,并不支持事务操作,表中数据一旦写入,几乎只能进行只读查询或整体覆盖。
随着Hive在企业级数据仓库和大数据场景中的广泛应用,事务逐渐成为必需功能。尤其是在涉及数据更新与删除时,事务机制能够管理数据版本,避免错误或不一致。为满足这一需求,Hive社区自0.13版本开始逐步引入事务支持,并在后续版本中不断完善,使用户能够执行更新、删除等事务操作,从而更好地满足数据管理需求。
Hive 的数据通常存储在HDFS上,而HDFS不支持修改已有文件内容,仅允许在文件末尾追加数据。这一限制直接影响了Hive表中数据的更新和删除。为此,Hive在事务表中引入了基础文件和增量文件两类文件,用于分别存储数据和事务操作,具体介绍如下。增量
文件
基础
基础文件用于存储事务表的数据。在物理层面,Hive会根据事务表是否分区,在事务表的数据存储目录或分区目录下生成以base为前缀的目录,用于存放基础文件。
基础文件
增量文件用于记录事务表的事务操作,包括插入、更新、删除等。
增量文件
在查询事务表数据时,Hive会同时读取基础文件和增量文件,并在查询过程中应用事务操作的逻辑。若事务表进行了分区,Hive会根据查询条件,仅读取相关分区目录下的基础文件与增量文件,从而提升查询效率。
随着事务表中事务操作的不断增加,增量文件的数量也会逐渐增多。如果在查询时需要处理过多的增量文件,不仅会降低查询性能,还会因小文件过多而加重HDFS的元数据管理开销。
为解决这一问题,Hive在后台进程中提供了Compactor(合并器),用于合并增量文件,Compactor会将合并任务以MapReduce的形式提交到YARN集群执行。Compactor内部主要由4个核心组件组成,分别是Initiator、Worker、Cleaner和AcidHouseKeeperService,具体介绍如下。
Initiator组件:
Worker组件
Cleaner组件:
负责清除旧的基础文件或增量文件。
负责发现需要进行合并的增量文件。
负责实际执行合并任务。
AcidHouseKeeperService组件:
负责清理执行失败或异常中断的事务。
Compactor合并增量文件的方式主要分为Minor Compaction(小合并)和Major Compaction(大合并)两种类型,具体介绍如下。
Major Compaction
Minor Compaction
Minor Compaction将多份现有增量文件合并为一个新的增量文件,从而减少增量文件的数量。旧的增量文件会被标记为删除,并最终清理。若事务表进行了分区,则仅针对各分区目录下的增量文件进行合并。默认情况下,当表的数据存储目录或某个分区目录下的增量文件数达到10时,会自动触发。
1. Minor Compaction
具体格式
Minor Compaction除了可以自动触发外,也支持手动触发,语法格式如下。
ALTER TABLE [db_name.]table_name[PARTITION (col[=partvalue][,col[=partvalue],...])] COMPACT 'minor';Major Compaction将所有增量文件中的事务操作应用到基础文件,生成新的基础文件。若新建事务表不存在基础文件,则基于所有增量文件生成基础文件。旧的基础文件和增量文件会被标记为删除,并最终清理。若事务表进行了分区,则上述过程仅针对各分区目录下的增量文件和基础文件。
2. Major Compaction
具体代码
默认情况下,当表的数据存储目录或某个分区目录下所有增量文件的总大小达到基础文件的10%时,会自动触发。Major Compaction除了可以自动触发外,也支持手动触发,语法格式如下。
[PARTITION (col[=partvalue][,col[=partvalue],...])] COMPACT 'major';需要注意的是,在Hive中的事务表必须是文件格式为ORC的内部表,且显式指定预定义属性transactional的值为TRUE。此外,事务表仅支持通过插入数据的方式导入数据。
在手动触发合并时,HiveServer2需要直接连接存储元数据的关系型数据库以获取元数据信息,而不是通过Metastore进行访问。因此,为确保HiveServer2能够精确连接到存储元数据的关系型数据库,需要在HiveServer2的配置文件中添加连接参数。
手动触发合并
针对本教材中远程模式部署的Hive为例,需要虚拟机Node02的/export/servers/hive-4.1.0/conf目录中,编辑Hive配置文件hive-site.xml,在该文件的<configuration>标签中添加如下配置。
点击查看
📄 展开课件原文(第 61–74 页,共 14 页)
启用事务支持
了解事务操作,能够完成启用事务支持的操作。
默认情况下,Hive并未启用事务支持。若要在Hive中创建事务表并执行事务操作,需要在配置文件中添加相关参数以启用事务支持。以下为必须配置的关键参数。
hive.support.concurrency参数:
hive.txn.manager参数:
hive.compactor.initiator.on参数:
用于控制是否启用Compactor的Initiator组件。
用于控制是否启用并发支持。
用于指定事务管理器的实现类。
hive.compactor.cleaner.on参数:用于控制是否启用Compactor的Cleaner组件。
hive.compactor.worker.threads参数:用于控制Compactor中Worker组件的数量。
接下来,以远程模式部署的Hive为例,演示如何启用事务支持,并完成创建事务表和插入数据的操作,具体步骤如下。
▸ 课件步骤 01
在虚拟机Node02的/export/servers/hive-4.1.0/conf目录中,编辑Hive配置文件hive-site.xml,在该文件的<configuration>标签中添加如下配置。
点击查看
▸ 课件步骤 02
在虚拟机Node03的/export/servers/hive-4.1.0/conf目录中,编辑Hive配置文件hive-site.xml,在该文件的<configuration>标签中添加如下配置。
<property>
<name>hive.compactor.initiator.on</name>
<value>true</value>
</property>
<name>hive.compactor.cleaner.on</name>
▸ 课件步骤 03
分别在虚拟机Node02和Node03中重新启动HiveServer2和Metastore,使配置文件修改的内容生效。
▸ 课件步骤 04
在chapter4数据库中创建事务表orders_transaction,具体HiveQL语句如下。
▸ 课件步骤 05
向事务表orders_transaction插入数据,具体HiveQL语句如下。
INSERT INTO TABLE chapter4.orders_transactionSELECT
order_id,
user_id,
items,
quantities,
user_client,
order_time,
year,
month
FROM chapter4.orders;▸ 课件步骤 06
查看事务表orders_transaction在HDFS中的目录结构,在虚拟机Node02中执行如下命令。
hdfs dfs -ls -R /user/hive/remote/warehouse/chapter4.db/orders_transaction▸ 课件步骤 06
上述命令执行完成后输出的目录结构如下。
▸ 课件步骤 06
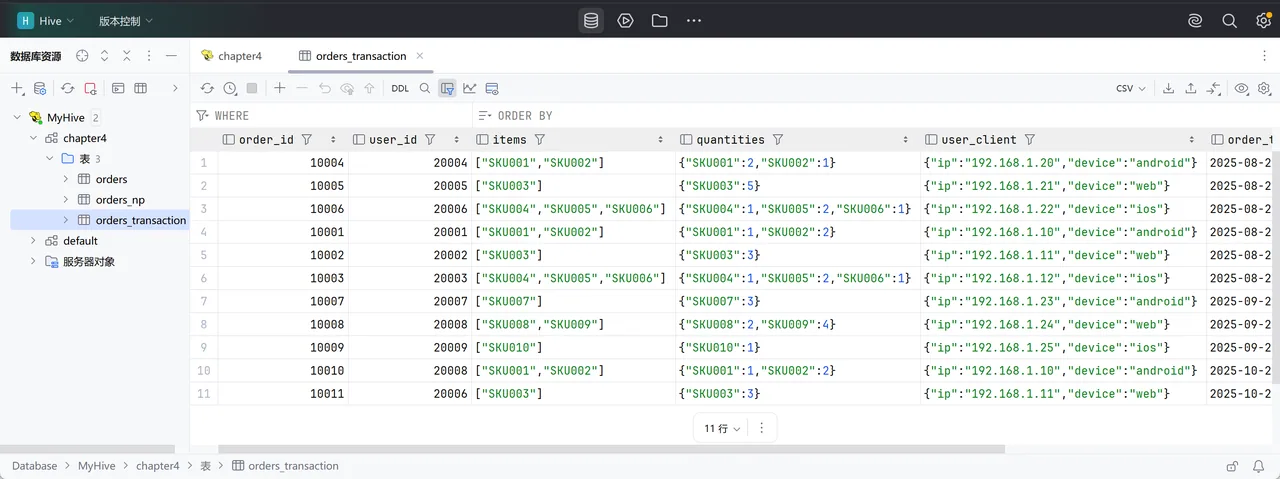
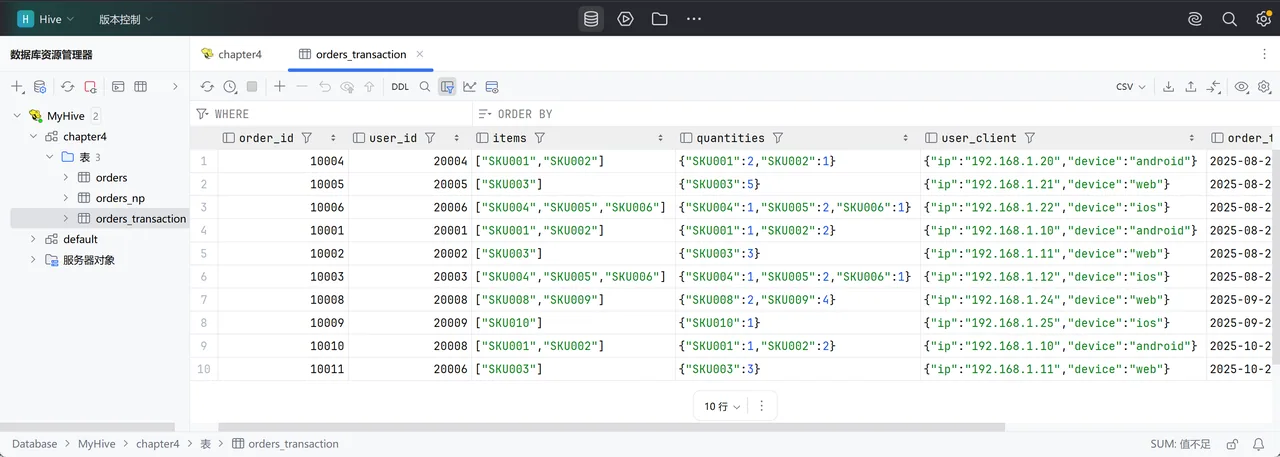
在DataGrip的“数据库资源管理器”区域,双击chapter4数据库中的事务表orders_transaction,查看该事务表中的数据,如图。
查看增量文件或基础文件的内容
由于事务表采用ORC文件格式,因此无论是增量文件还是基础文件,其内容均为二进制数据,无法直接通过文本方式查看。若需要查看HDFS中这些文件的内容,可以使用Hive提供的ORCFileDump工具,其语法格式如下。
语法格式
hive --orcfiledump -d path用于指定增量文件或基础文件在HDFS上的路径
事务表的三项前提与开启方式。
-- 前提:ORC + 分桶 + transactional=true
CREATE TABLE student_acid(stu_id STRING, stu_name STRING)
CLUSTERED BY (stu_id) INTO 4 BUCKETS
STORED AS ORC
TBLPROPERTIES ('transactional'='true');

SET hive.support.concurrency = true;
SET hive.enforce.bucketing = true;
SET hive.exec.dynamic.partition.mode = nonstrict;
SET hive.txn.manager = org.apache.hadoop.hive.ql.lockmgr.DbTxnManager;
SET hive.compactor.initiator.on = true;
SET hive.compactor.worker.threads = 1;
💡 少任何一项,UPDATE / DELETE 都会报 “Table is not ACID”。
📄 展开课件原文(第 75–86 页,共 12 页)
更新操作
了解事务操作,能够完成事务更新的操作。
在实际业务场景中,数据往往会随着业务的发展而不断调整。在传统的关系型数据库中,通常通过UPDATE语句完成数据修改。但在Hive的早期版本中,表中的数据几乎是只读的,一旦写入便无法直接更新。为了解决这一问题,Hive在事务表中引入了更新操作,使用户能够直接修改事务表中已有的数据。
具体语法
在Hive中更新操作的语法格式如下。
UPDATE [db_name.]table_name SET column=value [,column=value,...][WHERE expression];用于修改事务表中已有的数据
用于指定修改的字段
用于指定字段修改后的值,可以是常量、表达式或者函数返回值
用于指定筛选条件,表示仅修改符合筛选条件的行中指定字段的值
用于定义筛选条件。若省略WHERE子句,则修改所有行中指定字段的值
HiveQL语句
接下来,演示如何修改chapter4数据库中事务表orders_transaction的已有数据,具体HiveQL语句如下。
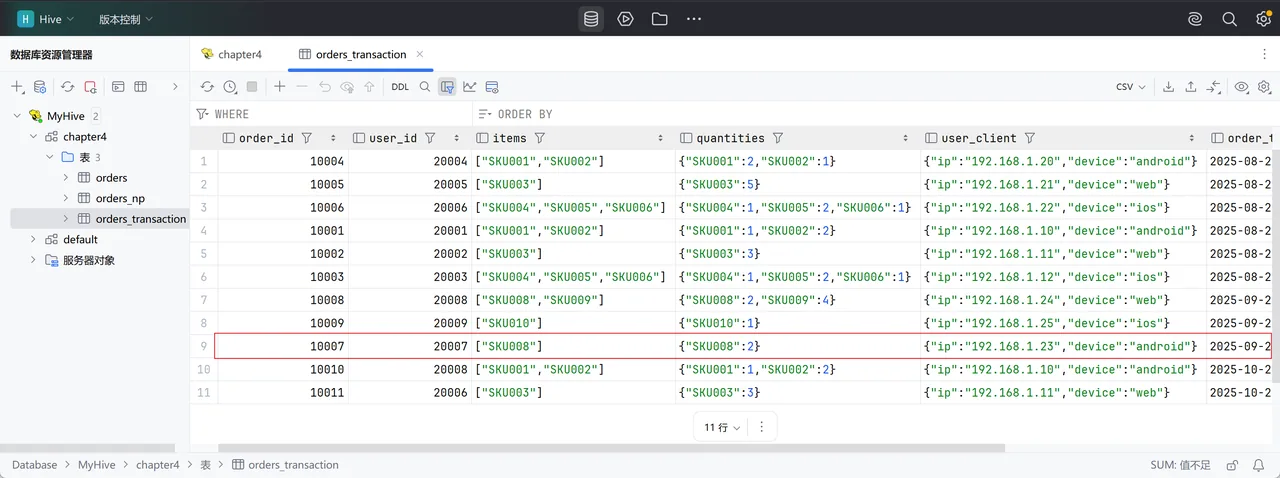
UPDATE chapter4.orders_transactionSET items=array('SKU008'),quantities=map('SKU008',2)WHERE year='2025' AND month='09' AND order_id=10007;在DataGrip的“数据库资源管理器”区域,双击chapter4数据库中的事务表orders_transaction,查看该事务表中的数据,如图。
更新一行数据(仅事务表可用)。
UPDATE student_acid SET stu_name = '新名字' WHERE stu_id = '001';
SELECT * FROM student_acid WHERE stu_id = '001';
💡 更新是“追加增量文件 + 读取时合并”,所以会不断产生增量文件,需要定期 COMPACT 合并。
📄 展开课件原文(第 87–91 页,共 5 页)
删除操作
了解事务操作,能够完成事务删除的操作。
在数据仓库的日常管理中,除了需要设计数据的加载、插入和更新外,往往还会涉及删除数据的需求。在传统的关系型数据库中,通常通过DELETE语句完成删除操作。但在Hive的早期版本中,表中的数据几乎是只读的,因此并不支持直接删除。为了解决这一问题,Hive在事务表中引入了删除操作,使用户能够安全、可靠地删除事务表中的数据。
语法格式
在Hive中删除操作的语法格式如下。
DELETE FROM [db_name.]table_name [WHERE expression];在上述语法格式中,若省略WHERE子句,则删除事务表的所有行,否则仅删除符合筛选条件的行。
HiveQL语句
接下来,演示如何删除chapter4数据库中事务表orders_transaction的数据,具体HiveQL语句如下。
DELETE FROM chapter4.orders_transaction
WHERE year='2025' AND month='09' AND order_id=10007;
上述语句表示删除分区year=2025/month=09中字段order_id的值等于10007的行。
在DataGrip的“数据库资源管理器”区域,双击chapter4数据库中的事务表orders_transaction,查看该事务表中的数据,如图。
任务:导入与导出数据
4.5
删除满足条件的行(仅事务表可用)。
DELETE FROM student_acid WHERE stu_id = '020';
SELECT count(*) FROM student_acid;
💡 非事务表想删数据只能 INSERT OVERWRITE 重写整张表(用 SELECT 过滤掉不要的行)。
📄 展开课件原文(第 92–97 页,共 6 页)
导入与导出数据
了解导入与导出数据,能够完成表级别的数据迁移与复制操作。
在数据仓库的日常管理中,除了常见的加载文件、插入数据和写入查询结果等操作外,Hive还提供了 EXPORT和IMPORT两条语句,用于表级别的数据迁移与复制。这两条语句通常配合使用,主要用于在不同Hive系统之间传输表及其数据,或者在备份与恢复场景中使用,具体介绍如下。
IMPORT语句
EXPORT语句
语法格式
EXPORT语句用于将表的元数据和数据一并导出到HDFS的指定目录中,具体语法格式如下。
EXPORT TABLE [db_name.]table_name[PARTITION (col=value[,col=value,...])]
TO export_target_path;1. EXPORT语句
用于指定导出目录在HDFS上的路径
HiveQL语句
接下来,演示如何将chapter4数据库中分区表orders的分区year=2025/month=08导出到HDFS的指定路径,具体HiveQL语句如下。
EXPORT TABLE chapter4.ordersPARTITION (year='2025', month='08')
TO '/hive/data/chapter4/orders_2025_08';IMPORT语句用于从HDFS指定目录中读取由EXPORT语句导出的数据和元数据,并在当前Hive环境中导入相应的表,其语法格式如下。
IMPORT [[EXTERNAL] TABLE [db_name.]table_name[PARTITION (col=value[,col=value,...])]]
FROM source_path
[LOCATION hdfs_path]2. IMPORT语句
用于指定导入的表为外部表
用于指定EXPORT语句导出的数据和元数据所在路径
用于指定表在HDFS中存储数据的路径,通常与外部表配合使用
在IMPORT语句中,可以省略表名、所属数据库及分区信息等表定义,Hive会根据 EXPORT语句导出的元数据自动判断并执行导入操作。需要注意的是,若导入的表是分区表且已存在,则导入的分区不能与现有分区表的分区重复;若导入的表是非分区表且已存在,则要求现有表必须为空。
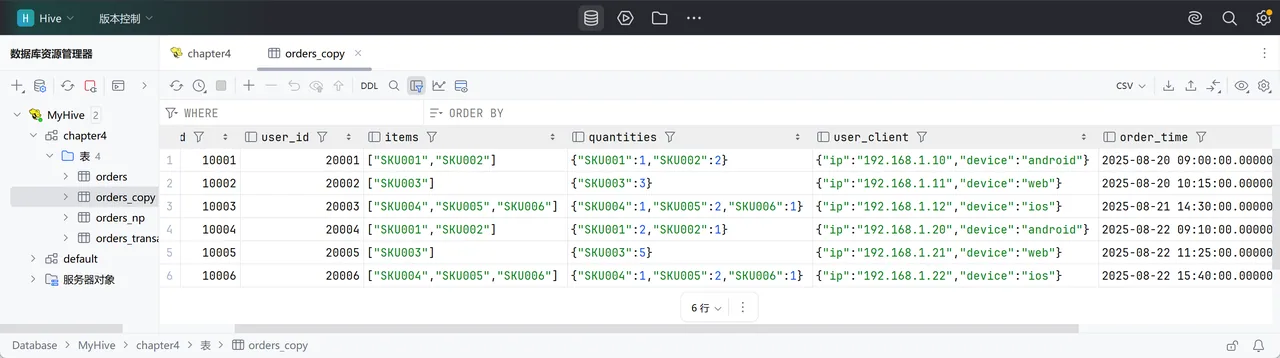
接下来,演示如何将EXPORT语句导出的元数据和数据导入到当前Hive环境中,具体HiveQL语句如下。
IMPORT TABLE chapter4.orders_copy FROM '/hive/data/chapter4/orders_2025_08';在DataGrip的“数据库资源管理器”区域,双击chapter4数据库中的分区表orders_copy,查看该分区表中的数据,如图。
AI助学
学完本单元后,我已经初步掌握了Hive中数据加载、数据插入、查询结果写出等操作。然而,在实际处理数据时,需要结合数据来源、目标表结构、操作目的和数据更新方式,判断应采用哪种数据操作方案。此时,可以借助AI对数据操作流程进行分析,帮助检查操作顺序是否合理,并提示可能存在的问题。
AI
助
学
单元总结
本单元主要讲解了Hive的数据操作语言。首先,介绍了向表加载文件。接着,介绍了向表插入数据和将查询结果写入文件。然后,介绍了事务操作,包括事务的概念、启用事务支持、更新操作等。最后,介绍了导入与导出数据。通过本单元的学习,读者能够熟练运用HiveQL语句对Hive中的数据进行加载、插入、导出等操作,为实际应用中管理数据仓库的数据奠定基础。
单
元
总
结
📄 展开课件原文(第 98–107 页,共 10 页)
🧪 动手做一遍 数据怎么进 Hive、怎么出 Hive
预计用时约 30 分钟 · 每一步都给出可执行语句与预期结果,建议边看边在 Beeline / DataGrip 里敲一遍
本实例步骤
- 01 方式一:LOAD DATA 批量搬运(最常用)
- 02 方式二:INSERT … VALUES 手工补几条
- 03 方式三:INSERT … SELECT 用查询结果造表
- 04 方式四:结果直接导出到文件
- 05 进阶:事务表里的 UPDATE / DELETE
- 06 跨系统搬运:Sqoop 导入导出
01方式一:LOAD DATA 批量搬运(最常用)
文件已经在本地或 HDFS 上时,这是最快的入库方式。
-- 建四张表(结构见“数据集准备”)
CREATE DATABASE IF NOT EXISTS school;
USE school;
-- (四张建表语句略,见页面顶部数据集准备)

-- 本地文件 → Hive 表(LOCAL 表示从客户端本机读,非 LOCAL 则从 HDFS 读)
LOAD DATA LOCAL INPATH '/home/hadoop/shell/data/student_info.txt' INTO TABLE student_info;
LOAD DATA LOCAL INPATH '/home/hadoop/shell/data/course_info.txt'  INTO TABLE course_info;
LOAD DATA LOCAL INPATH '/home/hadoop/shell/data/teacher_info.txt' INTO TABLE teacher_info;
LOAD DATA LOCAL INPATH '/home/hadoop/shell/data/score_info.txt' INTO TABLE score_info;验证语句:SELECT (SELECT count(*) FROM student_info) AS students, (SELECT count(*) FROM course_info) AS courses, (SELECT count(*) FROM teacher_info) AS teachers, (SELECT count(*) FROM score_info) AS scores
| students | courses | teachers | scores |
|---|---|---|---|
| 40 | 10 | 8 | 148 |
INTO 是追加,OVERWRITE 会先清空表目录再放新文件;LOCAL 决定从哪一端读文件。四种组合要能说清楚。02方式二:INSERT … VALUES 手工补几条
少量补录、测试时用,不适合大批量。
INSERT INTO student_info VALUES
  ('021','新同学A','2000-01-01','男'),
  ('022','新同学B','2000-02-02','女');

INSERT INTO score_info VALUES ('021','01',88), ('022','01',92);验证语句:SELECT stu_id, stu_name, sex FROM student_info WHERE stu_id IN ('021','022') ORDER BY stu_id
| stu_id | stu_name | sex |
|---|---|---|
| 021 | 新同学A | 男 |
| 022 | 新同学B | 女 |
💡 VALUES 每插一批都会起一个小作业,批量场景下比 LOAD 慢一个数量级,还容易产生小文件。
03方式三:INSERT … SELECT 用查询结果造表
把一张表的数据加工后写到另一张表(ETL 的核心动作)。
CREATE TABLE IF NOT EXISTS stu_male(
    stu_id STRING, stu_name STRING, birthday STRING, sex STRING
) ROW FORMAT DELIMITED FIELDS TERMINATED BY ',' STORED AS TEXTFILE;

INSERT INTO stu_male
SELECT stu_id, stu_name, birthday, sex FROM student_info WHERE sex = '男';

SELECT count(*) AS male_count FROM stu_male;验证语句:SELECT count(*) AS male_count FROM stu_male
| male_count |
|---|
| 23 |
INSERT INTO 换成 INSERT OVERWRITE 就是“每次全量重刷”,数仓里更常用。04方式四:结果直接导出到文件
把查询结果导成文件(本地或 HDFS),交给下游系统。
-- 导出到 HDFS 目录
INSERT OVERWRITE DIRECTORY '/tmp/score_out'
ROW FORMAT DELIMITED FIELDS TERMINATED BY ','
SELECT s.stu_name, c.course_name, sc.score
FROM score_info sc
JOIN student_info s ON sc.stu_id = s.stu_id
JOIN course_info  c ON sc.course_id = c.course_id;

-- 导出到客户端本地目录(Hive 4 支持 LOCAL)
INSERT OVERWRITE LOCAL DIRECTORY '/home/hadoop/out/score_out'
ROW FORMAT DELIMITED FIELDS TERMINATED BY ','
SELECT s.stu_name, c.course_name, sc.score
FROM score_info sc
JOIN student_info s ON sc.stu_id = s.stu_id
JOIN course_info c ON sc.course_id = c.course_id;验证语句:SELECT s.stu_name, c.course_name, sc.score FROM score_info sc JOIN student_info s ON sc.stu_id = s.stu_id JOIN course_info c ON sc.course_id = c.course_id ORDER BY sc.score DESC LIMIT 5
| stu_name | course_name | score |
|---|---|---|
| 胡歌 | 体育 | 100 |
| 胡歌 | 体育 | 100 |
| 胡歌 | 体育 | 100 |
| 胡歌 | 体育 | 100 |
| 胡歌 | 体育 | 100 |
hdfs dfs -cat /tmp/score_out/* 查看;也可以配合 hdfs dfs -getmerge 合并成一个文件拷回本地。05进阶:事务表里的 UPDATE / DELETE
Hive 默认不支持行级更新,建“事务表”之后才可以。
CREATE TABLE IF NOT EXISTS student_acid(
    stu_id   STRING,
    stu_name STRING,
    sex      STRING
)
CLUSTERED BY (stu_id) INTO 4 BUCKETS
STORED AS ORC
TBLPROPERTIES ('transactional' = 'true');          -- 关键:事务表 + ORC + 分桶

INSERT INTO student_acid SELECT stu_id, stu_name, sex FROM student_info WHERE sex = '女';

UPDATE student_acid SET sex = '女同学' WHERE stu_id = '012';
DELETE FROM student_acid WHERE stu_id = '020';

SELECT * FROM student_acid WHERE stu_id IN ('012','020');验证语句:SELECT stu_id, stu_name, sex FROM student_acid WHERE stu_id IN ('012','020') ORDER BY stu_id
| stu_id | stu_name | sex |
|---|---|---|
| 012 | 杨紫 | 女 |
| 012 | 杨紫 | 女 |
| 020 | 宋丹丹 | 女 |
| 020 | 宋丹丹 | 女 |
transactional=true,还要开 hive.support.concurrency 等参数。06跨系统搬运:Sqoop 导入导出
关系型数据库 ↔ Hive 的批量通道,项目里用它把 MySQL 业务数据搬进 ODS 层。
-- MySQL → Hive(导入)
sqoop import \
  --connect jdbc:mysql://node03:3306/nev --username root --password 123456 \
  --table web_chat_ems_2025_07 \
  --hive-import --hive-database itcast_ods --hive-table web_chat_ems_ods \
  --fields-terminated-by '\t' -m 1

-- Hive → MySQL(导出)
sqoop export \
  --connect jdbc:mysql://node03:3306/nev --username root --password 123456 \
  --table visit_dws --export-dir /user/hive/warehouse/itcast_dws.db/visit_dws \
--input-fields-terminated-by '\t'| 环节 | 说明 |
|---|---|
| --hive-import | 直接建 Hive 表并导入(表名默认同源表) |
| -m 1 | Map 任务数,导小表时设 1 避免生成多个文件 |
| 导出 | 要求 MySQL 端先建好同结构的接收表 |
INSERT … SELECT 配合 JDBC 外表实现。