单元5 Hive数据查询
SELECT 的完整能力:条件、CTE、分组、排序、合并、连接、抽样
本单元学习目标 摘自课件“学习目标/Target”页
- 熟悉SELECT语句,能够描述并列举其语法结构中各关键字和子句的作用。
- 掌握条件查询,能够在查询语句中灵活运用各类运算符设置查询条件。
- 熟悉公共表表达式,能够在查询语句中定义临时结果集并实现多次引用。
- 掌握分组查询,能够熟练运用GROUP BY子句对数据进行分组统计。
- 掌握排序查询,能够熟练运用ORDER BY、SORT BY等子句对数据进行排序展示。
- 了解合并查询,能够使用UNION语句对两张表的数据进行合并。
- 掌握连接查询,能够熟练运用JOIN语句实现内连接、左外连接、右外连接等操作。
- 了解抽样查询,能够使用字节数抽样、行抽样等方式从表中查询部分数据。
单元概述
Hive的数据定义语言和数据操作语言解决了数据的存储与维护问题,使数据能够按照既定模式保存在数据仓库中。但数据仓库的根本目的不仅是存储,更重要的价值在于支持分析与决策。换句话说,数据只有经过高效的查询与分析,才能真正发挥价值。因此,掌握 Hive的数据查询语言(Data Query Language,DQL)是数据仓库应用的核心。本单元将详细介绍Hive数据查询。
知识地图
学完本单元,你应该能回答
- SELECT 语句六个子句的执行顺序与书写顺序为何不同?
- GROUP BY 与 HAVING 的分工是什么?
- ORDER BY / SORT BY / DISTRIBUTE BY / CLUSTER BY 的区别?
- JOIN 的几种类型在 MapReduce 上如何执行?
知识链位置
核心知识 点击标题右侧勾选框可标记“已掌握”,进度会保存在本机浏览器
分析SELECT语句
熟悉SELECT语句,能够描述并列举其语法结构中各关键字和子句的作用。
在Hive的数据查询语言中,最基础且最常用的语句是SELECT。几乎所有查询操作都依赖于它,无论是简单的数据检索,还是复杂的聚合、分组与排序等,SELECT语句都是构建查询的核心。可以说,熟练掌握SELECT语句的语法格式,是学习Hive数据查询语言的起点。
示例命令
关于Hive中SELECT语句的语法格式如下。
[WITH CommonTableExpression (,CommonTableExpression)*]SELECT [ALL | DISTINCT] select_expr,select_expr,...FROM table_reference
[WHERE where_condition]
[GROUP BY group_col_list]
[ORDER BY order_col_list]
[CLUSTER BY cluster_col_list| [DISTRIBUTE BY distribute_col_list] [SORT BY sort_col_list]
]
[LIMIT [offset,] rows];WITH子句为可选,用于定义公共表表达式(Common Table Expression,CTE)。
1.WITH子句
ALL关键字为默认,表示返回查询结果中的所有记录,包括重复值。
2.ALL关键字
DISTINCT关键字为可选,用于对查询结果去重,仅返回唯一的记录组合。
3. DISTINCT关键字
select_expr参数用于指定查询内容,可以是字段、字面量、表达式、函数等。如果查询内容指定为单个*字符,表示查询所有字段。
查询内容可配合AS子句为查询内容指定别名,别名会显示在查询结果中。
4. select_expr参数
当查询内容为复杂数据类型时,可以直接利用Hive提供的复杂类型运算符访问其内部元素。关于Hive中复杂类型运算符的介绍如表。
| 复杂类型运算符 | 描述 | 示例 |
|---|---|---|
| A[n] | A为ARRAY类型的字段,n为元素的下标。该运算符用于返回A的第n个元素 | items[0] |
| M[key] | M为MAP类型的字段,key为键值对的键。该运算符用于返回M中key对应的值 | attrs['sku'] |
| S.x | S为STRUCT类型的字段,x为STRUCT内部的字段。该运算符用于返回S中x的值 | user_info.city |
FROM子句用于指定查询的数据来源。table_reference参数可以是单表、多表、子查询、视图等。需要说明的是,若查询的数据来源为子查询,则子查询需要使用小括号包裹且必须指定别名。在外层查询中,通过“别名.字段”的格式获取子查询结果中相应的字段,示例代码如下。
5. FROM子句
SELECT t.order_id,t.commodity FROM (
SELECT order_id,items[0] AS commodity FROM chapter4.orders) t;
示例代码
WHERE子句为可选,用于设置筛选条件,仅返回满足条件的记录。
6. WHERE 子句
GROUP BY子句为可选,用于根据指定字段的值对查询结果进行分组。
7. GROUP BY 子句
ORDER BY子句为可选,用于根据指定字段的值对查询结果进行全局排序。
8. ORDER BY 子句
CLUSTER BY子句为可选,用于根据指定字段的值将查询结果分发到不同的Reduce,并在每个Reduce内部根据指定字段的值对数据进行排序。CLUSTER BY子句的分发规则与DISTRIBUTE BY子句相同。
在Hive On Tez的语境下,Reduce个数可以理解为经由Shuffle边(Edge)连接的下游Vertex(顶点)的并行Task(任务)个数。
9. CLUSTER BY 子句
DISTRIBUTE BY子句为可选,用于根据指定字段的值将查询结果分发到不同的Task。分发规则是对指定字段的值进行哈希取模运算,哈希取模结果相同的记录会被分配到同一个Task。
关于哈希取模运算的公式如下。
10. DISTRIBUTE BY 子句
hash(col) % task_num
运算公式
表示DISTRIBUTE BY子句中指定的字段
表示Task个数
SORT BY子句为可选,用于在每个Task内部根据指定字段的值对数据进行排序。
11. SORT BY 子句
LIMIT子句为可选,用于限制查询结果返回的行数。当指定该子句时,仅返回查询结果的前N行。rows参数用于指定返回的行数。offset参数为可选,用于指定从查询结果的第offset+1行开始返回指定的行数。
12. LIMIT 子句
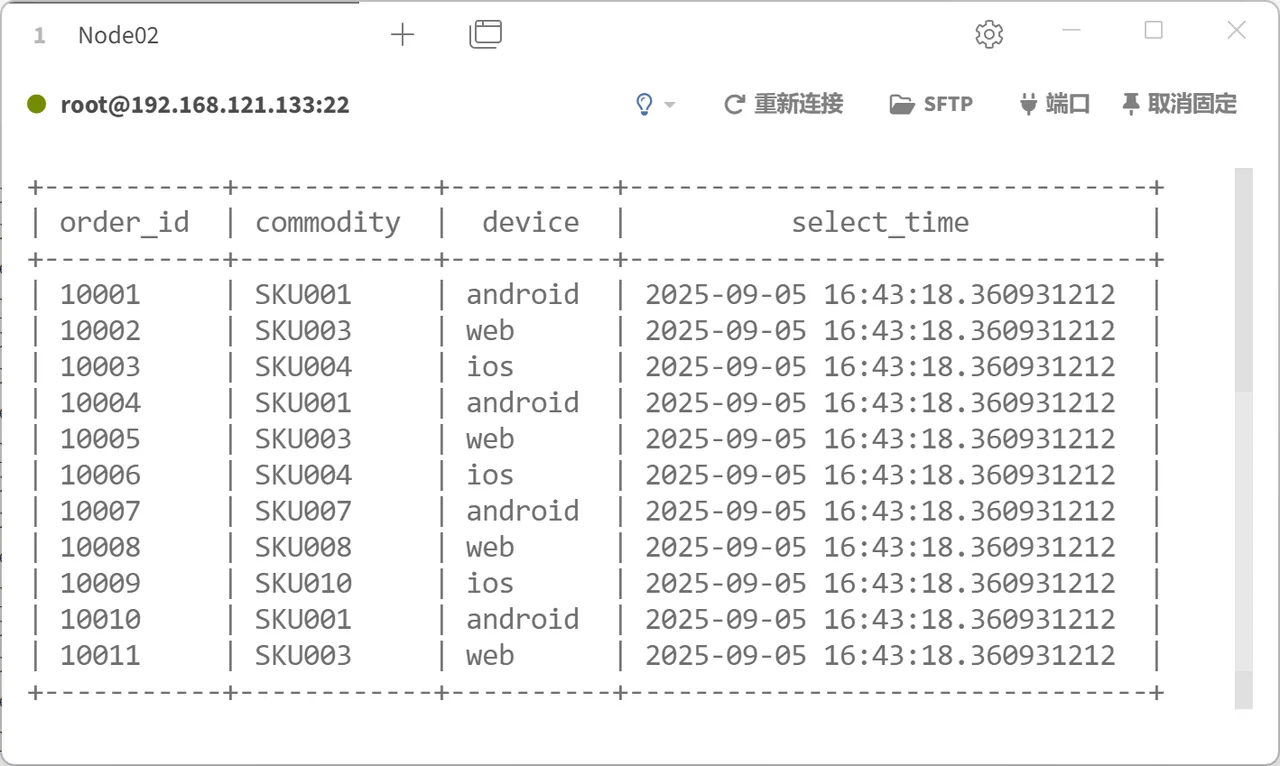
接下来,演示如何使用SELECT语句实现基本查询,从chapter4数据库中的分区表orders查询数据,具体HiveQL语句如下。
SELECT
order_id,
items[0] AS commodity,
user_client.device,
current_timestamp AS select_timeFROM chapter4.orders;HiveQL语句
上述语句执行完成后的效果如图。
任务:执行条件查询
5.2
📄 展开课件原文(第 8–21 页,共 14 页)
执行条件查询
掌握条件查询,能够在查询语句中灵活运用各类运算符设置查询条件。
在上一节中,我们学习了SELECT语句的基本用法,能够根据指定的查询内容从表中提取数据。然而,在实际业务分析中,用户往往更关心满足特定条件的结果。例如,仅查询销售额大于1000元的订单、仅查询某类商品的销售情况、仅查询特定分区的数据等。
如果依旧使用基础的SELECT语句,就需要先返回整个表的数据,再人工筛选所需部分。这不仅效率低下,还会造成资源浪费。
为了解决这一问题,Hive提供了条件查询机制,在SELECT语句中通过WHERE子句设置筛选条件,从而在查询阶段就过滤掉无关数据。这样既能显著提升查询效率,又能让结果更贴合分析需求。
在使用WHERE子句时,筛选条件通常需要借助不同类型的运算符来表达筛选规则,主要包括关系运算符、算术运算符和逻辑运算符,具体介绍如下。
关系运算符
A
算术运算符
B
逻辑运算符
C
在条件查询中,我们常常需要判断数据之间的关系。例如,订单金额是否达到某个阈值、日期是否处于指定区间、字段是否为空等。尽管这些问题的表现形式不同,但本质上都是对值之间关系的判定。为此,Hive提供了一系列关系运算符来表达值之间的关系。
1. 关系运算符
关系运算符广泛应用于WHERE、HAVING、JOIN等子句中,它们直接决定记录是否被选中,是构建任何筛选条件的基础。关于Hive中关系运算符的介绍如表。
| 关系运算符 | 语法 | 操作数类型 | 描述 |
|---|---|---|---|
| = | A = B | 原生数据类型 | 用于判断A和B是否相等。若相等,则返回TRUE;否则返回FALSE。如果A或B为NULL,那么返回NULL,表示未知(UNKNOWN)。例如,product_id = 1001 |
| == | A == B | 原生数据类型 | 与=作用相同 |
| <=> | A <=> B | 原生数据类型 | 与=作用相同。不同之处在于,如果A和B均为NULL,那么返回TRUE。例如,phone <=> NULL |
| 关系运算符 | 语法 | 操作数类型 | 描述 |
|---|---|---|---|
| <> | A <> B | 原生数据类型 | 用于判断A和B是否不相等。若不相等,则返回TRUE;否则返回FALSE。如果A或B为NULL,那么返回NULL。例如,product_id <> 1001 |
| != | A != B | 原生数据类型 | 与<>作用相同 |
| < | A < B | 原生数据类型 | 用于判断A是否小于B。若小于,则返回TRUE;否则返回FALSE。如果A或B为NULL,那么返回NULL。例如,amount < 500 |
| <= | A <= B | 原生数据类型 | 用于判断A是否小于或等于B。若小于或等于,则返回TRUE;否则返回FALSE。如果A或B为NULL,那么返回NULL。例如,amount <= 500 |
| 关系运算符 | 语法 | 操作数类型 | 描述 |
|---|---|---|---|
| > | A > B | 原生数据类型 | 用于判断A是否大于B。若大于,则返回TRUE;否则返回FALSE。如果A或B为NULL,那么返回NULL。例如,amount > 500 |
| >= | A >= B | 原生数据类型 | 用于判断A是否大于或等于B。若大于或等于,则返回TRUE;否则返回FALSE。如果A或B为NULL,那么返回NULL。例如,amount >= 500 |
| IS NULL | A IS NULL | 所有数据类型 | 用于判断A是否为NULL。若A为NULL,则返回TRUE;否则返回FALSE。例如,email IS NULL |
| IS NOT NULL | A IS NOT NULL | 所有数据类型 | 用于判断A是否不为NULL。若A为非NULL,则返回TRUE;否则返回FALSE。例如,email IS NOT NULL |
| 关系运算符 | 语法 | 操作数类型 | 描述 |
|---|---|---|---|
| BETWEEN AND | A BETWEEN B AND C | 原生数据类型 | 用于判断A是否在区间[B,C]内。若在区间内,则返回TRUE;否则返回FALSE。例如,amount BETWEEN 500 AND 1000 |
| NOT BETWEEN AND | A NOT BETWEEN B AND C | 原生数据类型 | 用于判断A是否不在区间[B,C]内。若不在区间内,则返回TRUE;否则返回FALSE。例如,amount NOT BETWEEN 500 AND 1000 |
| IS TRUE | A IS TRUE | BOOLEAN类型 | 用于判断A是否为TRUE。若A为TRUE,则返回TRUE;否则返回FALSE。例如,is_success IS TRUE |
| 关系运算符 | 语法 | 操作数类型 | 描述 |
|---|---|---|---|
| IS FALSE | A IS FALSE | BOOLEAN类型 | 用于判断A是否为FALSE。若A为FALSE,则返回TRUE;否则返回FALSE。例如,is_success IS FALSE |
| IS NOT TRUE | A IS NOT TRUE | BOOLEAN类型 | 用于判断A是否不为TRUE。若A不为TRUE,则返回TRUE;否则返回FALSE。例如,is_success IS NOT TRUE |
| IS NOT FALSE | A IS NOT FALSE | BOOLEAN类型 | 用于判断A是否不为FALSE。若A不为FALSE,则返回TRUE;否则返回FALSE。例如,is_success IS NOT FALSE |
| 关系运算符 | 语法 | 操作数类型 | 描述 |
|---|---|---|---|
| LIKE | A LIKE B | 字符串类型 | 用于判断A与B是否匹配,其中B为包含通配符的模式(Pattern)。若匹配,则返回TRUE,否则返回FALSE。例如,name LIKE 'A%' |
| NOT LIKE | A NOT LIKE B | 字符串类型 | 用于判断A与B是否不匹配。若不匹配,则返回TRUE,否则返回FALSE。例如,name NOT LIKE 'A%' |
| RLIKE | A RLIKE B | 字符串类型 | 用于判断A与B是否匹配,其中B为正则表达式。若匹配,则返回TRUE,否则返回FALSE。例如,name RLIKE '^A.*n$' |
| REGEXP | A REGEXP B | 字符串类型 | 与RLIKE作用相同 |
接下来,演示如何使用关系运算符表中的部分关系运算符进行条件查询,具体内容如下。
为了便于演示其他类型运算符的使用,本任务将在Hive中创建一个名为chapter5的数据库,并在该数据库下创建一个名为sales_fact的分区表。然后,将示例数据加载到分区表sales_fact,具体操作步骤如下。
▸ 课件步骤 01
① 在Hive中创建数据库chapter5,具体HiveQL语句如下。
CREATE DATABASE IF NOT EXISTS chapter5;▸ 课件步骤 01
② 在数据库chapter5中创建分区表sales_fact,具体HiveQL语句如下。
点击查看
▸ 课件步骤 01
③ 在虚拟机Node02中创建/export/data/chapter5目录,并将包含示例数据的文件sales_fact.csv上传到该目录。
▸ 课件步骤 01
④ 在HDFS创建/hive/data/chapter5目录,并将文件sales_fact.csv上传到该目录,在虚拟机Node02执行如下命令。
hdfs dfs -mkdir /hive/data/chapter5
hdfs dfs -put /export/data/chapter5/sales_fact.csv /hive/data/chapter5
创建/hive/data/chapter5目录
将文件sales_fact.csv上传到/hive/data/chapter5目录
HiveQL语句
▸ 课件步骤 01
⑤ 通过文件sales_fact.csv向分区表sales_fact加载数据,具体HiveQL语句如下。
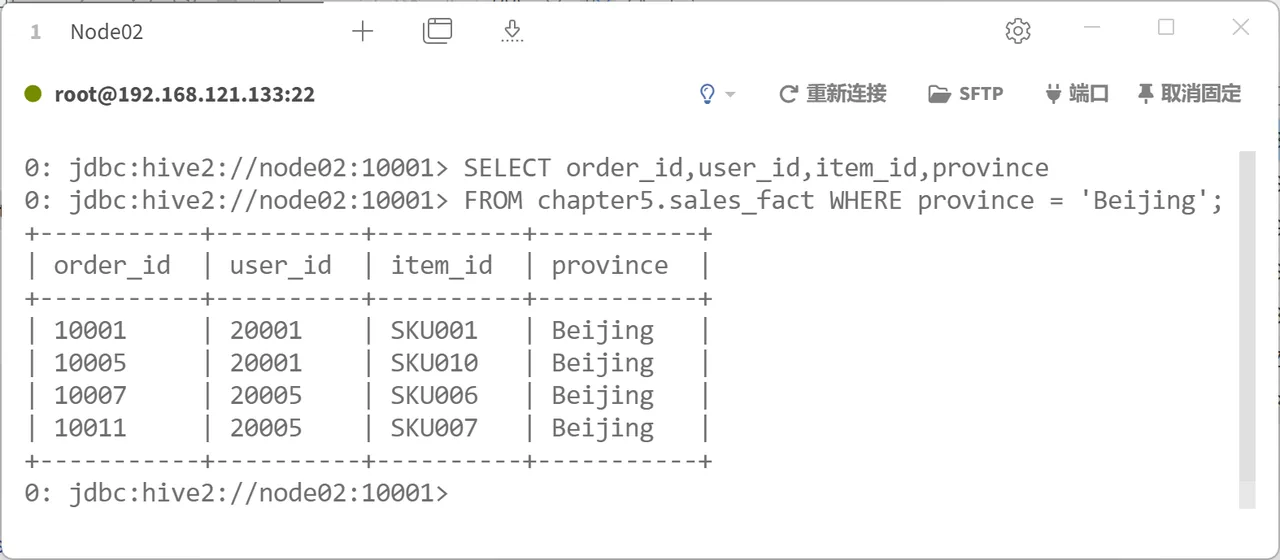
LOAD DATA INPATH '/hive/data/chapter5/sales_fact.csv'OVERWRITE INTO TABLE chapter5.sales_fact;使用关系运算符=筛选出分区表sales_fact中省级行政区为Beijing的订单,返回对应的订单ID、用户ID、商品ID和省级行政区,具体HiveQL语句如下。
▸ 课件步骤 02
SELECT order_id,user_id,item_id,province
FROM chapter5.sales_fact WHERE province = 'Beijing';
上述语句执行完成后的效果如图。
▸ 课件步骤 02
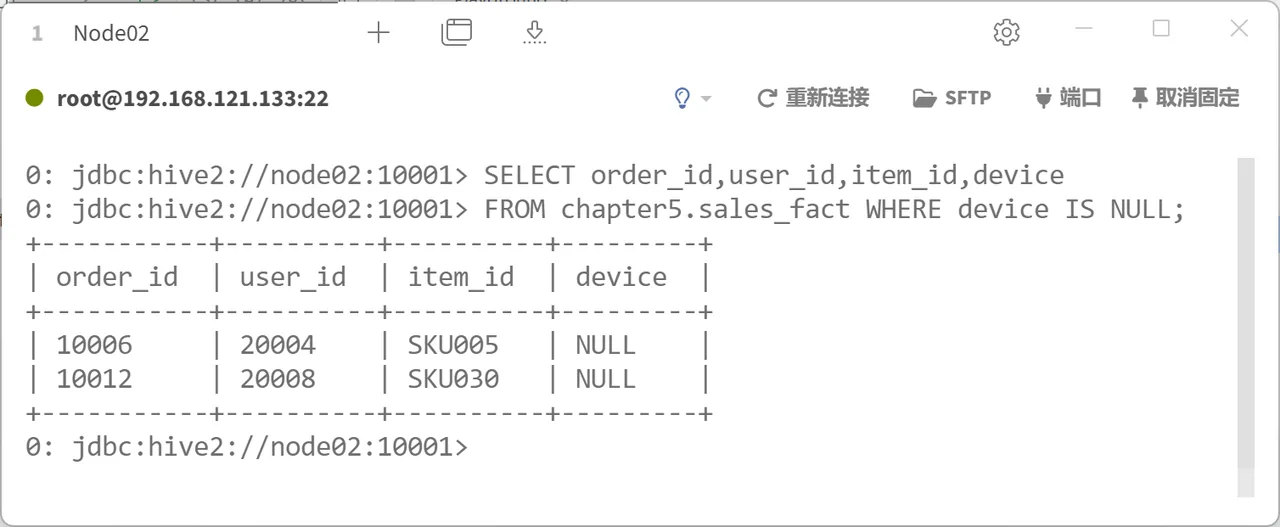
使用关系运算符IS NULL筛选出分区表sales_fact中设备为NULL的订单,返回对应的订单ID、用户ID、商品ID和设备,具体HiveQL语句如下。
▸ 课件步骤 03
SELECT order_id,user_id,item_id,device
FROM chapter5.sales_fact WHERE device IS NULL;
▸ 课件步骤 03
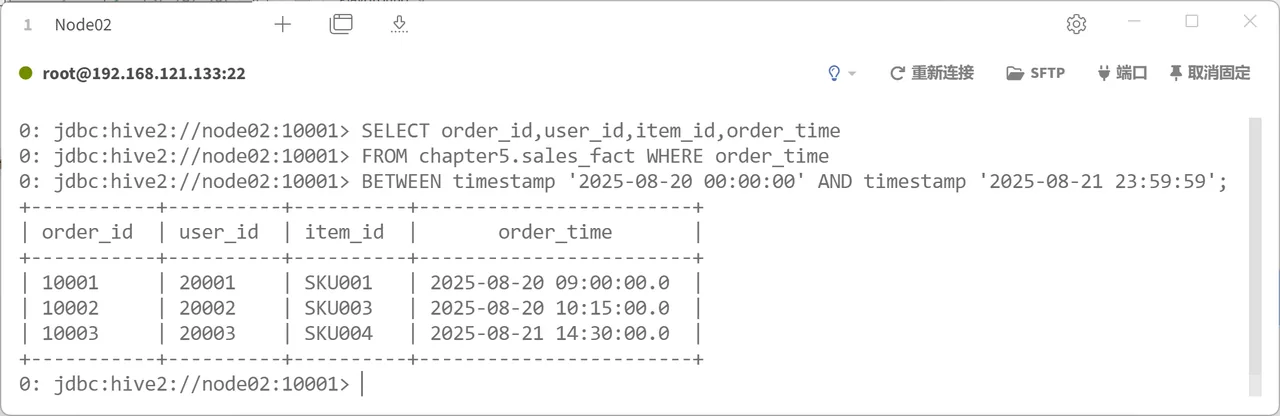
使用关系运算符BETWEEN AND筛选出分区表sales_fact中下单时间在2025-08-20 00:00:00和2025-08-21 23:59:59范围内的订单,返回对应的订单ID、用户ID、商品ID和下单时间,具体HiveQL语句如下。
▸ 课件步骤 04
SELECT order_id,user_id,item_id,order_timeFROM chapter5.sales_fact WHERE order_time
BETWEEN timestamp '2025-08-20 00:00:00' AND timestamp '2025-08-21 23:59:59';▸ 课件步骤 04
在查询过程中,有时不仅需要筛选特定记录,还需要按照业务规则直接进行数值计算。例如,根据商品的单价和销售数量计算成交额,或根据商品的标价与实付金额计算折扣率。为此,Hive提供了一系列算术运算符,可在查询中直接执行数值运算。
2. 算术运算符
算术运算符既可以出现在查询内容的表达式中,也可以出现在WHERE、GROUP BY或ORDER BY等子句的表达式中,为后续的关系判断和聚合汇总提供基础支持。
关于Hive中算术运算符的介绍如表。
| 算术运算符 | 语法 | 操作数类型 | 描述 |
|---|---|---|---|
| + | A + B | 数值类型 | 对A和B进行相加运算。例如,salary + 500 |
| - | A - B | 数值类型 | 对A和B进行相减运算。例如,price - discount |
| * | A * B | 数值类型 | 对A和B进行相乘运算。例如,quantity * unit_price |
| / | A / B | 数值类型 | 对A和B进行相除运算,结果通常为DOUBLE类型。例如,total_sales / total_orders |
| 算术运算符 | 语法 | 操作数类型 | 描述 |
|---|---|---|---|
| DIV | A DIV B | 整数类型 | 对A和B进行相除运算,结果为整数(向零取整)。例如,total_points DIV 10 |
| % | A % B | 数值类型 | 对A和B进行取余运算。例如,order_id % 2 |
| & | A & B | 数值类型 | 对A和B的二进制位进行逐位逻辑与运算。例如,user_flags & 1 |
| ^ | A ^ B | 数值类型 | 对A和B的二进制位进行逐位逻辑异或运算。例如,permission_code ^ 4 |
| ~ | ~A | 数值类型 | 对A的二进制位进行逐位取反运算。例如,~error_code |
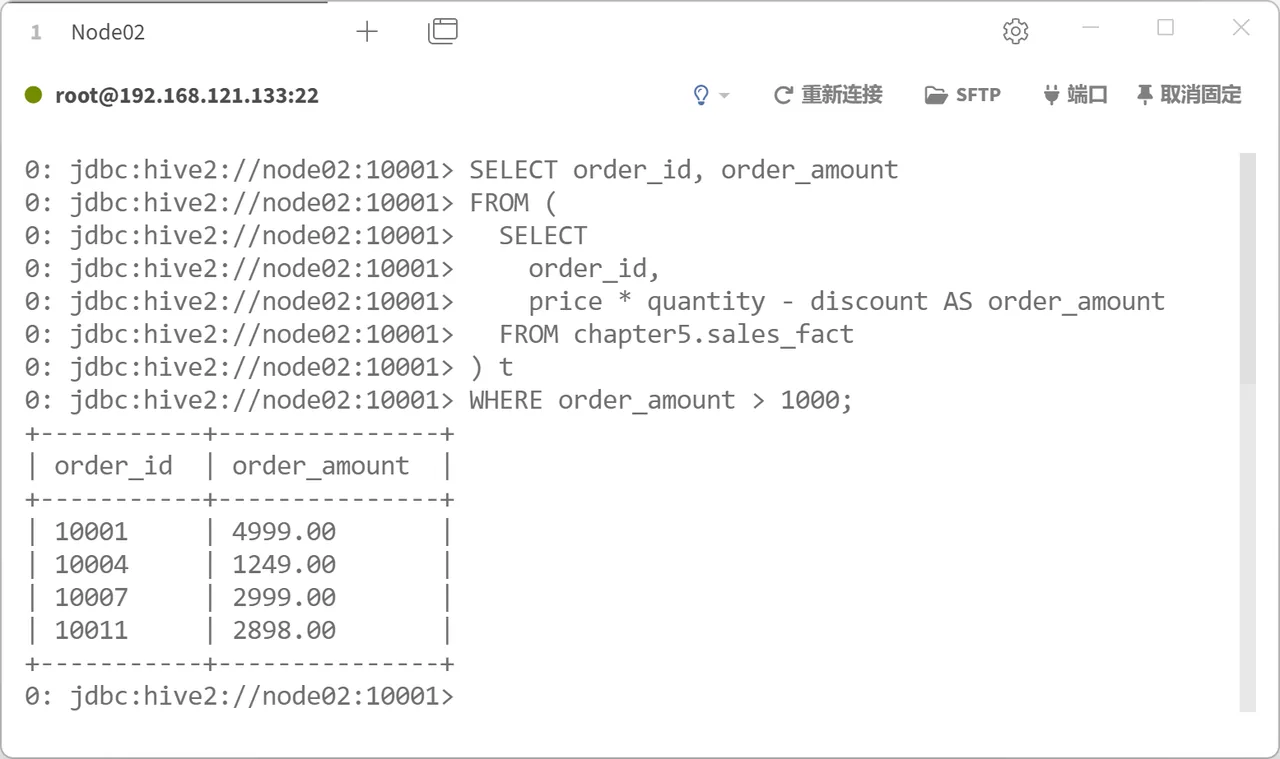
接下来,演示如何使用算术运算符表中的部分算术运算符进行条件查询。本案例利用算术运算符*和-计算分区表sales_fact中每个订单的金额,并筛选出金额大于1000的订单,返回对应的订单ID和订单金额,具体HiveQL语句如下。
SELECT order_id, order_amount
FROM (
SELECT
order_id,
price * quantity - discount AS order_amount
FROM chapter5.sales_fact
) t
WHERE order_amount > 1000;
在条件查询中,单一的筛选条件往往难以表达复杂的业务规则。实际应用场景中,常常需要对多个筛选条件进行组合,或者在条件中引入集合判断。例如,筛选出既满足特定金额要求,又符合指定日期范围的订单;筛选出商品类别属于电子产品、服装或图书的订单。这类需求仅依靠简单的关系运算符无法实现。为此,Hive提供了一系列逻辑运算符,用于支持更复杂的条件表达。
3. 逻辑运算符
关于Hive中逻辑运算符的介绍如表。
| 逻辑运算符 | 语法 | 操作数类型 | 描述 |
|---|---|---|---|
| AND | A AND B | BOOLEAN类型 | 若A和B均为TRUE,则返回TRUE;若任意一个操作数为FALSE,则返回FALSE。当任意一个操作数为NULL且另一个操作数不为FALSE时,返回NULL |
| OR | A OR B | BOOLEAN类型 | 若A和B均为FALSE,则返回FALSE;若任意一个操作数为TRUE,则返回TRUE。当任意一个操作数为NULL且另一个操作数不为TRUE时,返回NULL |
| NOT | NOT A | BOOLEAN类型 | 若A为TRUE,则返回FALSE;若A为FALSE,则返回TRUE。当A为NULL时,返回NULL |
| 逻辑运算符 | 语法 | 操作数类型 | 描述 |
|---|---|---|---|
| ! | ! A | BOOLEAN类型 | 与NOT的作用相同 |
| IN | A IN (val,val,…) | 原生数据类型 | 小括号中的内容可以是常量列表,也可以是返回单字段标量值的子查询。若A存在于列表或子查询结果中,则返回TRUE;若不存在,则返回FALSE。当列表或子查询的结果中包含NULL且A不存在时,返回NULL |
| 逻辑运算符 | 语法 | 操作数类型 | 描述 |
|---|---|---|---|
| NOT IN | A NOT IN (val,val,…) | 原生数据类型 | 若A不存在于列表或子查询结果中,则返回TRUE;若存在,则返回FALSE。当列表或子查询的结果中包含NULL且A不存在时,返回NULL |
| EXISTS | EXISTS (subquery) | — | 判断子查询是否返回结果。若子查询返回至少一条记录,则返回TRUE;否则返回FALSE |
| NOT EXISTS | NOT EXISTS (subquery) | — | 判断子查询是否不返回结果。若子查询无记录返回,则返回TRUE;否则返回FALSE |
接下来,演示如何使用算术运算符表中的部分逻辑运算符进行条件查询,具体内容如下。
▸ 课件步骤 01
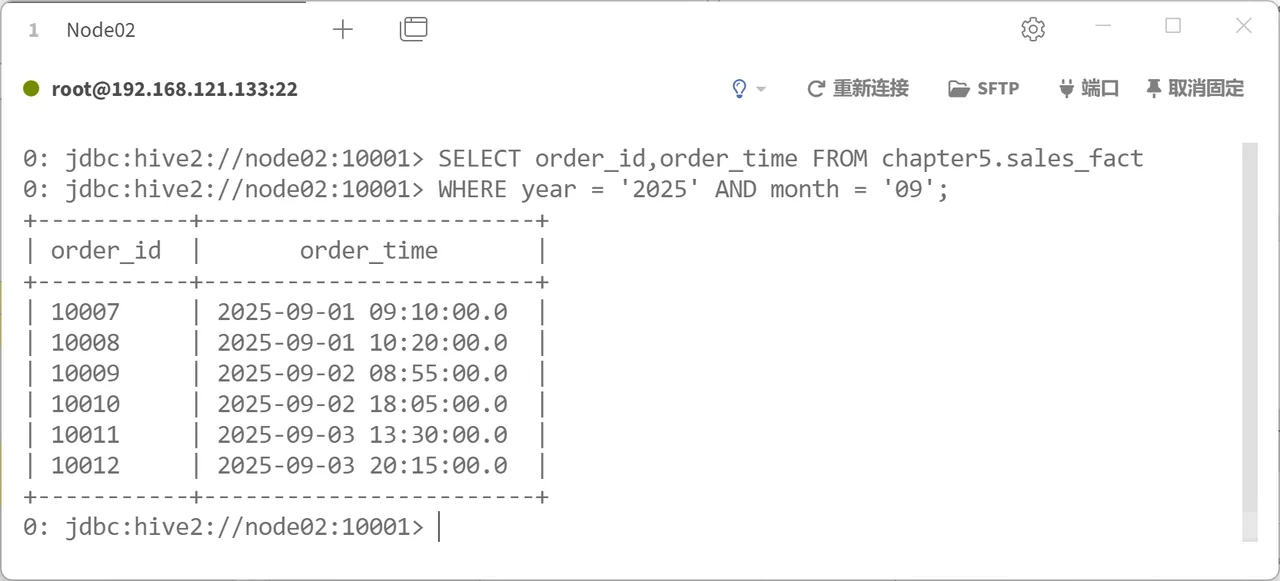
使用逻辑运算符AND筛选出分区表sales_fact中分区year=2025/month=09的数据,即筛选出2025年9月的订单,返回对应的订单ID和下单时间,具体HiveQL语句如下。
SELECT order_id,order_time FROM chapter5.sales_factWHERE year = '2025' AND month = '09';▸ 课件步骤 01
▸ 课件步骤 02
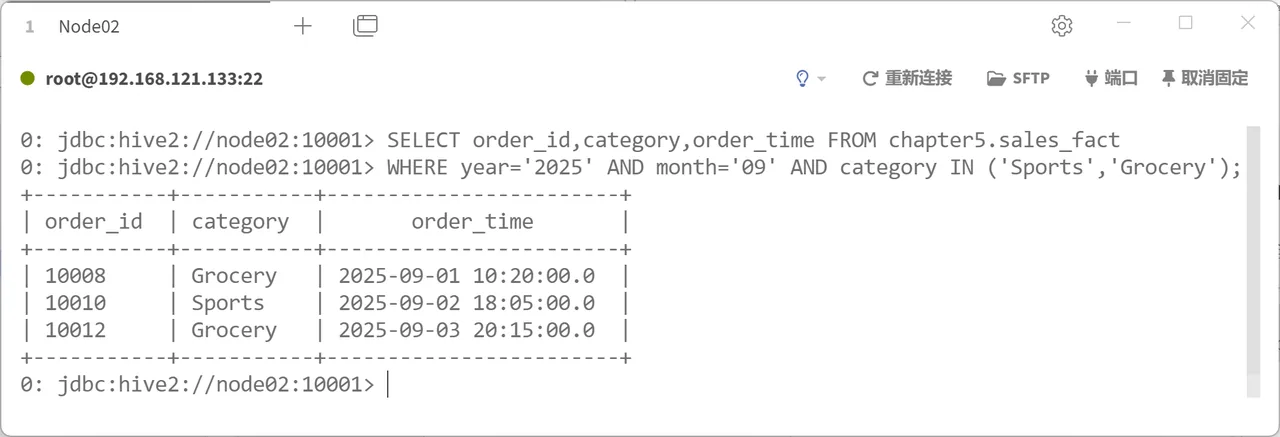
使用逻辑运算符AND筛选出分区表sales_fact中2025年9月且商品类型为Sports和Grocery的订单,返回对应的订单ID、商品类型和下单时间,具体HiveQL语句如下。
SELECT order_id,category,order_time FROM chapter5.sales_factWHERE year='2025' AND month='09' AND category IN ('Sports','Grocery');▸ 课件步骤 02
任务:执行公共表表达式查询
5.3
📷 展开本知识点其余 2 张课件截图
条件查询的六种常用写法一屏看完。
SELECT * FROM score_info
WHERE score >= 60                       -- 比较
  AND course_id IN ('01','02')          -- 集合
  AND score BETWEEN 60 AND 100          -- 区间
  AND stu_id LIKE '0%'                  -- 模糊
  AND stu_id IS NOT NULL                -- 空值判断
ORDER BY score DESC LIMIT 5;
💡 IS NULL 不能写成 = NULL;LIKE 的通配符是 %(任意多字符)和 _(一个字符)。
📄 展开课件原文(第 22–59 页,共 38 页)
执行公共表表达式查询
熟悉公共表表达式,能够在查询语句中定义临时结果集并实现多次引用。
公共表表达式允许用户在查询开始时定义一个或多个临时结果集,这些结果集只在当前查询中有效,并且可以被后续的SELECT语句多次引用。简单来说,公共表表达式的作用就像给复杂子查询起了一个名字,使SELECT语句更简洁、易读,同时提高了代码的复用性。
在Hive中,公共表表达式通过SELECT语句中的WITH子句实现,其语法格式如下。
HiveQL语句
WITH cte_name AS (select_statement)[,cte_name AS (select_statement),…]用于指定公共表表达式的唯一标识
用于定义公共表表达式的临时结果集
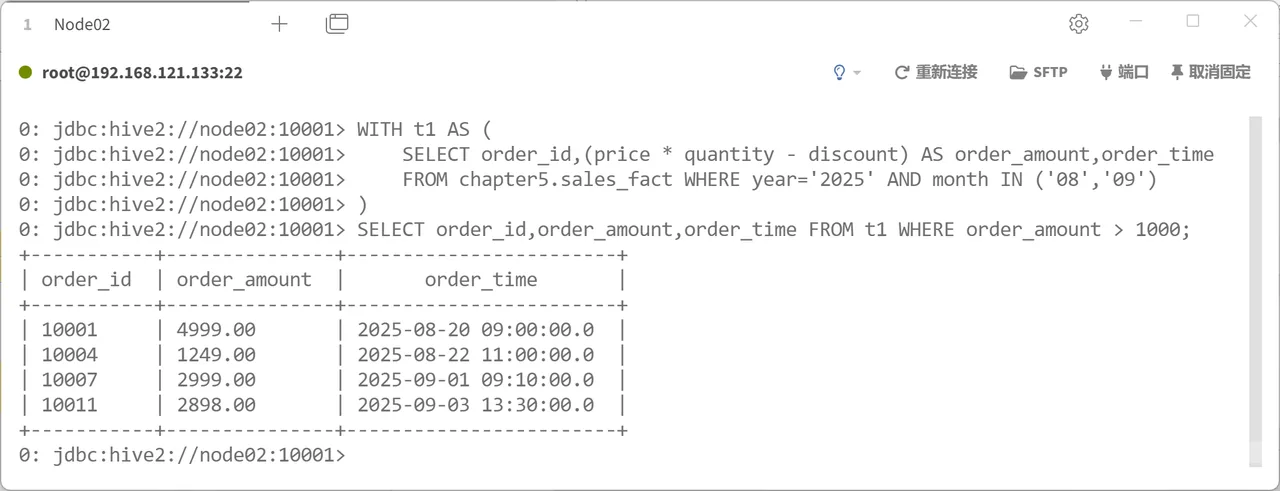
接下来,演示如何使用公共表表达式,在数据库chapter5的分区表sales_fact中筛选出2025年8月和9月订单金额大于1000的订单,返回对应的订单ID和订单金额,具体HiveQL语句如下。
WITH t1 AS (
SELECT order_id,(price * quantity - discount) AS order_amount,order_time
FROM chapter5.sales_fact WHERE year='2025' AND month IN ('08','09')
)
SELECT order_id,order_amount,order_time FROM t1 WHERE order_amount > 1000;上述语句执行完成后的效果如图。
任务:执行分组查询
5.4
📄 展开课件原文(第 60–65 页,共 6 页)
执行分组查询
掌握分组查询,能够熟练运用GROUP BY子句对数据进行分组统计。
在实际的数据分析中,关注点往往不仅限于单条记录,而是更侧重于一组数据的整体特征。例如,可以统计每个商品的总销售额、各地区的订单数量或每个班级的平均成绩。这些问题具有一个共同点,就是查询对象不再是单行数据,而是需要按照某个字段的值对数据进行分组,并在组内执行聚合运算。
为此,Hive在SELECT语句中提供了GROUP BY子句来实现分组查询。通过分组查询,可以将数据划分为若干组,并对每组数据执行相应的操作。通常情况下,GROUP BY子句会与聚合函数结合使用,以计算每个分组的统计结果。不过,在某些场景下也可以单独使用GROUP BY子句,例如对指定字段进行去重。
关于GROUP BY子句的语法格式如下。
HiveQL语句
GROUP BY group_col_list用于指定分组字段
需要注意的是,在SELECT语句中使用GROUP BY子句时,查询内容只能包含分组字段或聚合函数。
接下来,基于数据库chapter5中的分区表sales_fact,演示如何使用GROUP BY子句实现分组查询,具体内容如下。
▸ 课件步骤 01
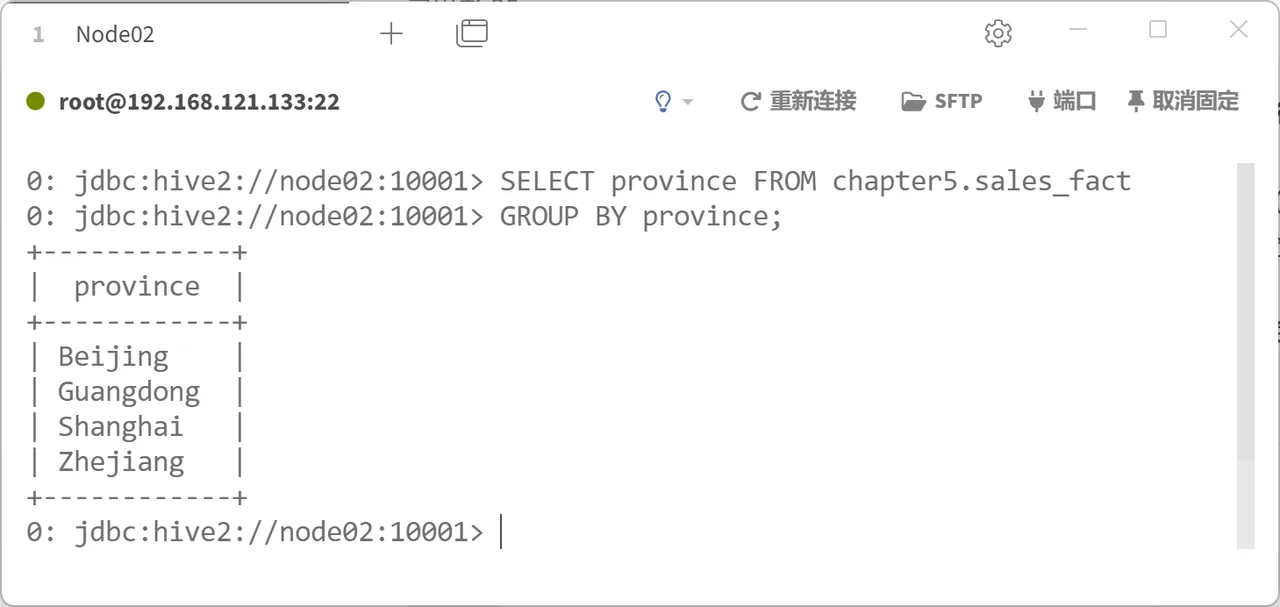
通过GROUP BY子句对分区表sales_fact中的字段province进行去重,具体HiveQL语句如下。
SELECT province FROM chapter5.sales_fact
GROUP BY province;
▸ 课件步骤 01
上述语句执行完成后的效果如图。
▸ 课件步骤 02
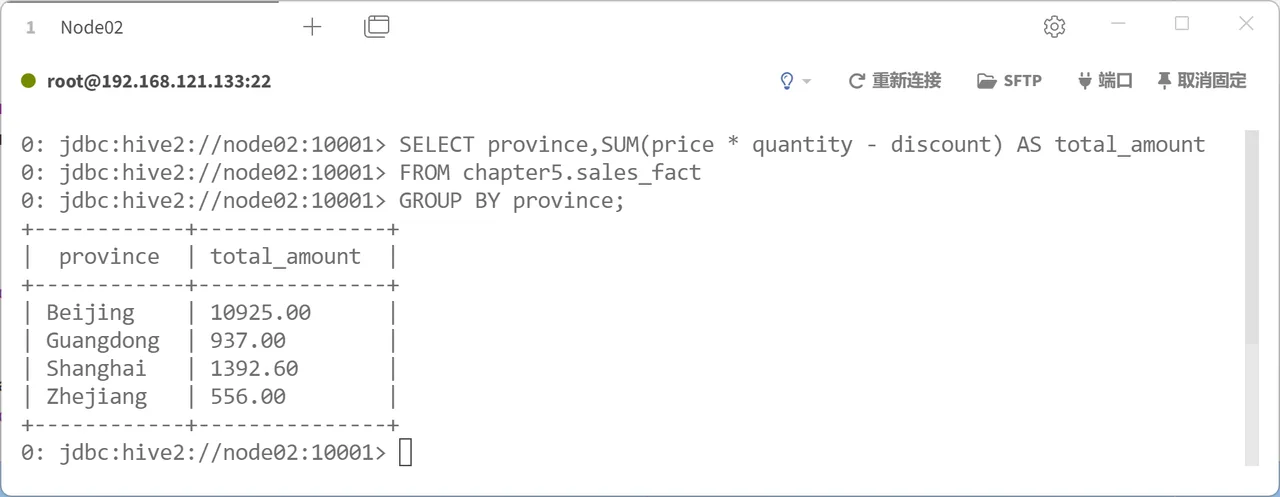
将GROUP BY子句与聚合函数SUM()结合使用,计算分区表sales_fact中每个省级行政区的订单金额,具体HiveQL语句如下。
SELECT province,SUM(price * quantity - discount) AS total_amountFROM chapter5.sales_fact▸ 课件步骤 02
HAVING子句
在Hive的分组查询中,通常使用GROUP BY子句将数据按照某个字段的值划分为不同分组,并结合聚合函数计算各分组的统计指标。然而,在实际分析中,我们往往并不需要所有分组的结果,而是只关心那些满足特定条件的分组。
例如,只想查看销售额大于10000元的商品类型、只想统计订单数超过100的用户等。在这种情况下,仅依靠WHERE子句是无法实现的。原因在于,WHERE子句在分组前对单行数据进行过滤,而上述需求是基于分组聚合后的结果进行过滤,因此必须使用HAVING子句。
HAVING子句用于在GROUP BY子句完成分组查询后,对分组结果进行条件过滤。它通常与聚合函数配合使用,用于筛选满足条件的分组。
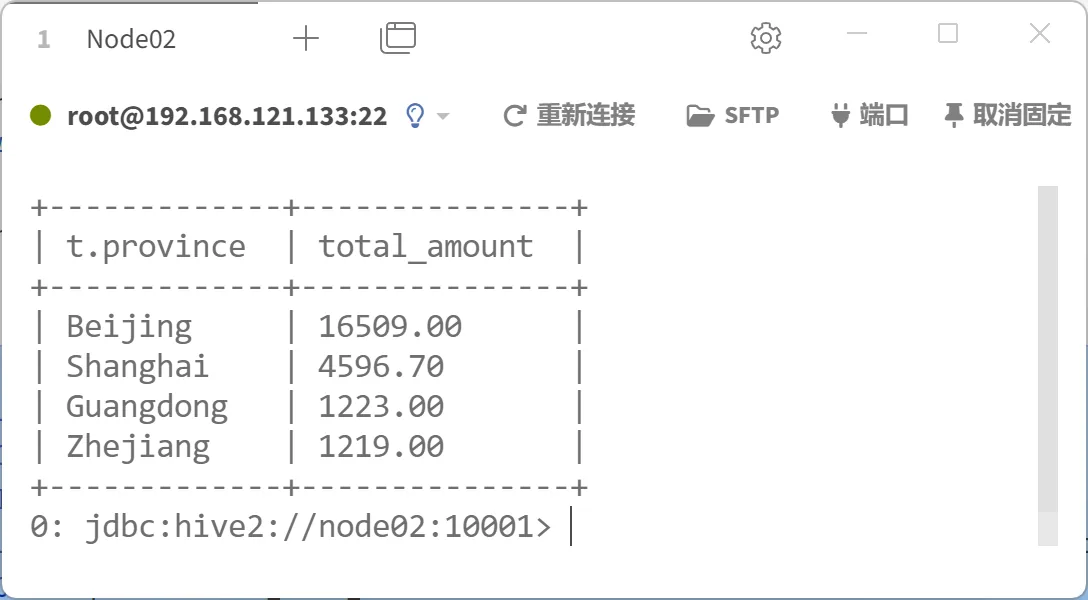
例如,计算分区表sales_fact中每个省级行政区的订单金额,并筛选订单金额大于1000的省级行政区,具体HiveQL语句如下。
WITH t1 AS (
SELECT province,(price * quantity - discount ) AS order_amount
)
SELECT province, SUM(order_amount) AS total_amount
FROM t1 GROUP BY province HAVING SUM(order_amount) >1000;
任务:执行排序查询
5.5
分组统计 + 分组后过滤的组合写法。
SELECT course_id,
       count(*) AS 人数,
       round(avg(score), 2) AS 平均分
FROM score_info
GROUP BY course_id
HAVING count(*) > 5 AND avg(score) > 60
ORDER BY 平均分 DESC;
💡 HAVING 里可以用聚合函数,WHERE 里不行——这是二者最本质的区别。
📄 展开课件原文(第 66–77 页,共 12 页)
执行排序查询
掌握排序查询,能够熟练运用ORDER BY、SORT BY等子句对数据进行排序展示。
在日常数据分析中,结果的呈现顺序往往与数据本身同等重要。一个无序的结果集虽然包含所需信息,但在阅读和使用时缺乏直观性;而经过合理排序的结果集,不仅更易于理解,还能帮助分析者快速发现规律与重点。例如,在商品分析中,排序能帮助我们快速找到销量最高或最低的商品。
Hive在SELECT语句中提供了多种子句用于实现排序查询,从而能够灵活适应不同的应用场景,具体介绍如下。
ORDER BY子句
A
SORT BY子句
B
CLUSTER BY子句
C
ORDER BY子句用于对查询结果进行全局排序。由于全局排序只能由一个Task完成,因此容易成为性能瓶颈。基于ORDER BY子句实现的排序查询,通常适用于小规模数据集或必须严格保证全局顺序的场景。
1. ORDER BY子句
关于ORDER BY子句的语法格式如下。
HiveQL语句
ORDER BY col [ASC|DESC][,col [ASC|DESC],...]用于指定排序字段
用于指定排序规则为升序
用于指定排序规则为降序
需要注意的是,ORDER BY子句实现的是全局排序,当面对大规模数据时,可能会对集群性能造成严重影响
接下来,基于数据库chapter5中的分区表sales_fact,演示如何使用ORDER BY子句实现排序查询,具体内容如下。
▸ 课件步骤 01
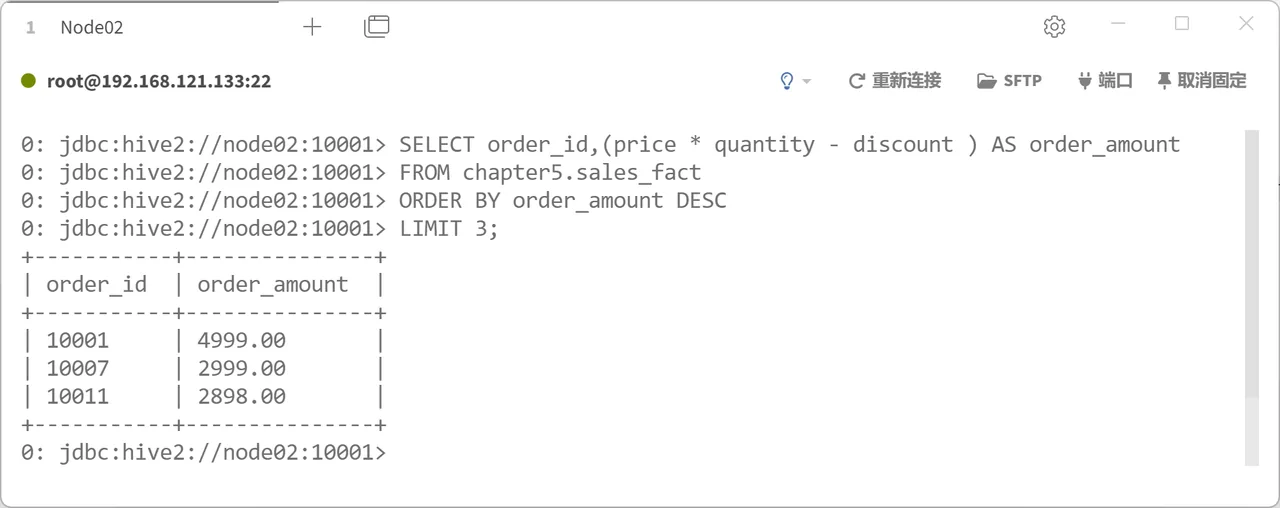
使用ORDER BY子句对分区表sales_fact中的订单按照订单金额降序排序,并结合LIMIT子句获取排名前3的订单,返回对应的订单ID和订单金额,具体HiveQL语句如下。
SELECT order_id,(price * quantity - discount ) AS order_amountFROM chapter5.sales_fact
ORDER BY order_amount DESC
LIMIT 3;▸ 课件步骤 01
上述语句执行完成后的效果如图。
▸ 课件步骤 02
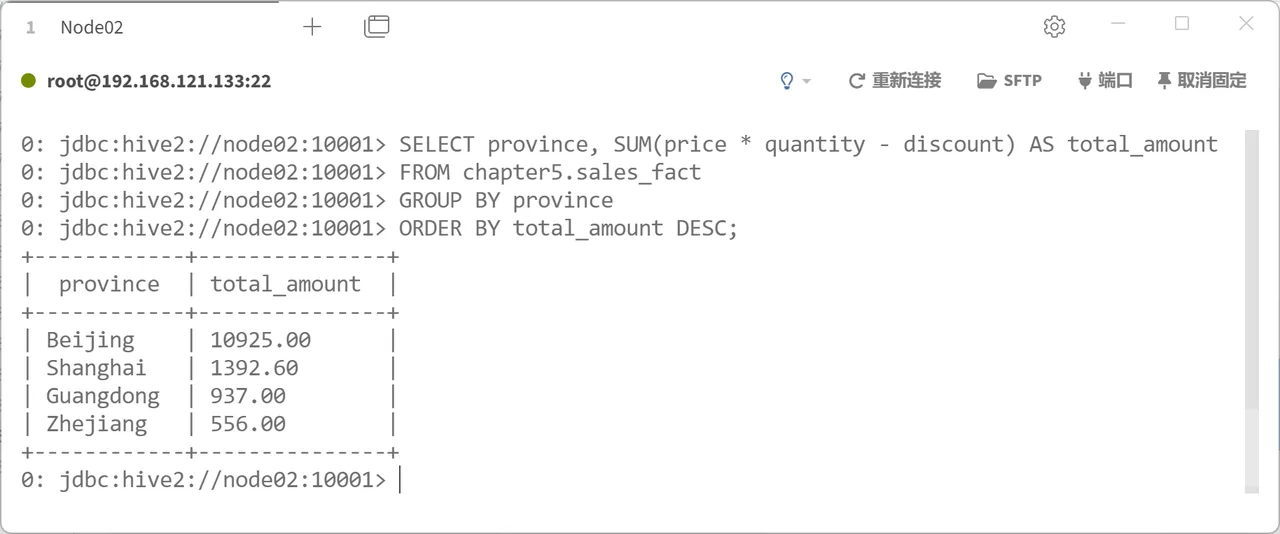
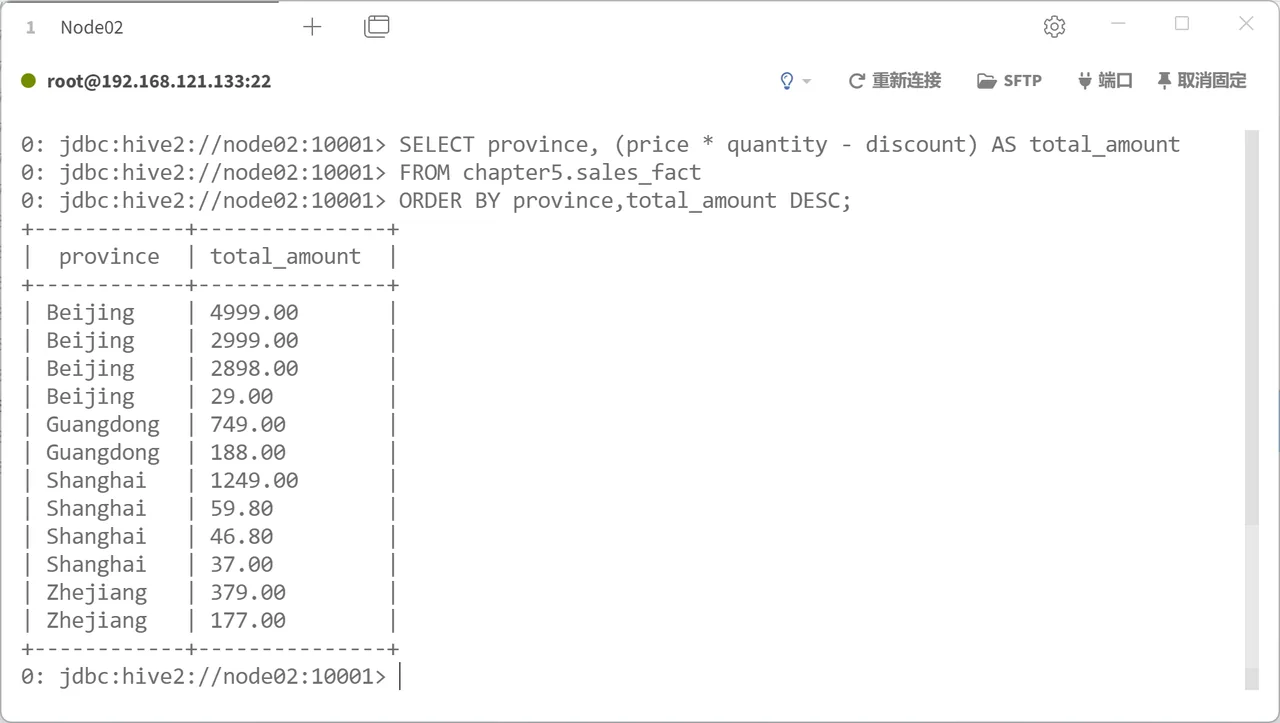
使用ORDER BY子句和GROUP BY子句实现分组排序查询,计算分区表sales_fact中每个省级行政区的订单金额,并按照订单金额降序排序,具体HiveQL语句如下。
SELECT province, SUM(price * quantity - discount) AS total_amountGROUP BY province
ORDER BY total_amount DESC;▸ 课件步骤 02
▸ 课件步骤 03
使用ORDER BY子句对分区表sales_fact中的订单先按照省级行政区升序排序,再在每个省级行政区内按照订单金额降序排序,具体HiveQL语句如下。
SELECT province, (price * quantity - discount) AS total_amount,order_idORDER BY province,total_amount DESC;▸ 课件步骤 03
SORT BY子句用于对查询结果进行局部排序,即根据Task的数量将数据划分并分发到不同的任务中,在各任务内部分别完成排序,从而保证每个任务内的数据有序,但不保证整体查询结果有序。
2. SORT BY子句
由于SORT BY子句可以通过多个并行任务执行排序操作,所以在处理大规模数据时能够以分布式方式提升执行效率,相比ORDER BY子句性能更高。不过,当Task的数量为1时,例如数据量较小。SORT BY子句与ORDER BY子句的效果相同,都会对查询结果进行全局排序。
在Hive中,SORT BY子句可以与DISTRIBUTE BY子句联合使用。这样不仅能够保证根据指定字段值进行哈希取模后结果相同的记录被分配到同一个Task,还可以在每个Task内部再按照指定字段的值进行排序。
关于SORT BY子句的语法格式如下。
语法格式
SORT BY col [ASC|DESC][,col [ASC|DESC],...]接下来,基于数据库chapter5中的分区表sales_fact,演示如何使用SORT BY子句实现排序查询,具体内容如下。
▸ 课件步骤 01
由于分区表sales_fact的数据量较小,而Hive默认将每个Task需要处理的数据量估算为256000000字节(即256MB),所以在使用SORT BY子句进行排序查询时,实际上只会启动一个Task,其最终效果与ORDER BY子句相同。
为演示并行执行的效果,这里在当前会话中临时修改参数,将Hive估算的每个Task目标处理数据量调整为64字节,从而强制通过多个并行Task执行SORT BY子句实现的排序查询,具体HiveQL语句如下。
SET hive.exec.reducers.bytes.per.reducer=64;用于控制Hive估算每个Task预计处理的数据量
▸ 课件步骤 02
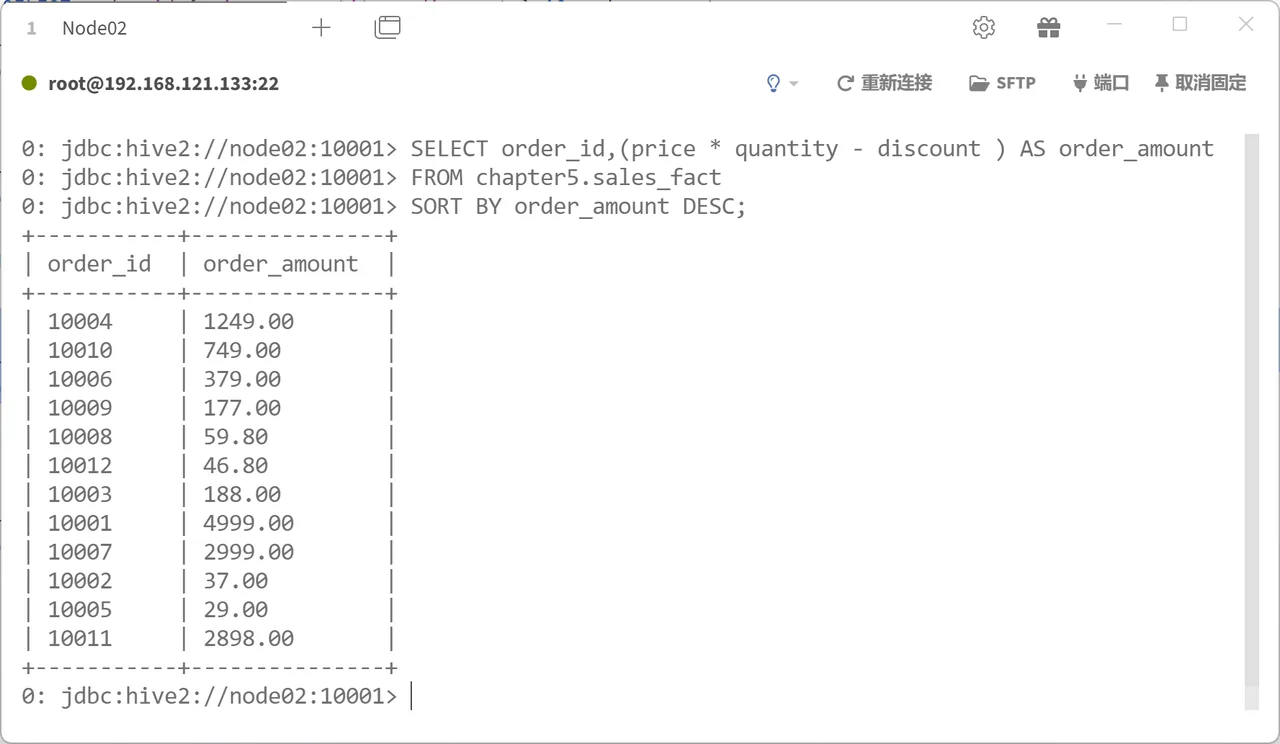
使用SORT BY子句对分区表sales_fact中的订单按照订单金额降序排序,返回对应的订单ID和订单金额,具体HiveQL语句如下。
SORT BY order_amount DESC;▸ 课件步骤 02
▸ 课件步骤 03
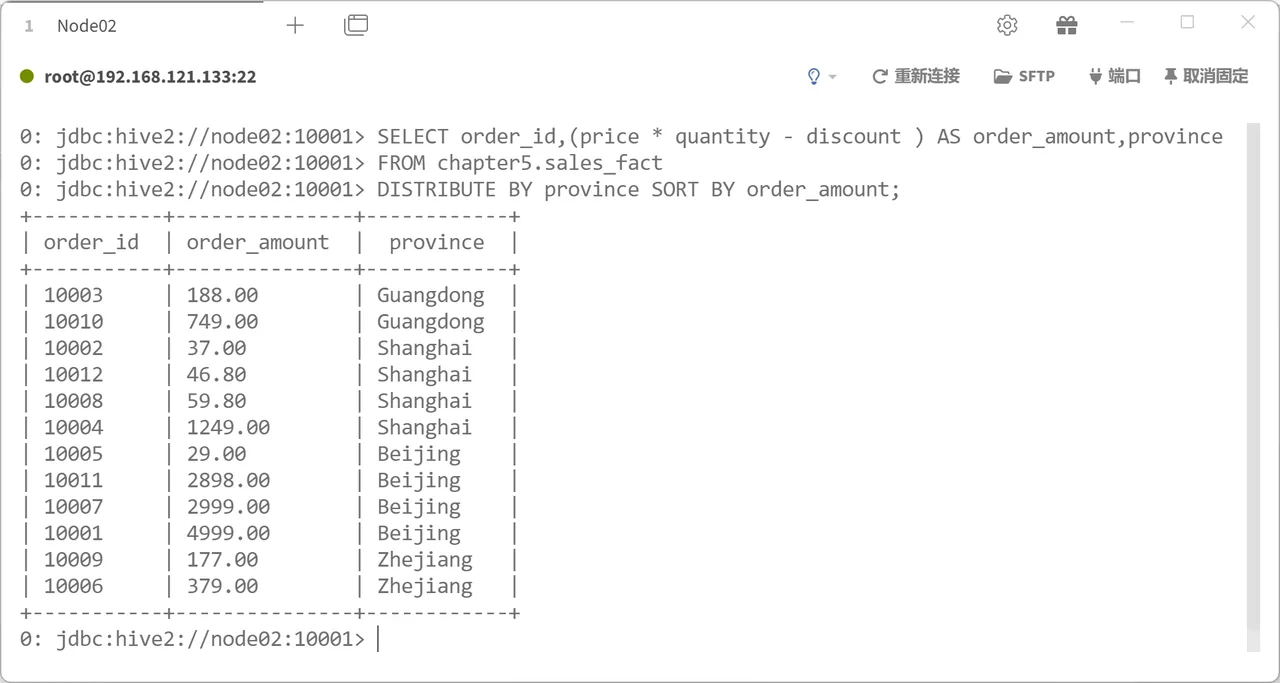
使用DISTRIBUTE BY子句和SORT BY子句实现排序查询,将省级行政区哈希取模结果相同的记录分发到同一个Task,并在每个Task内部按照订单金额升序排序,具体HiveQL语句如下。
SELECT order_id,(price * quantity - discount ) AS order_amount,provinceDISTRIBUTE BY province SORT BY order_amount;▸ 课件步骤 03
▸ 课件步骤 03
CLUSTER BY子句等价于DISTRIBUTE BY子句和SORT BY子句联合使用,且二者指定字段相同的效果。但需要注意,CLUSTER BY子句不支持显式指定排序规则,始终采用默认的升序排序。
3. CLUSTER BY子句
任务:执行合并查询
5.6
📷 展开本知识点其余 1 张课件截图
四种排序方式的区别与选择。
SELECT * FROM score_info ORDER BY score DESC LIMIT 10;        -- 全局有序,1 个 Reduce
SELECT * FROM score_info SORT BY score DESC;                  -- 每个 Reduce 内部有序
SELECT * FROM score_info DISTRIBUTE BY course_id SORT BY score DESC;  -- 按课程分发+组内排序
SELECT * FROM score_info CLUSTER BY course_id;                -- 上面两个同列时的简写
💡 数据量大时优先 SORT BY / DISTRIBUTE BY,ORDER BY 只在结果集小的时候用。
📄 展开课件原文(第 78–101 页,共 24 页)
执行合并查询
了解合并查询,能够使用UNION语句对两张表的数据进行合并。
在实际数据分析中,经常需要将来自不同查询的结果合并,以便统一展示。例如,企业可能将线上订单和线下订单分别存储在不同的表中,而财务部门往往希望同时查看线上与线下的销售汇总。如果仅依次执行各个查询,就只能得到零散的结果,难以实现整体分析。此时,就需要一种机制能够将多个查询结果纵向拼接,从而生成一个完整的结果集。
为此,Hive提供了UNION语句来实现合并查询。借助合并查询,可以在一条HiveQL语句中整合来自多个数据源或不同查询条件的结果。此外,UNION语句可以作为SELECT语句的子句,从而对合并查询的结果进一步分析。
关于UNION语句的语法格式如下。
语法格式
select_statement
UNION ALL | DISTINCT select_statement
[UNION ALL | DISTINCT select_statement
...]
用于指定查询语句
用于在合并两侧的结果集时,去除重复行
接下来,演示如何使用UNION语句实现合并查询,具体内容如下。
▸ 课件步骤 01
为便于后续演示如何整合来自多个数据源的查询结果,在数据库chapter5中创建一个与分区表sales_fact结构相同的分区表sales_fact_new,具体HiveQL语句如下。
CREATE TABLE IF NOT EXISTS chapter5.sales_fact_newLIKE chapter5.sales_fact;▸ 课件步骤 02
使用INSERT语句向分区表sales_fact_new插入示例数据,具体HiveQL语句如下。
点击查看
▸ 课件步骤 03
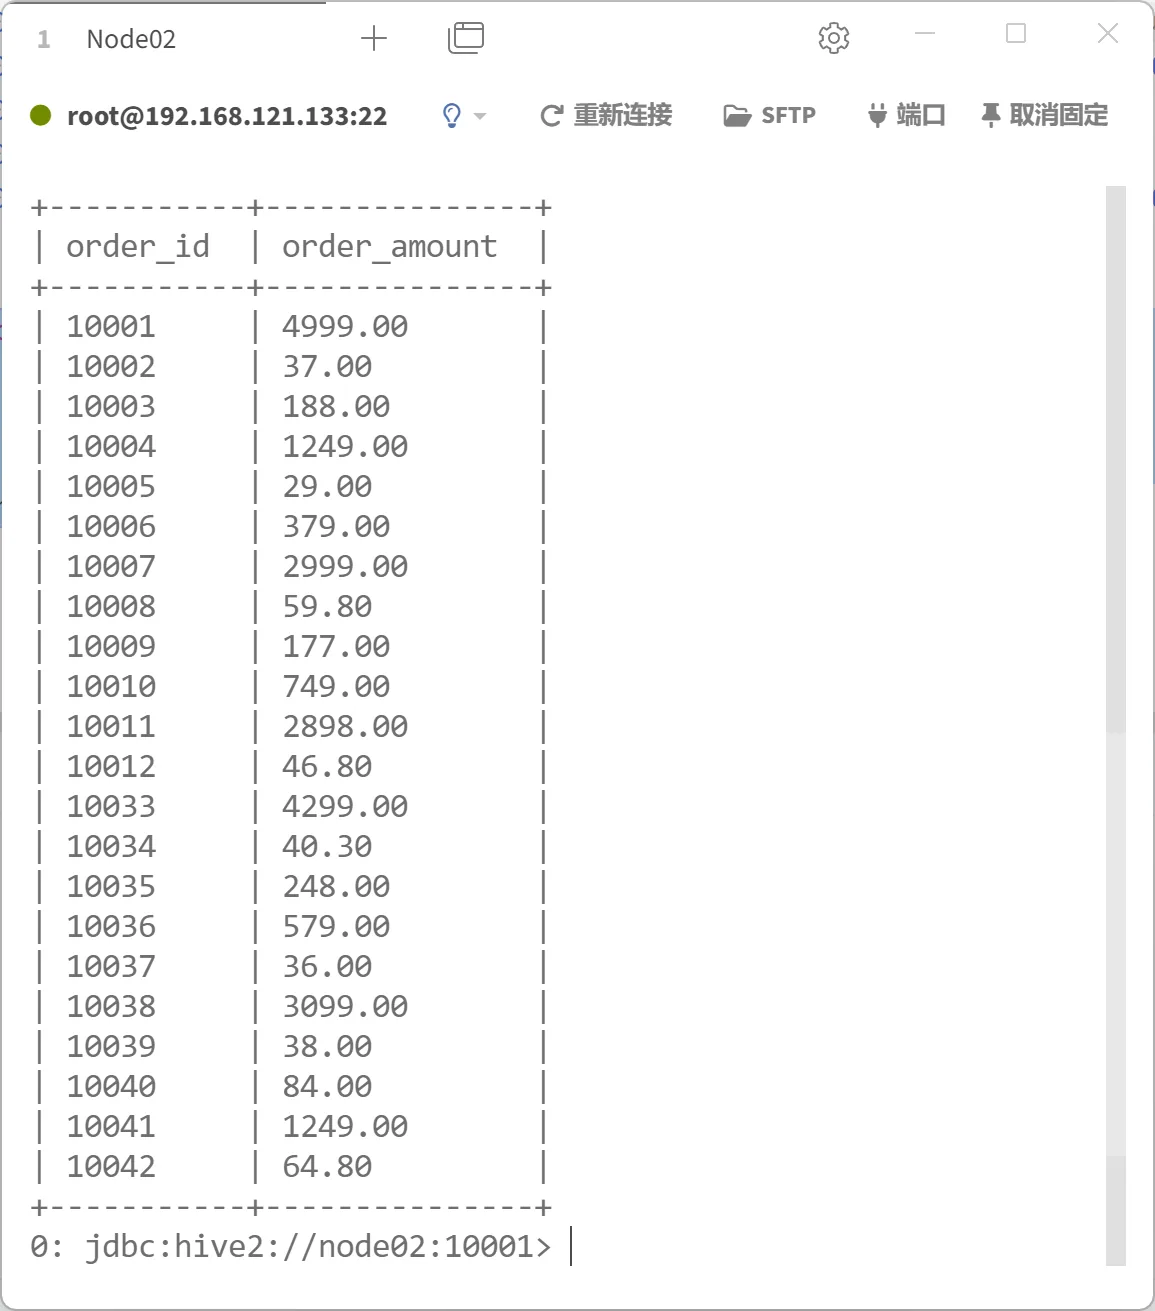
分别计算分区表sales_fact_new和sales_fact中每个订单的订单金额,返回对应的订单ID和订单金额,并通过UNION语句将两个查询结果合并为一个统一的结果集,具体HiveQL语句如下。
SELECT order_id,(price * quantity - discount ) AS order_amountFROM chapter5.sales_fact
UNION ALLFROM chapter5.sales_fact_new;▸ 课件步骤 03
上述语句执行完成后的效果如图。
▸ 课件步骤 04
分别计算分区表sales_fact_new和sales_fact中每个订单的订单金额,返回对应的省份和订单金额,并通过UNION语句将两个查询结果合并为一个统一的结果集。在此基础上进一步实现分组排序查询,计算每个省级行政区的订单金额,并按照订单金额降序排序,具体HiveQL语句如下。
▸ 课件步骤 04
任务:执行连接查询
5.7
📄 展开课件原文(第 102–113 页,共 12 页)
执行连接查询
掌握连接查询,能够熟练运用JOIN语句实现内连接、左外连接、右外连接等操作。
在实际的数据仓库应用中,为了满足数据规范化存储和高效管理的需求,企业往往会将数据拆分到多张表中。例如,用户的基本信息存储在用户表,交易记录存储在订单表,商品的详细资料存储在商品表。
在这种场景下,当需要进行综合分析时,单表查询往往难以满足需求。例如,若要查询某个用户的订单详情,就必须将用户表与订单表进行关联;若要统计不同商品类别的销售额,就需要将订单表与商品表进行关联。
这类需求要求我们能够在一条查询语句中将两张表的数据进行关联。为此,Hive提供了JOIN语句来实现连接查询。借助连接查询,可以按照一个或多个公共字段将不同表的数据关联,从而在查询结果中得到完整的信息。所谓公共字段,是指两张表中含义相同且能够作为关联条件的字段。例如,在用户表与订单表的连接查询中,可以使用两张表的用户ID作为公共字段,从而将用户信息与其对应的订单记录关联起来。
Hive支持多种连接方式,包括内连接、左外连接、右外连接、全外连接、左半连接与笛卡尔积连接,在复杂查询中,可以根据业务需求组合使用不同连接方式,但应注意连接顺序和结果语义。在介绍不同连接方式时,通常将参与关联的两张表称为左表和右表,这一称谓来源于JOIN语句的书写顺序,其中位于JOIN关键字左侧的表被称为左表,而位于右侧的表则被称为右表。
关于Hive中不同连接方式的介绍如下。
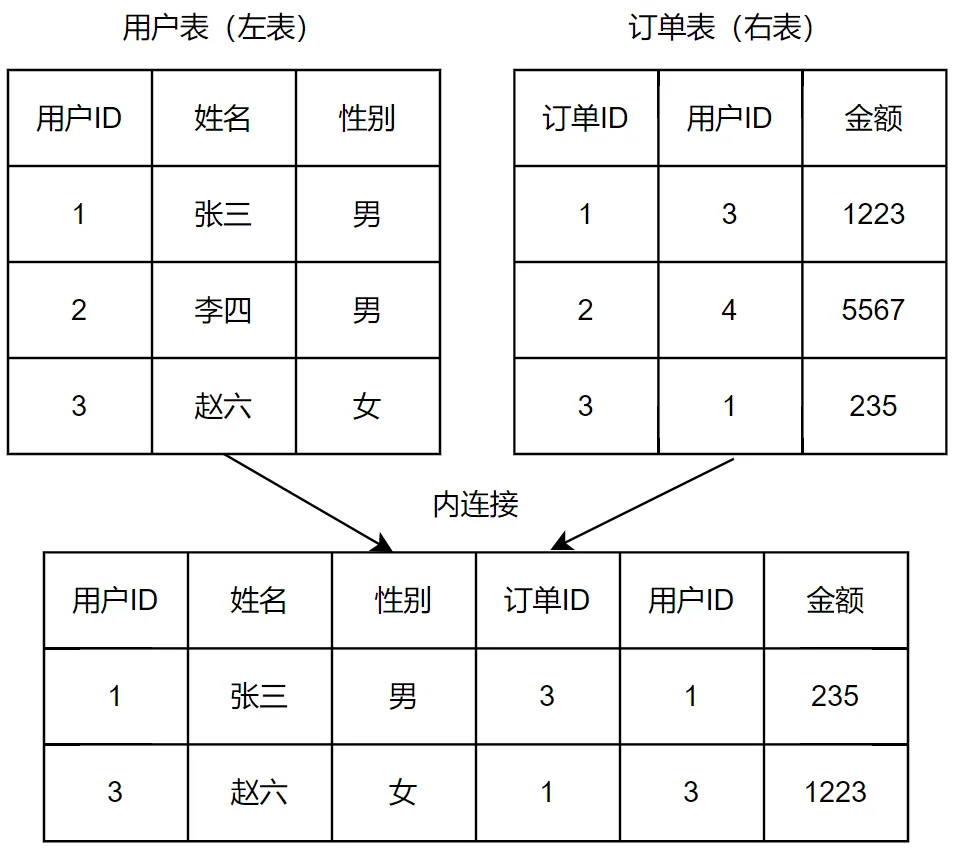
内连接只返回两张表中满足连接条件的记录。所谓连接条件,是指两表在公共字段上的取值是否满足预设规则,最常见的情况是等值匹配。当两张表中的记录满足连接条件时,Hive会将两条记录的字段拼接在一起生成一条新记录。
1. 内连接
例如,用户表和订单表根据公共字段用户ID执行内连接的效果如图。
在Hive中内连接的语法格式如下。
SELECT select_expr,select_expr,... FROM[db_name.]table_name1
[INNER] JOIN [db_name.]table_name2 ON expression
[[INNER] JOIN [db_name.]table_name3 ON expression...]
用于指定从结果集中提取的内容
用于指定连接条件
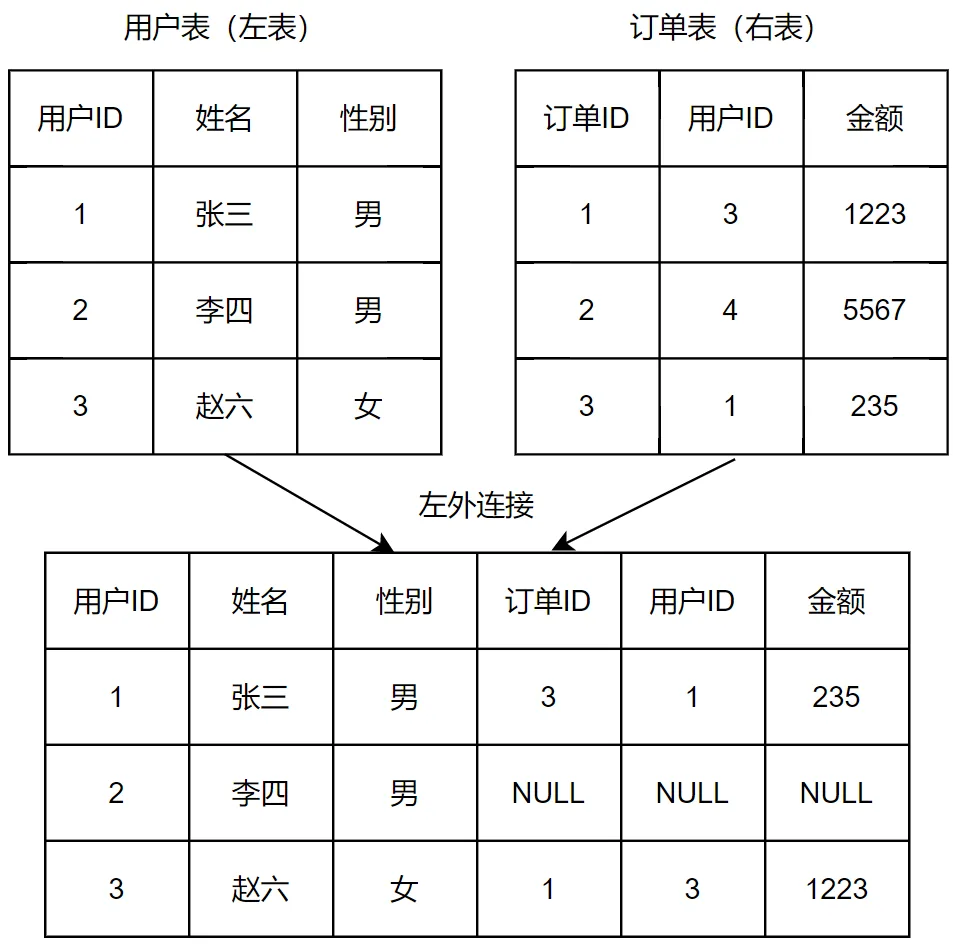
左外连接会返回左表中的所有记录。若两张表中的记录满足连接条件,则将它们的字段拼接生成一条新记录;若左表中的某条记录在右表中没有匹配到满足连接条件的记录,该记录仍会保留,并与右表中字段以NULL填充后的记录拼接生成一条新记录。
2. 左外连接
例如,用户表和订单表根据公共字段用户ID执行左外连接的效果如图。
在Hive中左外连接的语法格式如下。
LEFT [OUTER] JOIN [db_name.]table_name2 ON expression
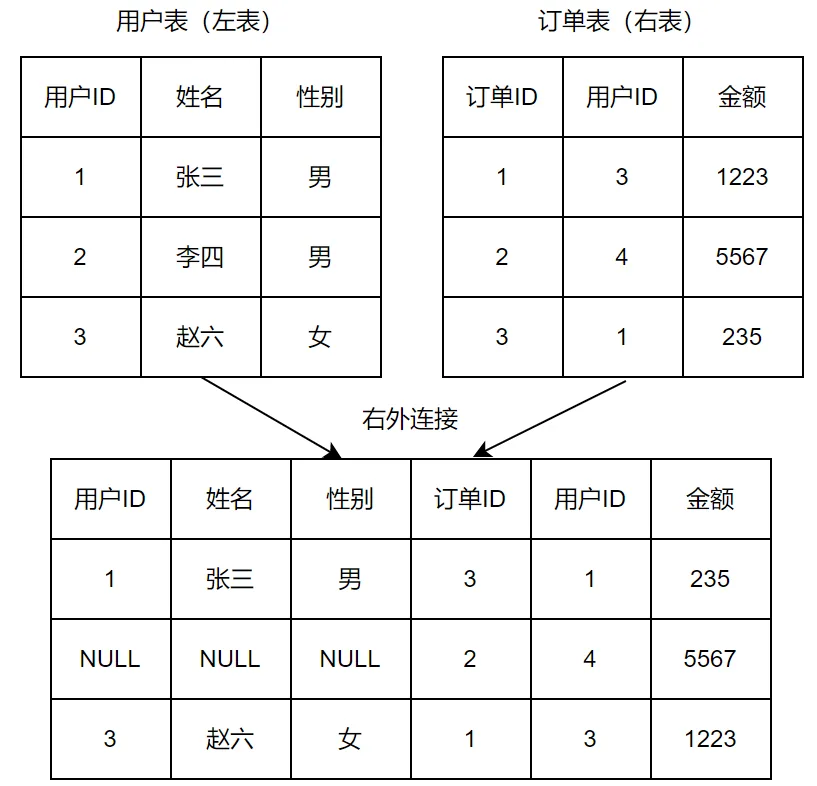
[LEFT [OUTER] JOIN [db_name.]table_name3 ON expression右外连接会返回右表中的所有记录。若两张表中的记录满足连接条件,则将它们的字段拼接生成一条新记录;若右表中的某条记录在左表中没有匹配到满足连接条件的记录,该记录仍会保留,并与左表中字段以NULL填充后的记录拼接生成一条新记录。
3. 右外连接
例如,用户表和订单表根据公共字段用户ID执行右外连接的效果如图。
在Hive中右外连接的语法格式如下。
RIGHT [OUTER] JOIN [db_name.]table_name2 ON expression
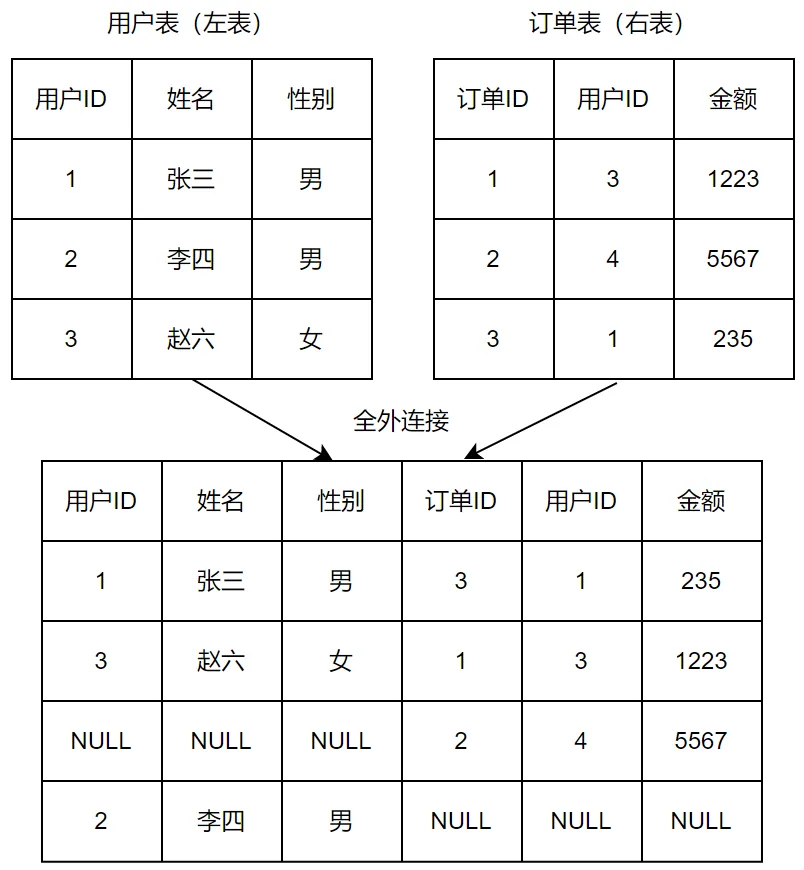
[RIGHT [OUTER] JOIN [db_name.]table_name3 ON expression全外连接会返回两张表中的所有记录。若两张表中的记录满足连接条件,则将它们的字段拼接生成一条新记录;若左表中的某条记录在右表中没有匹配到满足连接条件的记录,该记录仍会保留,并与右表中字段以NULL填充后的记录拼接生成一条新记录;同样地,若右表中的某条记录在左表中没有匹配到满足连接条件的记录,该记录也会保留,并与左表中字段以NULL填充后的记录拼接生成一条新记录。
4. 全外连接
例如,用户表和订单表根据公共字段用户ID执行全外连接的效果如图。
在Hive中全外连接的语法格式如下。
FULL [OUTER] JOIN [db_name.]table_name2 ON expression
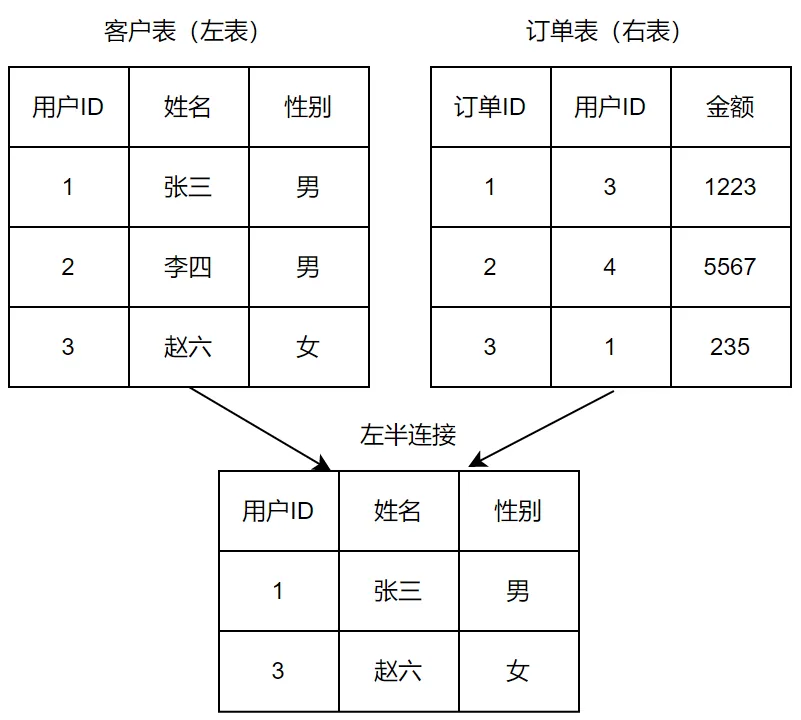
[FULL [OUTER] JOIN [db_name.]table_name3 ON expression左半连接只返回左表中满足连接条件的记录。若左表中的某条记录在右表中没有匹配到满足连接条件的记录,则该记录会被丢弃。
5. 左半连接
例如,用户表和订单表根据公共字段用户ID执行左半连接的效果如图。
在Hive中左半连接的语法格式如下。
LEFT SEMI JOIN [db_name.]table_name2 ON expression
[LEFT SEMI JOIN [db_name.]table_name3 ON expression
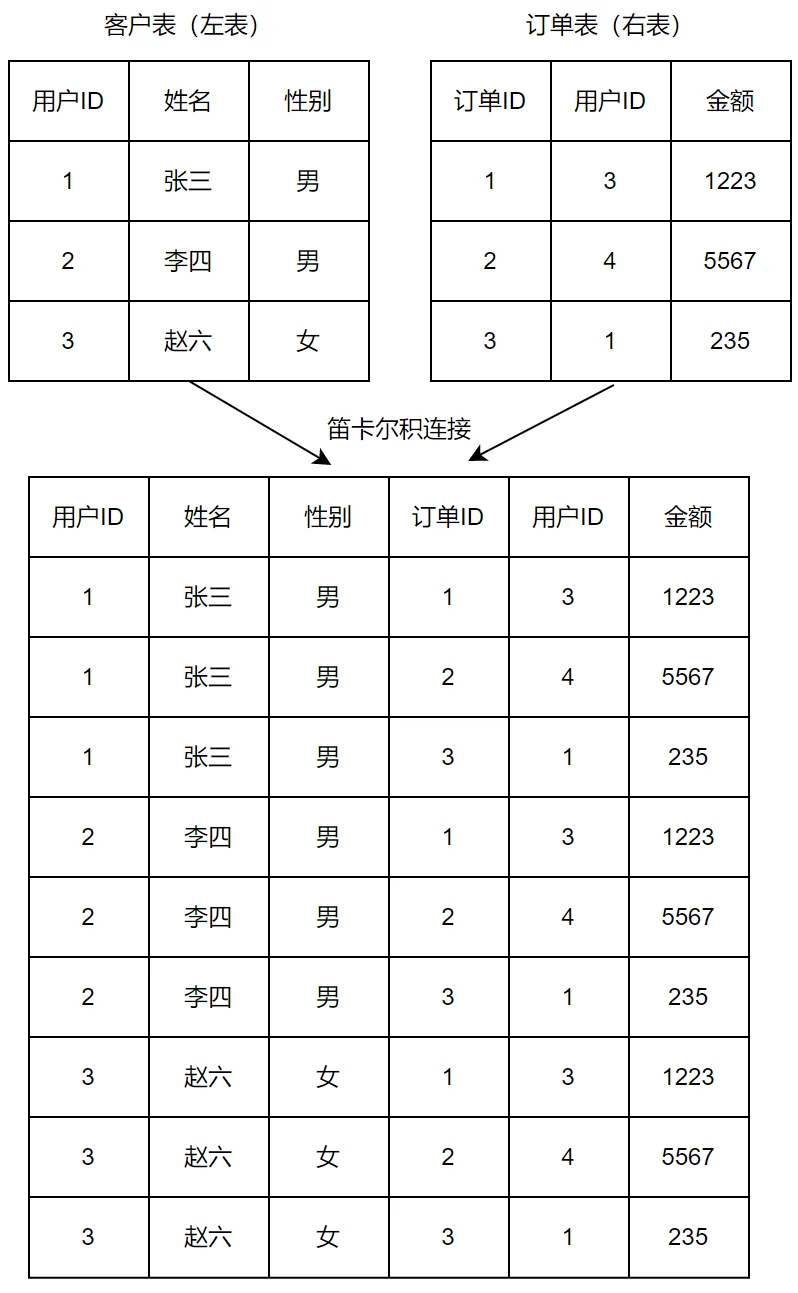
笛卡尔积连接没有连接条件。Hive会将左表中的每一条记录与右表中的每一条记录进行组合,并将它们的字段拼接在一起,生成一条新记录。结果集的总行数等于左表行数乘以右表行数,这种全组合的结果往往会非常庞大,因此通常只在测试或特殊分析中使用。
6. 笛卡尔积连接
例如,用户表和订单表执行笛卡尔积连接的效果如图。
在Hive中笛卡尔积连接的语法格式如下。
CROSS JOIN [db_name.]table_name2
[CROSS JOIN [db_name.]table_name3
接下来,演示如何使用JOIN语句实现连接查询,具体内容如下。
▸ 课件步骤 01
为便于演示连接查询,在数据库chapter5中创建一个存储用户信息的表users,该表包含用户的基本信息,用于与存储订单信息的分区表sales_fact进行关联,具体HiveQL语句如下。
点击查看
▸ 课件步骤 02
使用INSERT语句向表users插入示例数据,具体HiveQL语句如下。
▸ 课件步骤 03
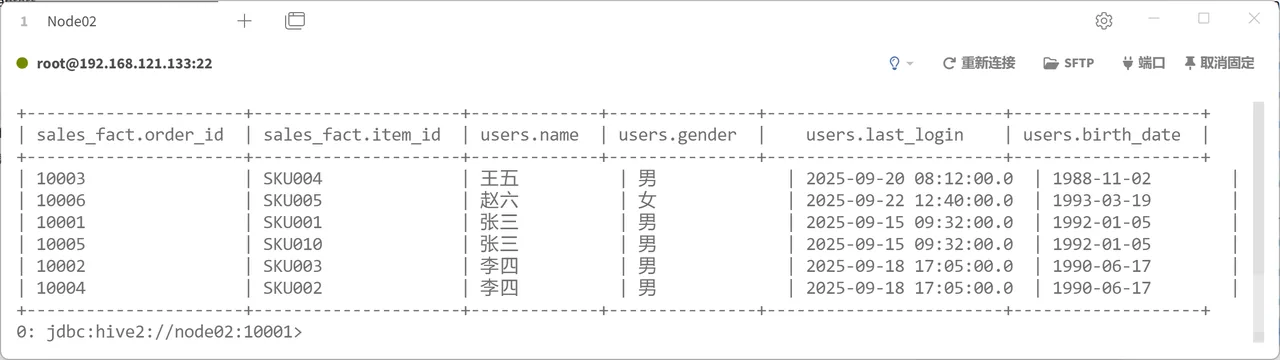
将分区表sales_fact与表users通过内连接的方式关联,筛选出2025年8月的订单及其对应的用户基本信息,返回订单ID、商品ID、用户姓名、用户性别、用户最近登录时间和用户出生日期,具体HiveQL语句如下。
▸ 课件步骤 03
上述语句执行完成后的效果如图。
从逻辑处理角度看,连接条件会先决定表之间的匹配关系,WHERE子句再对连接结果进行过滤。因此,如果只是希望在连接查询完成后对结果进行过滤,可以在JOIN语句的结尾追加WHERE子句设置筛选条件。但如果筛选条件需要影响连接查询,则需要在连接条件中明确指定。
此外,在对分区表进行左外连接、右外连接或全外连接时,如果未满足连接条件,就会在结果中产生NULL。若此时通过WHERE子句设置筛选条件来限定查询分区,则会直接过滤掉包含NULL的记录,从而破坏左外连接、右外连接或全外连接的语义。因此,当需要限定分区时,应将其写在JOIN语句的连接条件中,而不是写在WHERE子句中。
连接查询中的WHERE子句
例如,下面的HiveQL语句在连接条件中同时指定了公共字段的匹配规则和分区限制。
具体语法
SELECT a.val, b.valFROM a LEFT JOIN b
ON a.key=b.key AND b.ds='2025-07-07' AND a.ds='2025-07-07';任务:执行抽样查询
5.8
📷 展开本知识点其余 3 张课件截图
七种连接的写法与用途(以学生-成绩为例)。
-- 内连接:只保留两边都匹配上的
SELECT s.stu_name, sc.score FROM student_info s JOIN score_info sc ON s.stu_id = sc.stu_id;
-- 左外:保留左表全部,右表没有的补 NULL(找没选课的学生)
SELECT s.stu_name, sc.score FROM student_info s LEFT JOIN score_info sc ON s.stu_id = sc.stu_id;
-- 右外 / 全外
SELECT s.stu_name, sc.score FROM student_info s RIGHT JOIN score_info sc ON s.stu_id = sc.stu_id;
SELECT s.stu_name, sc.score FROM student_info s FULL JOIN score_info sc ON s.stu_id = sc.stu_id;
-- 隐式连接(老写法,等价于内连接)
SELECT s.stu_name, sc.score FROM student_info s, score_info sc WHERE s.stu_id = sc.stu_id;
💡 Hive 只支持等值连接(ON a.id = b.id),非等值条件要放到 WHERE 里。
📄 展开课件原文(第 114–145 页,共 32 页)
执行抽样查询
了解抽样查询,能够使用字节数抽样、行抽样等方式从表中查询部分数据。
在处理大规模数据时,并非所有场景都需要对全量数据进行分析。在测试、调试或预分析阶段,我们通常更关注查询逻辑是否正确、结果趋势是否合理,而不是具体的全量结果。这时,从海量数据中抽取一部分具有代表性的样本即可满足需求。为了支持这种场景,Hive提供了抽样查询机制,即按照特定规则只选取部分数据返回,从而得到原始数据的一个子集。
Hive中的抽样主要包括字节数抽样、百分比抽样、行抽样和分桶抽样,具体介绍如下。
字节样抽样
百分比抽样
行抽样
分桶抽样
Hive抽样
字节数抽样是一种基于HDFS数据块(Block)的抽样方式,用于从表中抽取不少于指定字节数的数据块集合。例如,若指定字节数为100MB,则Hive会在表对应的数据文件中随机选取若干数据块,使其累计大小不小于100MB。由于样本单位是完整数据块,实际数据量可能大于指定字节数。
1. 字节数抽样
具体实现过程为,首先Hive会统计目标表的数据总量,并根据设定的字节数推算出大致需要的数据块个数。然后,系统选择相应数量的数据块作为输入,以确保数据块的数据总量不低于指定的字节数。
关于字节数抽样的语法格式如下。
SELECT select_expr,select_expr,... FROM[db_name.]table_name TABLESAMPLE(size);用于指定目标字节数,并需带有单位
接下来,演示如何通过字节数抽样的方式对数据库chapter5中的分区表sales_fact实现抽样查询,具体内容如下。
▸ 课件步骤 01
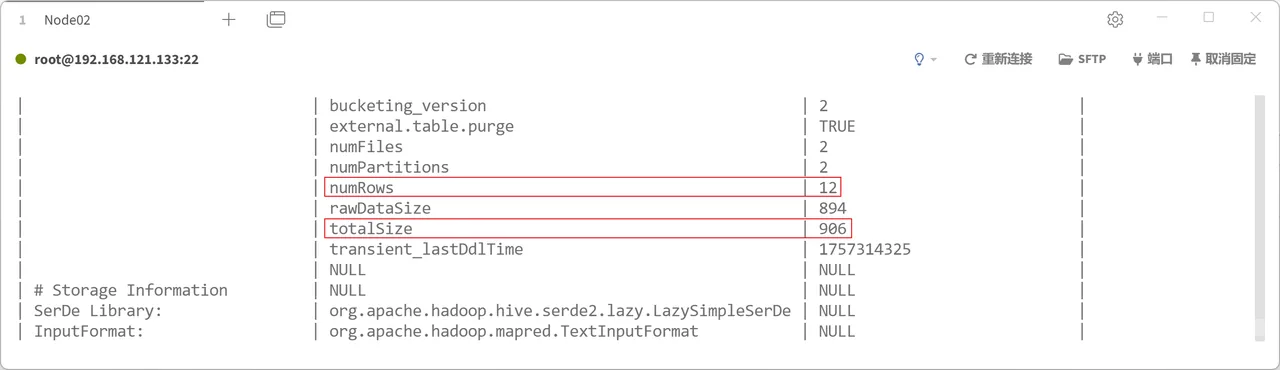
为了确定字节数抽样时指定的字节数是否合理,可以先查看分区表sales_fact的完整信息,从而获取该分区表的数据总量,如图。
▸ 课件步骤 02
通过SET语句在当前会话中临时指定Tez使用的InputFormat实现类为org.apache.hadoop.hive.ql.io.CombineHiveInputFormat,具体HiveQL语句如下。
SET
hive.tez.input.format=org.apache.hadoop.hive.ql.io.CombineHiveInputFormat;▸ 课件步骤 03
通过SET语句在当前会话中临时关闭自动触发FetchTask,具体HiveQL语句如下。
set hive.fetch.task.conversion=none;HiveQL语句
▸ 课件步骤 04
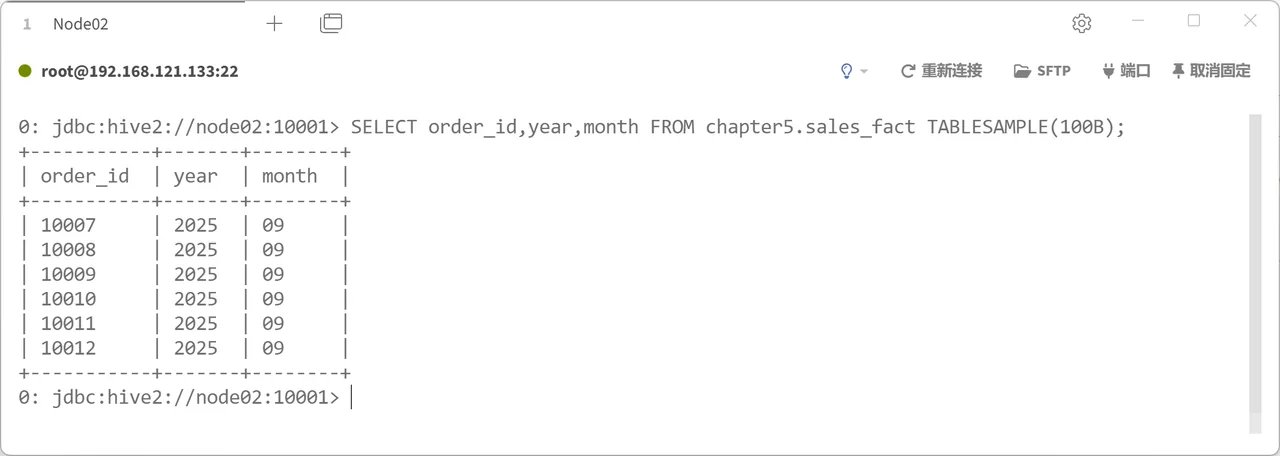
抽取分区表sales_fact中100字节的数据,并返回订单ID、年和月,具体HiveQL语句如下。
SELECT order_id,year,month FROM chapter5.sales_fact TABLESAMPLE(100B);▸ 课件步骤 04
上述语句执行完成后的效果如图。
百分比抽样同样是一种基于HDFS数据块(Block)的抽样方式,用于从表中抽取不少于指定比例的数据块集合。具体实现过程为,首先Hive会统计目标表的数据总量,并根据设定比例换算出需要抽取的大致字节数。然后,系统选择相应数量的数据块作为输入,以确保数据块的数据总量不低于字节数。
2. 百分比抽样
关于百分比抽样的语法格式如下。
[db_name.]table_name TABLESAMPLE(p PERCENT);语法格式
用于指定比例
接下来,演示如何通过百分比抽样的方式对数据库chapter5中的分区表sales_fact实现抽样查询,具体内容如下。
▸ 课件步骤 01
在当前会话中,通过SET语句临时指定Tez使用的InputFormat实现类为org.apache.hadoop.hive.ql.io.CombineHiveInputFormat,同时关闭自动触发FetchTask,具体HiveQL语句可参考前面对字节数抽样的演示操作。
▸ 课件步骤 02
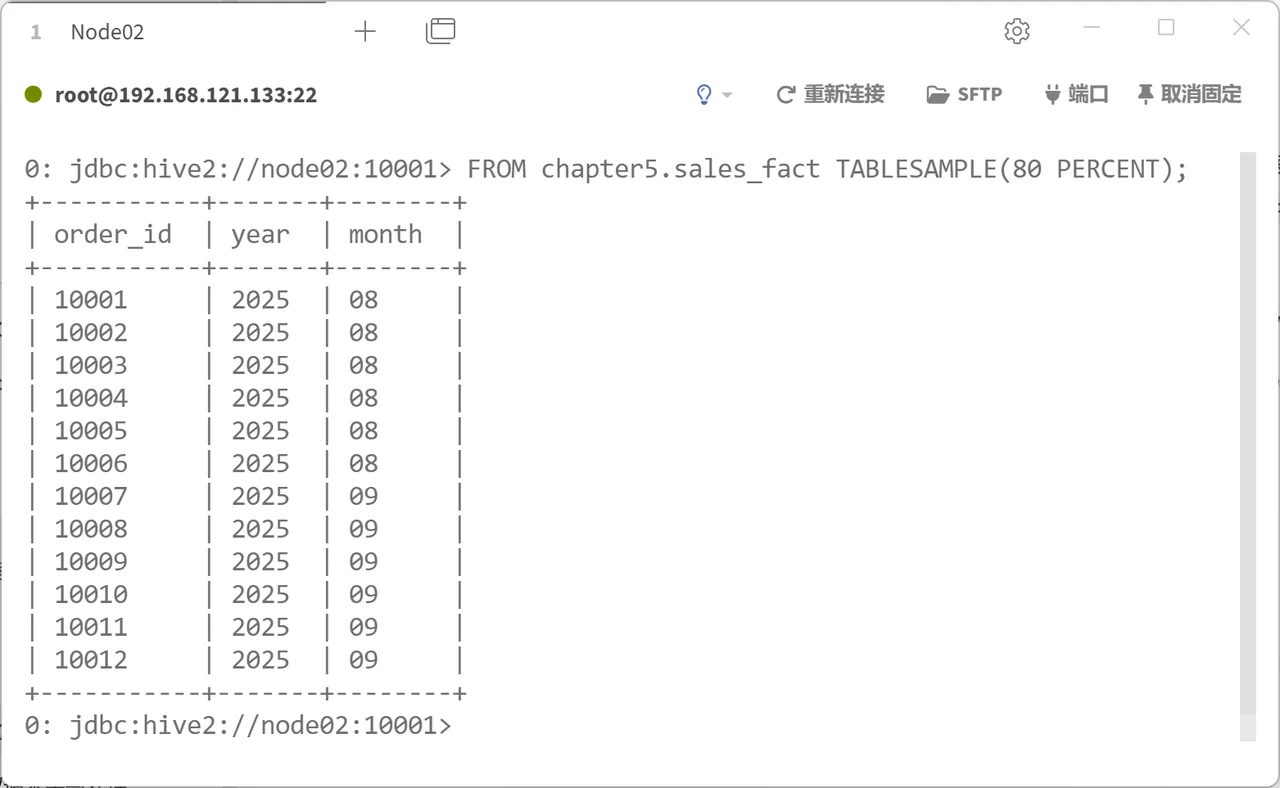
抽取分区表sales_fact中80%的数据,并返回订单ID、年和月,具体HiveQL语句如下。
SELECT order_id,year,month
FROM chapter5.sales_fact TABLESAMPLE(80 PERCENT);
▸ 课件步骤 02
行抽样是一种基于分片(Split)的抽样方式,用于从每个分片中抽取指定数量的行。分片是执行引擎在读取表文件时逻辑上划分任务的基本单元。默认情况下,分片大小接近 HDFS 数据块的大小(默认128 MB)。当文件小于128MB时,会生成一个Split。当文件大于128MB时,会根据文件大小被划分为多个Split。
3. 行抽样
关于行抽样的语法格式如下。
[db_name.]table_name TABLESAMPLE(n ROWS);用于指定行数
需要注意的是,若行抽样通过FetchTask执行,则无论是分区表还是非分区表都仅会从全表返回前两行数据。
接下来,演示如何通过行抽样的方式对数据库chapter5中的分区表sales_fact实现抽样查询,具体内容如下。
▸ 课件步骤 01
在当前会话中,关闭自动触发FetchTask,具体HiveQL语句可参考前面对字节数抽样的演示操作。
▸ 课件步骤 02
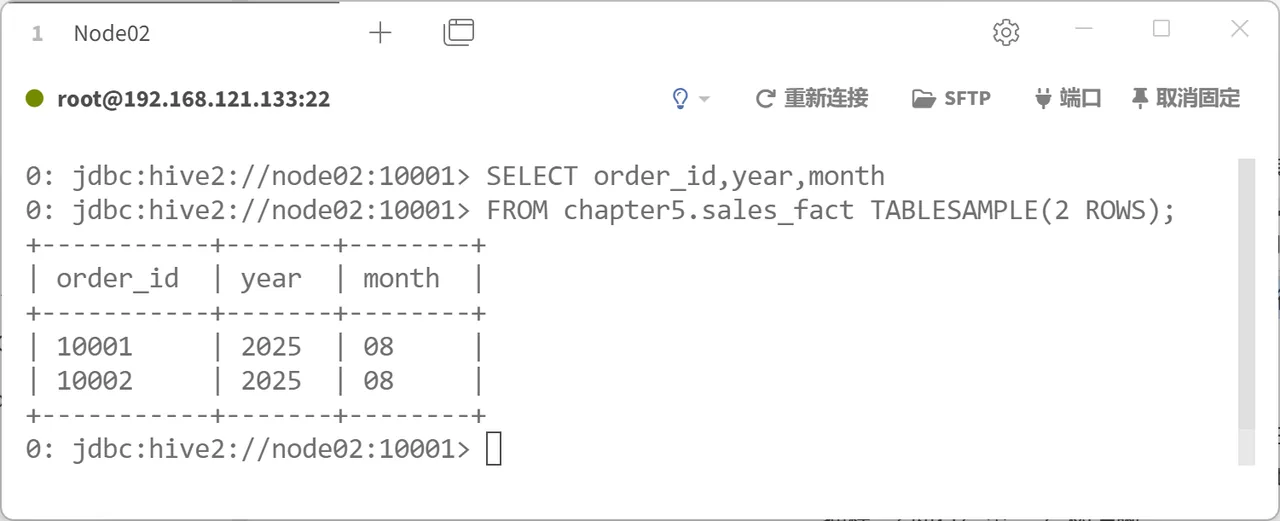
抽取分区表sales_fact两行数据,并返回订单ID、年和月,具体HiveQL语句如下。
FROM chapter5.sales_fact TABLESAMPLE(2 ROWS);▸ 课件步骤 02
使用InputFormat实现类为org.apache.hadoop.hive.ql.io.HiveInputFormat时,上述语句执行完成后的效果如图。
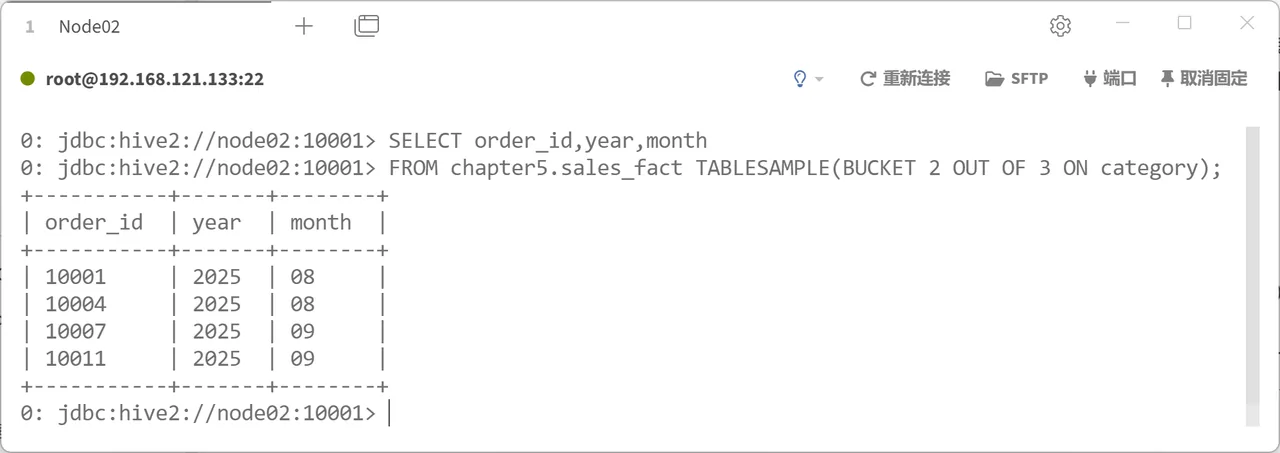
分桶抽样是一种基于分桶的抽样方式。其基本原理是将数据随机分配到预定义数量的桶(Bucket)中,每个桶按顺序编号,起始值为1,依次递增。抽样时只选择指定编号的桶,并返回该桶内的全部数据作为样本。
4. 分桶抽样
关于分桶抽样的语法格式如下。
[db_name.]table_name TABLESAMPLE(BUCKET x OUT OF y [ON bucket_col]);用于指定桶的编号
用于指定逻辑分桶的数量
用于显式指定分桶字段
接下来,演示如何通过分桶抽样的方式对数据库chapter5中的分区表sales_fact实现抽样查询,具体内容如下。
FROM chapter5.sales_fact TABLESAMPLE(BUCKET 2 OUT OF 3 ON category);随机抽样
除了Hive内置的四种抽样方式外,还可以在查询语句中利用DISTRIBUTE BY子句和SORT BY子句结合RAND()函数,并配合LIMIT子句实现随机抽取。该方式是先将目标表的数据随机分发到不同任务中,再在每个任务内进行随机排序,最后从结果集中返回前N条记录。
例如,对数据库chapter5中的分区表sales_fact执行随机抽取,并限制结果集返回前5条记录,具体HiveQL语句如下。
SELECT * FROM chapter5.sales_factDISTRIBUTE BY RAND() SORT BY RAND() LIMIT 5;DISTRIBUTE BY子句和SORT BY子句不能用CLUSTER BY子句代替。同时,LIMIT子句是必须的,不可省略。
在执行随机抽样时,还可以通过为RAND()函数指定整数作为种子,使结果集具有可复现性。当种子值保持不变时,每次执行都会返回相同的结果。
例如,对数据库chapter5中的分区表sales_fact执行随机抽取,分别为DISTRIBUTE BY子句和SORT BY子句中的RAND()函数设定种子为2和3,并限制结果集返回前5条记录,具体HiveQL语句如下。
SELECT * from chapter5.sales_factAI助学
学完本单元后,我已经初步掌握了Hive中数据查询的基本方法。然而,在面对实际分析需求时,仍可能难以判断查询语句应如何组织,筛选、分组、排序、合并、连接和抽样等操作应如何配合使用。此时,可以借助AI对分析需求和查询思路进行梳理,帮助判断HiveQL语句的结构是否合理,并提示可能存在的问题。
AI
助
学
单元总结
本单元主要讲解了Hive的数据查询语言。首先,介绍了SELECT语句的语法结构。然后,讲解了常见的查询方式,包括条件查询、公共表表达式、分组查询、排序查询、合并查询、连接查询和抽样查询。通过本单元的学习,读者能够熟练编写HiveQL查询语句查询Hive表中的数据,为实际数据仓库分析应用提供支撑。
单
元
总
结
📷 展开本知识点其余 1 张课件截图
📄 展开课件原文(第 146–177 页,共 32 页)
🧪 动手做一遍 12 步练完 Hive 查询的全部招式
预计用时约 45 分钟 · 每一步都给出可执行语句与预期结果,建议边看边在 Beeline / DataGrip 里敲一遍
本实例步骤
- 01 SELECT:取你想看的列
- 02 WHERE:条件过滤
- 03 LIKE / IN / BETWEEN:模糊与集合判断
- 04 GROUP BY:分组统计
- 05 HAVING:过滤分组后的结果
- 06 ORDER BY:按总分排名
- 07 JOIN:四表关联,拼出明细宽表
- 08 LEFT JOIN:找出“没选课”的学生
- 09 CTE:把复杂查询拆成几段
- 10 UNION ALL:纵向合并两个结果集
- 11 窗口函数:组内排名与累计
- 12 TABLESAMPLE:先抽样再分析
01SELECT:取你想看的列
先看清楚表里有什么,再决定查什么。
SELECT * FROM student_info LIMIT 5;
SELECT stu_id, stu_name, sex FROM student_info LIMIT 5;验证语句:SELECT stu_id, stu_name, sex FROM student_info LIMIT 5
| stu_id | stu_name | sex |
|---|---|---|
| 001 | 彭于晏 | 男 |
| 002 | 胡歌 | 男 |
| 003 | 周杰伦 | 男 |
| 004 | 刘德华 | 男 |
| 005 | 唐国强 | 男 |
💡 生产环境别写 SELECT *:列存格式(ORC/Parquet)只读用到的列,写全列等于放弃这个优化。
02WHERE:条件过滤
用 and / or / 比较运算筛出目标行。
SELECT stu_id, stu_name, birthday
FROM student_info
WHERE sex = '女' AND birthday > '1995-01-01';验证语句:SELECT stu_id, stu_name, birthday FROM student_info WHERE sex = '女' AND birthday > '1995-01-01'
| stu_id | stu_name | birthday |
|---|---|---|
| 012 | 杨紫 | 1996-12-21 |
| 013 | 蒋欣 | 1997-11-08 |
yyyy-MM-dd 的字典序等于时间序。03LIKE / IN / BETWEEN:模糊与集合判断
三个最常用的“范围”写法。
-- 姓刘的学生
SELECT stu_name FROM student_info WHERE stu_name LIKE '刘%';
-- 指定几个学号
SELECT stu_name FROM student_info WHERE stu_id IN ('001','002','003');
-- 1994 年出生
SELECT stu_name, birthday FROM student_info
WHERE birthday BETWEEN '1994-01-01' AND '1994-12-31';验证语句:SELECT stu_name FROM student_info WHERE stu_name LIKE '刘%'
| stu_name |
|---|
| 刘德华 |
| 刘亦菲 |
💡 LIKE '%刘%' 无法走索引、也不能分区裁剪,大数据量下要慎用。
04GROUP BY:分组统计
把明细数据汇总成指标——数仓里最核心的一步。
SELECT course_id,
       count(*)              AS 选课人数,
       round(avg(score), 2)  AS 平均分,
       max(score)            AS 最高分,
       min(score)            AS 最低分
FROM score_info
GROUP BY course_id
ORDER BY course_id;验证语句:SELECT course_id, count(*) AS cnt, round(avg(score),2) AS avg_score, max(score) AS max_score, min(score) AS min_score FROM score_info GROUP BY course_id ORDER BY course_id
| course_id | cnt | avg_score | max_score | min_score |
|---|---|---|---|---|
| 01 | 19 | 67.16 | 94 | 38 |
| 02 | 19 | 59.63 | 93 | 34 |
| 03 | 19 | 69.42 | 99 | 32 |
| 04 | 12 | 63.42 | 100 | 34 |
| 05 | 5 | 74.6 | 87 | 59 |
05HAVING:过滤分组后的结果
和 WHERE 分工不同:WHERE 过滤行,HAVING 过滤组。
SELECT course_id, round(avg(score), 2) AS avg_score
FROM score_info
GROUP BY course_id
HAVING avg(score) > 65
ORDER BY avg_score DESC;验证语句:SELECT course_id, round(avg(score),2) AS avg_score FROM score_info GROUP BY course_id HAVING avg(score) > 65 ORDER BY avg_score DESC
| course_id | avg_score |
|---|---|
| 05 | 74.6 |
| 03 | 69.42 |
| 01 | 67.16 |
💡 能写在 WHERE 里的条件就别放 HAVING——WHERE 先执行,参与分组的数据更少。
06ORDER BY:按总分排名
全局排序,取前几名。
SELECT stu_id, sum(score) AS total
FROM score_info
GROUP BY stu_id
ORDER BY total DESC
LIMIT 5;验证语句:SELECT stu_id, sum(score) AS total FROM score_info GROUP BY stu_id ORDER BY total DESC LIMIT 5
| stu_id | total |
|---|---|
| 005 | 377 |
| 009 | 371 |
| 002 | 345 |
| 004 | 326 |
| 016 | 325 |
SORT BY。07JOIN:四表关联,拼出明细宽表
事实表(成绩)+ 三张维度表(学生 / 课程 / 老师)的标准关联方式。
SELECT s.stu_name, c.course_name, t.tea_name, sc.score
FROM score_info sc
JOIN student_info s ON sc.stu_id   = s.stu_id
JOIN course_info  c ON sc.course_id = c.course_id
JOIN teacher_info t ON c.tea_id    = t.tea_id
WHERE sc.course_id = '02'
ORDER BY sc.score DESC
LIMIT 5;验证语句:SELECT s.stu_name, c.course_name, t.tea_name, sc.score FROM score_info sc JOIN student_info s ON sc.stu_id = s.stu_id JOIN course_info c ON sc.course_id = c.course_id JOIN teacher_info t ON c.tea_id = t.tea_id WHERE sc.course_id = '02' ORDER BY sc.score DESC LIMIT 5
| stu_name | course_name | tea_name | score |
|---|---|---|---|
| 刘德华 | 数学 | 张高数 | 93 |
| 陈道明 | 数学 | 张高数 | 90 |
| 周冬雨 | 数学 | 张高数 | 89 |
| 胡歌 | 数学 | 张高数 | 84 |
| 郭德纲 | 数学 | 张高数 | 78 |
💡 小表放右边、大表放左边,Hive 更容易把小表装进内存做 Map Join。
08LEFT JOIN:找出“没选课”的学生
用左连接 + IS NULL 做“差集”查询,这是数据分析的高频套路。
SELECT s.stu_id, s.stu_name
FROM student_info s
LEFT JOIN score_info sc
       ON s.stu_id = sc.stu_id AND sc.course_id = '05'
WHERE sc.stu_id IS NULL;验证语句:SELECT s.stu_id, s.stu_name FROM student_info s LEFT JOIN score_info sc ON s.stu_id = sc.stu_id AND sc.course_id = '05' WHERE sc.stu_id IS NULL
| stu_id | stu_name |
|---|---|
| 001 | 彭于晏 |
| 002 | 胡歌 |
| 003 | 周杰伦 |
| 004 | 刘德华 |
| 006 | 陈道明 |
| 008 | 吴京 |
| 010 | 于谦 |
| 011 | 潘长江 |
| 012 | 杨紫 |
| 013 | 蒋欣 |
| 014 | 赵丽颖 |
| 016 | 周冬雨 |
ON 里(而不是 WHERE),否则外连接会被降级成内连接,结果就错了。09CTE:把复杂查询拆成几段
WITH 让长 SQL 可读、可复用,也便于逐步调试。
WITH course_avg AS (
    SELECT course_id, round(avg(score), 2) AS avg_score
    FROM score_info GROUP BY course_id
)
SELECT c.course_name, a.avg_score
FROM course_avg a
JOIN course_info c ON a.course_id = c.course_id
ORDER BY a.avg_score DESC;验证语句:WITH course_avg AS (SELECT course_id, round(avg(score), 2) AS avg_score FROM score_info GROUP BY course_id) SELECT c.course_name, a.avg_score FROM course_avg a JOIN course_info c ON a.course_id = c.course_id ORDER BY a.avg_score DESC
| course_name | avg_score |
|---|---|
| 音乐 | 74.6 |
| 英语 | 69.42 |
| 语文 | 67.16 |
| 体育 | 63.42 |
| 数学 | 59.63 |
💡 一条 SQL 里可以写多个 CTE,用逗号分隔,后面的可以直接引用前面的。
10UNION ALL:纵向合并两个结果集
把结构相同的查询结果摞在一起。
SELECT '男生' AS 类别, count(*) AS 人数 FROM student_info WHERE sex = '男'
UNION ALL
SELECT '女生' AS 类别, count(*) AS 人数 FROM student_info WHERE sex = '女';验证语句:SELECT '男生' AS lb, count(*) AS num FROM student_info WHERE sex = '男' UNION ALL SELECT '女生', count(*) FROM student_info WHERE sex = '女'
| lb | num |
|---|---|
| 男生 | 11 |
| 女生 | 9 |
UNION 会去重(多一次 Shuffle,更慢),确定没有重复就用 UNION ALL。11窗口函数:组内排名与累计
既要明细行、又要组内统计——窗口函数一次搞定。
-- 每门课内部按成绩排名,取前 3 名
SELECT * FROM (
    SELECT course_id, stu_id, score,
           rank() OVER (PARTITION BY course_id ORDER BY score DESC) AS rk
    FROM score_info
) t
WHERE rk <= 3
ORDER BY course_id, rk;验证语句:SELECT * FROM (SELECT course_id, stu_id, score, rank() OVER (PARTITION BY course_id ORDER BY score DESC) AS rk FROM score_info) t WHERE rk <= 3 ORDER BY course_id, rk LIMIT 12
| course_id | stu_id | score | rk |
|---|---|---|---|
| 01 | 001 | 94 | 1 |
| 01 | 015 | 90 | 2 |
| 01 | 020 | 89 | 3 |
| 02 | 004 | 93 | 1 |
| 02 | 006 | 90 | 2 |
| 02 | 016 | 89 | 3 |
| 03 | 005 | 99 | 1 |
| 03 | 013 | 93 | 2 |
| 03 | 019 | 93 | 2 |
| 04 | 002 | 100 | 1 |
| 04 | 016 | 94 | 2 |
| 04 | 005 | 85 | 3 |
💡 row_number() 不并列、rank() 并列跳号、dense_rank() 并列不跳号,取 TopN 时按需求选。
12TABLESAMPLE:先抽样再分析
在亿级表上试 SQL 时,先抽 1% 数据验证逻辑。
-- 按桶抽样(表是分桶表时效率最高)
SELECT * FROM score_bucket TABLESAMPLE(BUCKET 1 OUT OF 4 ON stu_id);
-- 按数据块比例抽样
SELECT * FROM score_info TABLESAMPLE(10 PERCENT);| 抽样方式 | 说明 |
|---|---|
| BUCKET x OUT OF y ON col | 按列哈希取第 x 个桶,要求表已按该列分桶 |
| n PERCENT | 按输入数据块比例抽样,不是精确行数 |
| n ROWS | 直接取前 n 行 |