Hive概述、原理及架构

Hive概述、原理及架构

本讲义用另一个视角重讲 Hive 的由来、优缺点、在 Hadoop 生态中的位置,以及 Hive 的原理、体系结构、运行机制、转换过程、数据类型与数据存储,可与单元1 对照学习。

第4周课堂讲义(独立课件)18 页课件补充讲义
怎么用这份讲义它与单元1讲的是同一批知识(Hive 的由来、原理与架构),但组织方式不同:单元1 按“任务—知识点”展开,本讲义按“定义 → 优缺点 → 生态位置 → 原理 → 体系结构 → 运行机制 → 数据类型与存储”顺次推进。建议先学单元1,再用本讲义复习。

讲义全文(按页)

hive概述

hive概述

hive概述

hive概述

Hive技术的出现降低了大数据学习门槛,很多传统数据分析人员可以直接使用Hive进行了大数据分析,接下来先初步了解Hive的基本概念

为什么要用hive

湖南软件职业技术大学

Hive在Hadoop生态系统中的位置

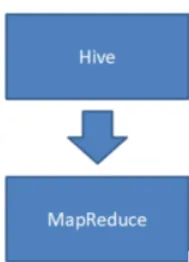
Hive利用HDFS来存储数据,利用MapReduce来查询分析数据,那么Hive与Hadoop之间的关系总结如下。

具有良好的扩展性,且能够实现与其他组件的集成开发。

对HQL查询语句的解释、优化、生成查询计划等过程均是由 Hive 完成的,而查询计划被转化为 MapReduce 任务之后需要运行在 Hadoop 集群之上。

Hive中的所有数据都存储在Hadoop分布式文件系统中。

Hive需要构建在Hadoop集群之上。

Hive是构建在Hadoop之上的离线分析系统,主要用于存储和处理海量结构数据。这些海量结构化数据一般存储就在HDFS上,Hive可以将上面的数据映射到一张数据表,赋予数据一种表结构,同时Hive提供了丰富的类SQL(简称HQL)语言对表中的数据进行统计分析。

Hive定义

Hive首先对HQL语言进行解析和转换,生成一系列MapReduce任务,然后再Hadoop集群上执行MapReduce任务完成对数据的处理。这样,不熟悉MapReduce的用户也能很方便地利用HQL语句对数据进行查询、分析、汇总。目前,Hive已经是一个非常成功的Apache项目,很多公司和组织都将Hive当做大数据仓库工具。

Hive的诞生源于 Facebook 的日志分析需求,面对海量的结构化数据, Hive能够以较低的成本完成以往需要大规模数据库才能完成的任务,并且学习门槛相对较低,应用开发灵活且高效。后来Facebook将Hive开源给了 Apache,成为 Apache 的一个顶级项目,至此Hive在大数据应用方面得到了快速的发展和普及。

Hive产生的背景

Hive的优缺点

Hive适合数据的批处理,解决了传统关系型数据库在海量数据处理上的瓶颈。

Hive构建在Hadoop之上,充分利用了集群的存储资源、计算资源。

hive的优点

Hive学习使用成本低,支持标准的SQL语法,这样就免去了编写MapReduce程序的过程,减少了开发成本。

hive的缺点

HQL的表达能力依然有限,不支持迭代计算,有些复杂的运算用 HQL不易表达,还需要单独编写MapReduce来实现。

Hive的运行效率低、延迟高,这是因为Hive底层计算引擎默认为MapReduce,而MapReduce是离线计算框架。

Hive的调优比较困难,由于HQL语句最终会转换为MapReduce任务,所以Hive的调优还需要考虑MapReduce层面的优化。
第2页 · 课件截图
第2页 · 课件截图
第4页 · 课件截图
第4页 · 课件截图
第5页 · 课件截图
第5页 · 课件截图
📄 展开课件原文(第 2–8 页,共 7 页)
第 2 页

hive概述

Hive技术的出现降低了大数据学习门槛,很多传统数据分析人员可以直接使用Hive进行了大数据分析,接下来先初步了解Hive的基本概念

为什么要用hive

湖南软件职业技术大学

第 3 页

hive概述

Hive在Hadoop生态系统中的位置

湖南软件职业技术大学

Hive利用HDFS来存储数据,利用MapReduce来查询分析数据,那么Hive与Hadoop之间的关系总结如下。

具有良好的扩展性,且能够实现与其他组件的集成开发。

对HQL查询语句的解释、优化、生成查询计划等过程均是由 Hive 完成的,而查询计划被转化为 MapReduce 任务之后需要运行在 Hadoop 集群之上。

Hive中的所有数据都存储在Hadoop分布式文件系统中。

Hive需要构建在Hadoop集群之上。

第 4 页

hive概述

Hive是构建在Hadoop之上的离线分析系统,主要用于存储和处理海量结构数据。这些海量结构化数据一般存储就在HDFS上,Hive可以将上面的数据映射到一张数据表,赋予数据一种表结构,同时Hive提供了丰富的类SQL(简称HQL)语言对表中的数据进行统计分析。

Hive定义

湖南软件职业技术大学

第 5 页

hive概述

Hive首先对HQL语言进行解析和转换,生成一系列MapReduce任务,然后再Hadoop集群上执行MapReduce任务完成对数据的处理。这样,不熟悉MapReduce的用户也能很方便地利用HQL语句对数据进行查询、分析、汇总。目前,Hive已经是一个非常成功的Apache项目,很多公司和组织都将Hive当做大数据仓库工具。

Hive定义

湖南软件职业技术大学

第 6 页

hive概述

Hive的诞生源于 Facebook 的日志分析需求,面对海量的结构化数据, Hive能够以较低的成本完成以往需要大规模数据库才能完成的任务,并且学习门槛相对较低,应用开发灵活且高效。后来Facebook将Hive开源给了 Apache,成为 Apache 的一个顶级项目,至此Hive在大数据应用方面得到了快速的发展和普及。

Hive产生的背景

湖南软件职业技术大学

第 7 页

hive概述

Hive的优缺点

湖南软件职业技术大学

01

Hive适合数据的批处理,解决了传统关系型数据库在海量数据处理上的瓶颈。

02

Hive构建在Hadoop之上,充分利用了集群的存储资源、计算资源。

03

hive的优点

04

Hive学习使用成本低,支持标准的SQL语法,这样就免去了编写MapReduce程序的过程,减少了开发成本。

具有良好的扩展性,且能够实现与其他组件的集成开发。

第 8 页

hive概述

Hive的优缺点

湖南软件职业技术大学

hive的缺点

01

02

03

HQL的表达能力依然有限,不支持迭代计算,有些复杂的运算用 HQL不易表达,还需要单独编写MapReduce来实现。

Hive的运行效率低、延迟高,这是因为Hive底层计算引擎默认为MapReduce,而MapReduce是离线计算框架。

Hive的调优比较困难,由于HQL语句最终会转换为MapReduce任务,所以Hive的调优还需要考虑MapReduce层面的优化。
Hive原理及架构

Hive原理及架构

Hive原理及架构

Hive原理及架构

Hive是构建在Hadoop之上的sql引擎,它重用了Hadoop中的HDFS和MapReduce等。Hive是Hadoop生态中的重要组成部分,也是目前应用最广泛的SQL on Hadoop解决方案。

为什么要用hive

湖南软件职业技术大学

SHELL
Hive 是一种构建在Hadoop之上的数据仓库工具,可以使用HQL 语句对数据进行分析和查询,而Hive 的底层数据都存储在HDFS中。Hive 在加载数据过程中不会对数据进行任何的修改,只是将数据移动到指定的HDFS目录下。

Hive的设计原理

hive的特点如下:

支持索引,加快数据查询。

不同的存储类型,例如,纯文本文件、HBase 中的文件。

将元数据保存在关系数据库中,大大减少了在查询过程中执行语义检查的时间。

可以直接使用存储在Hadoop 文件系统中的数据。

内置大量用户自定义函数(user define function,简称UDF)来对时间、字符串进行操作,支持用户扩展UDF 函数来完成内置函数无法实现的操作。

HQL语句最终会被转换为MapReduce任务运行在Hadoop集群之上。

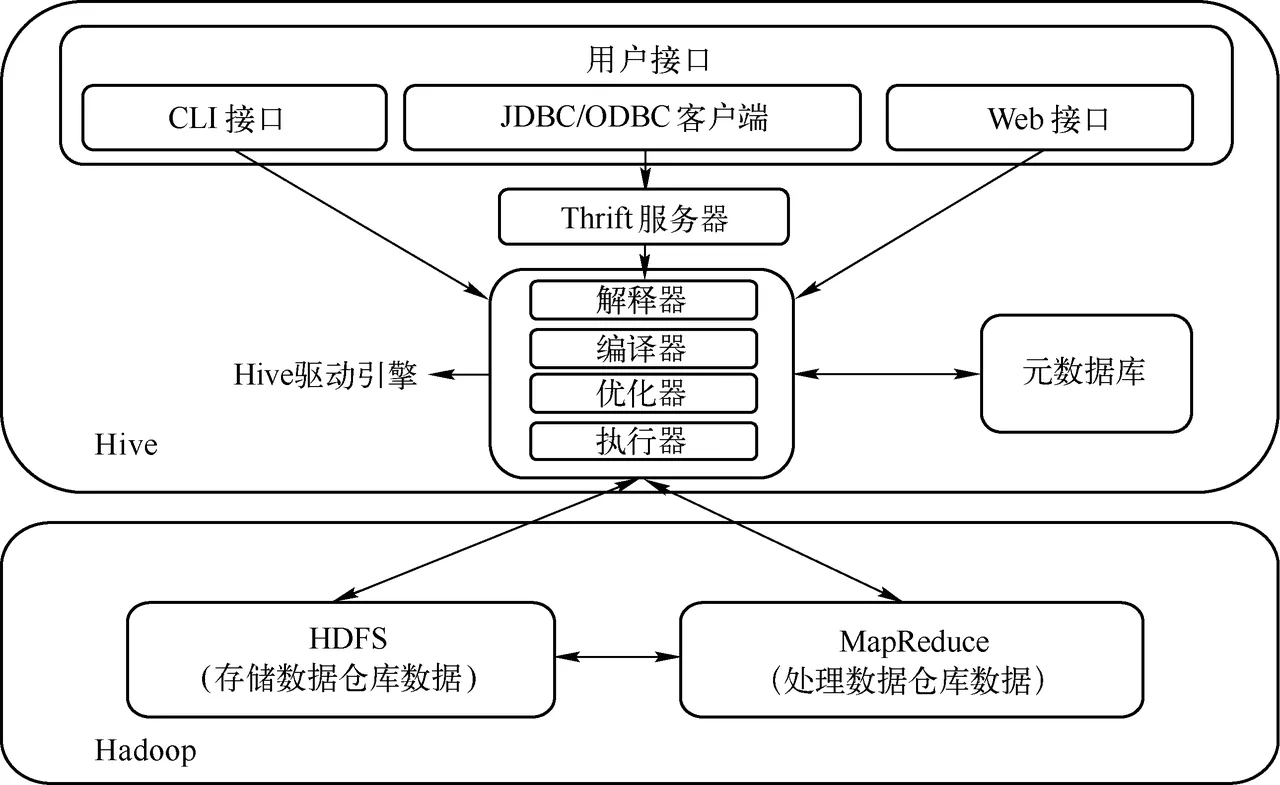
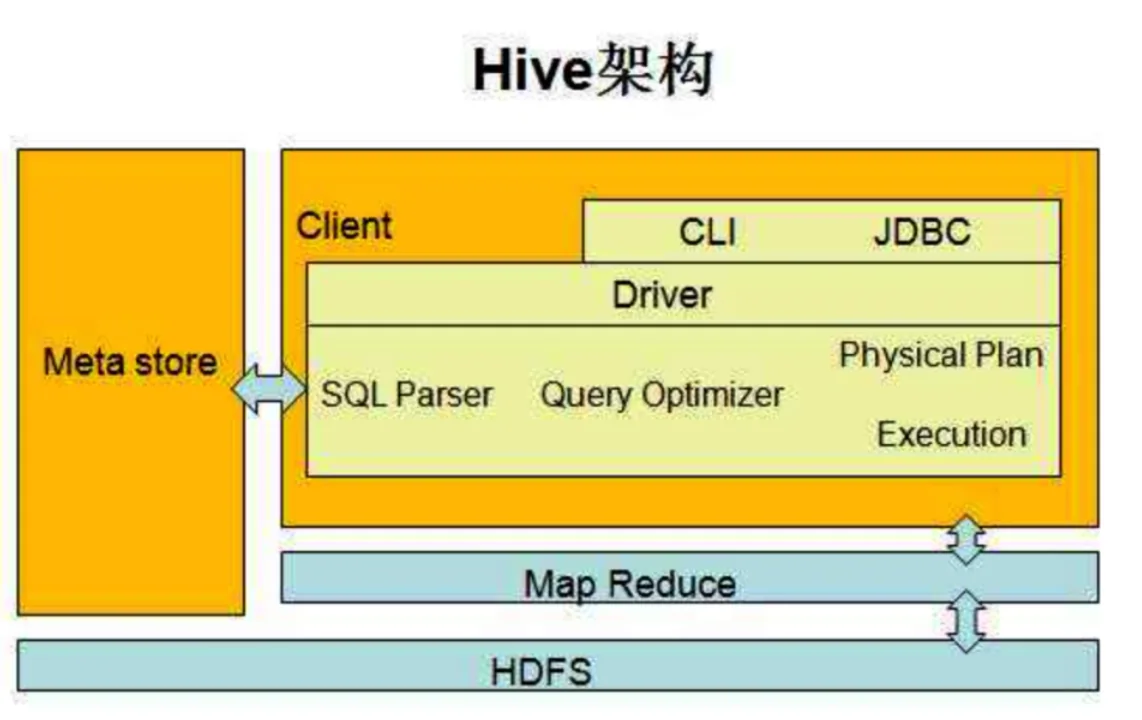
Hive的体系结构

用户接口

用户接口主要有CLI,Client 和 WUI三个。其中最常用的是CLI,Cli启动的时候,会同时启动一个Hive副本。Client是Hive的客户端,用户连接至Hive Server。在启动 Client模式的时候,需要指出Hive Server所在节点,并且在该节点启动Hive Server。 WUI是通过浏览器访问Hive。

Thrift服务器

Thrift服务器是基于socket通讯,支持跨语言。Hive Thrift服务简化了在多编程语言中运行Hive的命令。绑定支持C++,Java,PHP,Python和Ruby语言。

Hive驱动引擎

解释器、编译器、优化器完成HQL查询语句从词法分析、语法分析、编译、优化以及查询计划的生成。生成的查询计划存储在HDFS中,并在随后有MapReduce调用执行。

元数据库

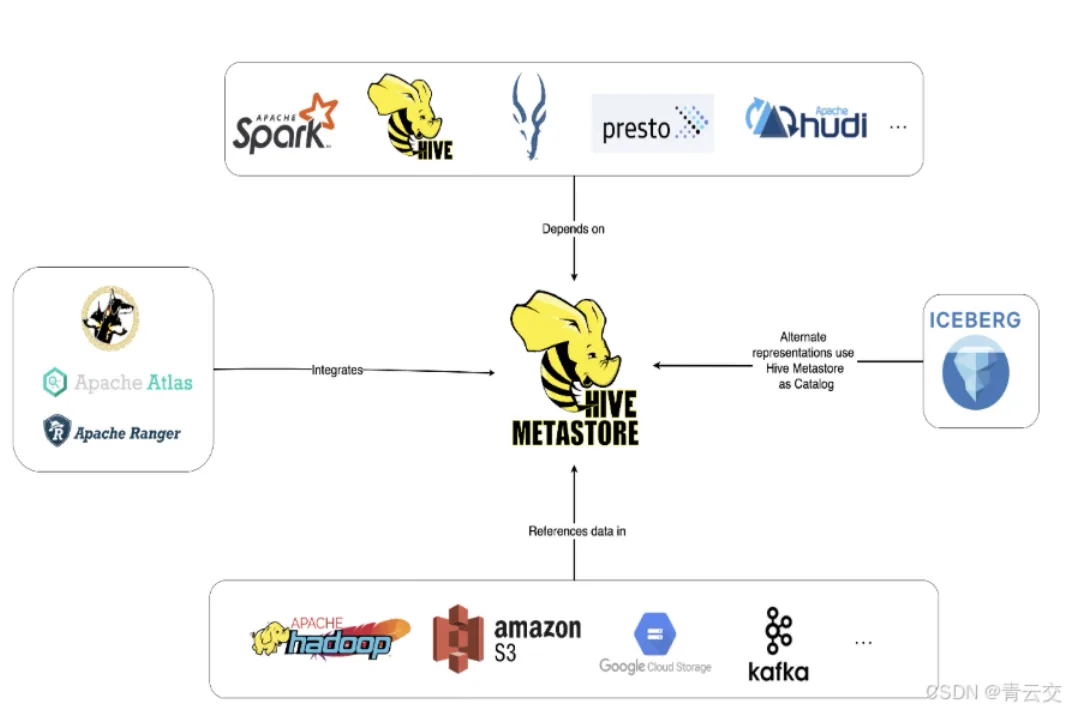
Hive的数据由两部分组成:数据文件和元数据。元数据用于存放Hive库的基础信息,它存储在关系数据库中,如 mysql、derby。元数据包括:数据库信息,表的名字,表的列和分区及其属性,表的属性,表的数据所在目录等。

Hadoop集群

Hive的数据文件存储在HDFS中,大部分的查询由 MapReduce 完成。

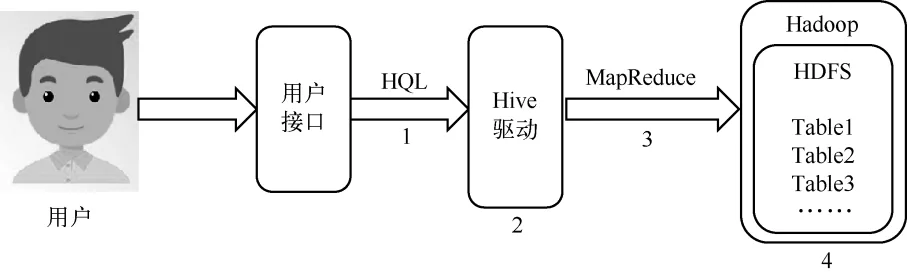
Hive的运行机制如图

Hive的运行机制

(1)用户通过用户接口连接hive,编写HQL语句。

(2)Hive解析查询并指定逻辑查询计划。

(3)Hive将查询转换成MapReduce作业。

(4)Hive在Hadoop上执行MapReduce作业。

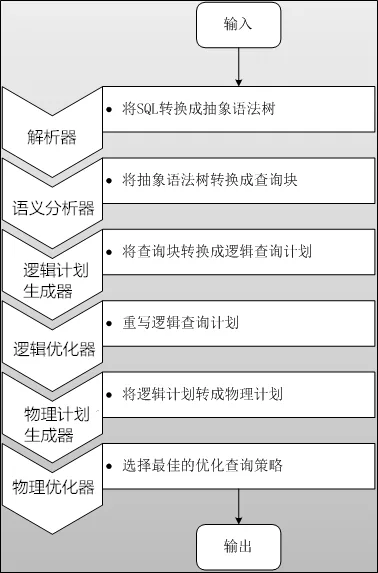
HQL转换为MapReduce作业的过程

(1)通过开源语法分析器Antlr完成SQL解析,将SQL转化为抽象语法树(AST AbstractSyntaxTree)。

(2)遍历抽象语法树,生成查询的基本组成单元QueryBlock,是一个递归的过程,QueryBlock包括输入源、计算过程、输出,是一个子查询。

(3)遍历OueryBlock,翻译为执行操作树OperatorTree。

(4)对OperatorTree进行优化,如分桶Map端聚合、合并相关的操作、将过滤操作提前。

(5)遍历OperatorTree,翻译为MapReduce任务。

(6)进行物理层优化,生成最终的执行计划。

Hive的基本数据类型

Hive的数据类型

Hive的复杂数据类型

Hive的数据存储

表

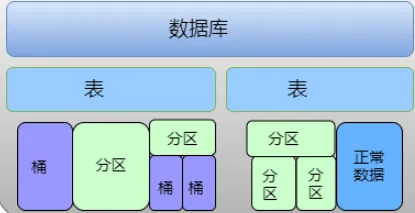
Hive的表在逻辑上由存储的数据和描述表中数据形式的相关元数据组成。数据一般存放在HDFS中,但它也可以放在其他任何Hadoop文件系统中,包括本地文件系统或S3。Hive把元数据存放在关系型数据库中,而不是放在HDFS中。在Hive中创建表时,默认情况下Hive负责管理数据。这意味着Hive把数据移入它的“仓库目录”。另外一种选择是创建一个外部表(external table),这会让Hive到仓库目录以外的位置访问数据。

分区(Partition)

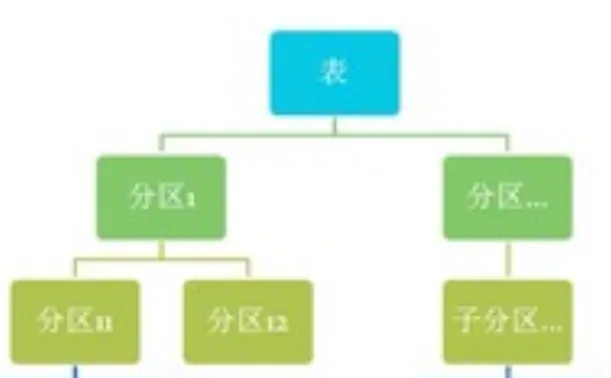
Hive把表组织成分区。这是一种根据分区列(如日期)的值对表进行粗略划分的机制。使用分区可以加快数据分片的查询速度。以分区的常用情况为例,如日志文件的每条记录包含一个时间戳。如果我们根据日期来对它进行分区,那么同一天的记录就会被存放在同一个分区中。这样做的优点是:对于限制到某个或者某些特定日期的查询,它们的处理可以变得非常高效。因为它们只需要扫描查询范围内分区中的文件。注意,使用分区并不会影响大范围查询的执行,我们仍然可以查询跨多个分区的整个数据集。

分桶

表或者分区可以进一步分为桶。它会为数据提供额外的结构以获得更高效的查询处理。例如,通过用户ID来划分桶,我们可以在所有用户集合的随机样本上快速计算基于用户的查询。
第10页 · 课件截图
第10页 · 课件截图
第12页 · 课件截图
第12页 · 课件截图
第13页 · 课件截图
第13页 · 课件截图
第14页 · 课件截图
第14页 · 课件截图
📷 展开本知识点其余 3 张课件截图
第17页 · 课件截图
第17页 · 课件截图
第17页 · 课件截图
第17页 · 课件截图
第17页 · 课件截图
第17页 · 课件截图
📄 展开课件原文(第 9–17 页,共 9 页)
第 9 页

Hive原理及架构

Hive是构建在Hadoop之上的sql引擎,它重用了Hadoop中的HDFS和MapReduce等。Hive是Hadoop生态中的重要组成部分,也是目前应用最广泛的SQL on Hadoop解决方案。

为什么要用hive

湖南软件职业技术大学

第 10 页

Hive原理及架构

Hive 是一种构建在Hadoop之上的数据仓库工具,可以使用HQL 语句对数据进行分析和查询,而Hive 的底层数据都存储在HDFS中。Hive 在加载数据过程中不会对数据进行任何的修改,只是将数据移动到指定的HDFS目录下。

Hive的设计原理

湖南软件职业技术大学

第 11 页

Hive原理及架构

hive的特点如下:

Hive的设计原理

湖南软件职业技术大学

1

支持索引,加快数据查询。

2

3

不同的存储类型,例如,纯文本文件、HBase 中的文件。

3

将元数据保存在关系数据库中,大大减少了在查询过程中执行语义检查的时间。

4

可以直接使用存储在Hadoop 文件系统中的数据。

5

内置大量用户自定义函数(user define function,简称UDF)来对时间、字符串进行操作,支持用户扩展UDF 函数来完成内置函数无法实现的操作。

6

HQL语句最终会被转换为MapReduce任务运行在Hadoop集群之上。

第 12 页

Hive原理及架构

Hive的体系结构

湖南软件职业技术大学

用户接口

用户接口主要有CLI,Client 和 WUI三个。其中最常用的是CLI,Cli启动的时候,会同时启动一个Hive副本。Client是Hive的客户端,用户连接至Hive Server。在启动 Client模式的时候,需要指出Hive Server所在节点,并且在该节点启动Hive Server。 WUI是通过浏览器访问Hive。

Thrift服务器

Thrift服务器是基于socket通讯,支持跨语言。Hive Thrift服务简化了在多编程语言中运行Hive的命令。绑定支持C++,Java,PHP,Python和Ruby语言。

Hive驱动引擎

解释器、编译器、优化器完成HQL查询语句从词法分析、语法分析、编译、优化以及查询计划的生成。生成的查询计划存储在HDFS中,并在随后有MapReduce调用执行。

元数据库

Hive的数据由两部分组成:数据文件和元数据。元数据用于存放Hive库的基础信息,它存储在关系数据库中,如 mysql、derby。元数据包括:数据库信息,表的名字,表的列和分区及其属性,表的属性,表的数据所在目录等。

Hadoop集群

Hive的数据文件存储在HDFS中,大部分的查询由 MapReduce 完成。

第 13 页

Hive原理及架构

Hive的运行机制如图

Hive的运行机制

湖南软件职业技术大学

(1)用户通过用户接口连接hive,编写HQL语句。

(2)Hive解析查询并指定逻辑查询计划。

(3)Hive将查询转换成MapReduce作业。

(4)Hive在Hadoop上执行MapReduce作业。

第 14 页

Hive原理及架构

HQL转换为MapReduce作业的过程

Hive的运行机制

湖南软件职业技术大学

(1)通过开源语法分析器Antlr完成SQL解析,将SQL转化为抽象语法树(AST AbstractSyntaxTree)。

(2)遍历抽象语法树,生成查询的基本组成单元QueryBlock,是一个递归的过程,QueryBlock包括输入源、计算过程、输出,是一个子查询。

(3)遍历OueryBlock,翻译为执行操作树OperatorTree。

(4)对OperatorTree进行优化,如分桶Map端聚合、合并相关的操作、将过滤操作提前。

(5)遍历OperatorTree,翻译为MapReduce任务。

(6)进行物理层优化,生成最终的执行计划。

第 15 页

Hive原理及架构

Hive的基本数据类型

Hive的数据类型

湖南软件职业技术大学

第 16 页

Hive原理及架构

Hive的复杂数据类型

Hive的数据类型

湖南软件职业技术大学

第 17 页

Hive原理及架构

Hive的数据存储

湖南软件职业技术大学

表

Hive的表在逻辑上由存储的数据和描述表中数据形式的相关元数据组成。数据一般存放在HDFS中,但它也可以放在其他任何Hadoop文件系统中,包括本地文件系统或S3。Hive把元数据存放在关系型数据库中,而不是放在HDFS中。在Hive中创建表时,默认情况下Hive负责管理数据。这意味着Hive把数据移入它的“仓库目录”。另外一种选择是创建一个外部表(external table),这会让Hive到仓库目录以外的位置访问数据。

分区(Partition)

Hive把表组织成分区。这是一种根据分区列(如日期)的值对表进行粗略划分的机制。使用分区可以加快数据分片的查询速度。以分区的常用情况为例,如日志文件的每条记录包含一个时间戳。如果我们根据日期来对它进行分区,那么同一天的记录就会被存放在同一个分区中。这样做的优点是:对于限制到某个或者某些特定日期的查询,它们的处理可以变得非常高效。因为它们只需要扫描查询范围内分区中的文件。注意,使用分区并不会影响大范围查询的执行,我们仍然可以查询跨多个分区的整个数据集。

分桶

表或者分区可以进一步分为桶。它会为数据提供额外的结构以获得更高效的查询处理。例如,通过用户ID来划分桶,我们可以在所有用户集合的随机样本上快速计算基于用户的查询。